На этой неделе сразу несколько изданий — Газета.Ru, Lenta.ru, Rozetked — написали, что российские учёные вошли в «топ-1% самых влиятельных учёных мира» по версии Elsevier. Среди шести названных фамилий оказалась и моя, так что меня поздравляли, а я, честно говоря, не мог понять, с чем именно. Почему 1%, если список во всём мире известен как «World’s Top 2% Scientists»? Неужели из всей России туда попали шесть человек, и почти все из Яндекса? И что там вообще считается?
Ну что ж, все данные открыты: список целиком лежит на сайте Elsevier — несколько таблиц Excel по сто мегабайт каждая плюс FAQ. Так что я их скачал и вместе с Claude разобрал. Спойлер: шестью россиянами дело, конечно, не ограничивается, а самое интересное в этих таблицах, конечно, совершенно не про меня.
Что это за список
Список с 2019 года, примерно раз в год, составляет группа Джона Иоаннидиса (того самого, автора знаменитой статьи “Why Most Published Research Findings Are False”, во многом запустившей кризис репликации) вместе с Йеруном Баасом из Elsevier и Кевином Бояком. Нынешняя версия — уже девятая, она построена по снимку базы Scopus на 1 августа 2026 года.
Для каждого автора в Scopus считаются шесть показателей:
— общее число цитирований;
— индекс Хирша;
— так называемый hm-индекс, в котором каждая статья учитывается с весом, обратно пропорциональным числу соавторов;
— цитирования статей, у которых вы единственный автор;
— цитирования статей, где вы единственный или первый автор;
— цитирования статей, где вы единственный, первый или последний автор.
Из них собирается итоговый композитный показатель, c-score:
где максимум берётся по всей базе, так что каждое слагаемое лежит от нуля до единицы, а сумма — от нуля до шести. Логарифм нужен, чтобы сто тысяч цитирований не были в сто раз лучше тысячи. Обратите внимание: числа статей в формуле нет вообще, а четыре слагаемых из шести придуманы специально для того, чтобы бороться с гиперсоавторством. Если вы сто пятидесятый автор статьи коллаборации ATLAS, цитирования этой статьи засчитаются вам в и , с крошечным весом — в , и больше нигде.
Всё это считается в двух вариантах: с самоцитированиями и без . И таблиц две: “карьерная” (все цитирования с 1996 по 2025 год) и “годовая” (только цитирования, полученные в 2025 году).
В список попадают все авторы Scopus, у которых хотя бы пять статей (таких 11,6 миллиона). Их раскладывают по 174 подобластям науки, в список берут тех, кто входит в первые 100 000 по c-score во всём мире, или в 2% лучших в своей подобласти. Получается около 244 тысяч человек в карьерной таблице и около 249 тысяч в годовой — примерно 2,1% от всех авторов.
Так что «топ-2%» — это просто порог входа в список, его проходит каждый, кто там есть. А «топ-1%» из новостей — это уже пресс-служба Яндекса поделила место человека в его подобласти на число авторов в ней.
И действительно, четыре специалиста по AI из пресс-релиза по годовой таблице попадают примерно в верхние две трети процента в своей подобласти, а Сергей Олегович Кузнецов из ВШЭ — в 0,30% по карьерной; ему, кстати, большой привет и поздравления!
Где тут я
Я, как и почти все упомянутые, нахожусь в подобласти Artificial Intelligence & Image Processing. В ней 517 648 авторов с пятью и более статьями, и в список попали чуть меньше одиннадцати тысяч. Вот как выглядит лестница по итогам 2025 года, со знаменитостями для масштаба:
Иначе говоря:
по 2025 году я на 1940-м месте из 517 648 в AI (топ-0,37%) и на 41 284-м месте из 11,6 миллиона по всем наукам сразу (топ-0,36%), то есть в 2025 году прохожу и по второму критерию, в мировую сотню тысяч;
за всю карьеру — 3126-е место в AI (топ-0,6%) и 138 135-е по всем наукам (топ-1,2%);
среди всех российских учёных из годового списка — 106-е место из 989, а среди российских специалистов по AI — третье, после Ивана Оселедца (174-е место в подобласти) и Андрея Савченко из ВШЭ, который обогнал меня ровно на три позиции.
На соседей, конечно, одно удовольствие посмотреть. В годовой таблице рядом со мной оказались: Кишор Папинени, первый автор BLEU (1955-е место), Билл Триггс, соавтор HOG (1953), классик обучения с подкреплением Сатиндер Сингх (1950), Якоб Фёрстер из Оксфорда (1946), Серкан Арик, автор TabNet (1942), Баладжи Лакшминараянан, придумавший глубокие ансамбли (1933), Такуя Акиба, автор Optuna (1928), Шуньюй Яо, автор ReAct и Tree of Thoughts (1925). В нескольких позициях от меня в карьерной таблице — Уитфилд Диффи из протокола Диффи–Хеллмана, Кристофер Ре и Януш Бжозовский, придумавший производные регулярных выражений. Компания отличная, пожалуй, даже чересчур для скромного меня.
Из чего сложилось моё место
Если разложить c-score на слагаемые, можно увидеть, что вытягивают меня наверх в основном две вещи.
Во-первых, общее число цитирований, и здесь, конечно, большое спасибо SPAdes — сборщику геномов из лаборатории Павла Певзнера, к которому я когда-то немного приложил руку и в статье про который я где-то в середине списка.
Во-вторых, цитирования единоличных работ — видимо, в основном книги про синтетические данные и русскоязычных книг. В 2025 году у 55% людей из годового списка AI цитирований единоличных статей за год просто вообще нет, поэтому даже скромные 45 ссылок дают 1130-е место.
И ещё одна приятная деталь: самоцитирования у меня составляют всего 3% за карьеру и 1,9% за 2025 год. Поэтому в таблице без самоцитирований я в 2025 году поднимаюсь со 1940-го места на 1793-е: другие теряют больше.
В общем, если вы хотите в топ-2%, пишите книги и постарайтесь присоседиться к какой-нибудь очень удачной статье.)
Что не так с этим списком
На самом деле, конечно, со списком не всё хорошо, и места в нём трудно принимать полностью всерьёз.
Scopus плохо видит машинное обучение. Значительная часть ML живёт в препринтах на arXiv и на конференциях, которые Scopus индексирует частично или не индексирует вовсе (ICLR, например, там нет). Поэтому Андрей Карпатый в годовом списке на 4743-м месте, ниже меня. Алекс Крижевский, автор AlexNet, за всю карьеру всего на 380 мест выше меня, а Владимир Мних, первый автор DQN, — ниже. Дмитрия Ветрова и Дмитрия Ульянова в списке нет вообще. Всё это гораздо больше говорит о Scopus, чем о ком-то из нас.
Покойные учёные тоже в списке. Лотфи Заде, отец нечёткой логики, умер в 2017 году, но по итогам 2025 года он на пятом месте в AI.
Цитируют не всегда то, что важно. Первое место в AI за 2025 год, выше Бенджио и Хинтона, занимает Сейедали Мирджалили — автор оптимизационных метаэвристик, вдохновлённых серыми волками, китами, мотыльками и много кем ещё. Слышали о таком? Я, если честно, нет, а поиск показывает, что его подходы серьёзно критикуются в сообществе теории оптимизации.
Самоцитирование работает. Около 20-го места в AI по карьерному c-score (не буду уж пальцем конкретно показывать) стоит человек, у которого 75% цитирований — самоцитирования; без них он опускается на 872-е место. Собственно, поэтому в базе и есть параллельные столбцы “без самоцитирований”.
Сами составители, к их чести, обо всём этом прямо пишут в своём FAQ:
Citation metrics have limitations.
Сколько там россиян
Теперь к вопросу, который меня удивил в новостях больше всего: неужели во всём списке всего шесть россиян? Конечно, нет. Шесть человек — это пресс-релиз Яндекса о своих сотрудниках и преподавателях, а Lenta.ru, пересказывая его через телеграм-канал Baza, превратила это в “пять российских учёных”.
На самом деле в карьерной таблице 1133 человека с российской аффилиацией, в годовой — 989, а всего в одной из двух таблиц — около полутора тысяч человек. Много это или мало? Вот сравнение со всеми странами:
Россия на 31-м месте в карьерной таблице и на 36-м в годовой: это 0,46% и 0,40% списка. На миллион жителей получается около семи человек — примерно как в Бразилии и Индии. Для сравнения, в Польше — 43, в Чехии — 52, в Италии — 145, в Швейцарии — почти 400.
Кто лучшие среди российских участников? По карьерной таблице — Руслан Валиев из Уфы (наноструктурные металлы), единственный россиянин в мировой тысяче, дальше Алексей Старобинский и Детлеф Банеманн, немецкий фотохимик, работающий в СПбГУ. А первое место среди “россиян” в годовой таблице (526-е в мире) занимает Цян Ван, специалист по наукам об окружающей среде с аффилиацией СПбГУ в последних статьях, хотя, по данным самой базы, почти все свои статьи он написал из Китая. Таких “россиян”, у которых, по данным самой базы, главная страна всё-таки другая, в карьерной таблице 116.
Граница размыта и в обратную сторону: ещё 850–900 человек из каждой таблицы написали хотя бы 10% своих статей из России, но сейчас числятся в другой стране — больше всего в США (275 человек в карьерной таблице), Германии, Великобритании и Франции. Это и уехавшие, и иностранцы, поработавшие в российских институтах.
По организациям лидирует МГУ (89 человек в карьерной таблице), за ним СПбГУ (45), ФИАН (34), ВШЭ (26), ФТИ имени Иоффе (22) и Сколтех (21).
А в моей родной области AI & Image Processing российских участников всего 20 в карьерной таблице и 16 в годовой. Для сравнения, в годовой таблице из Греции — 79, из Иордании — 84, из Египта — 62, из Польши — 61, из Ирана — 53. Отчасти это всё тот же эффект Scopus, отчасти — то, что сильные российские исследователи ML в последние годы всё чаще работают в индустрии, а иногда и за границей.
Чем занимаются российские учёные из списка
Распределение по наукам любопытное:
Сорок один процент российских участников карьерного списка — физики; в мире доля физиков в списке около 9%. Математиков у нас втрое больше мировой нормы, химиков — вдвое. А клинической медицины, которая в мире составляет почти треть списка, у нас в девять раз меньше; социальных наук — в четырнадцать раз меньше; общественного здравоохранения нет вообще. В годовой таблице медицины и биологии становится заметно больше, но общий портрет тот же: это наука, выросшая из сильной советской школы физики, химии и математики.
Это видно и по возрасту:
Медианный год первой публикации у российских участников карьерного списка — 1981-й, а в мире — 1989-й. 69% россиян из карьерного списка начали публиковаться до 1990 года, а по миру — только 52%.
И последнее наблюдение, которое мне не очень хотелось бы делать, но из песни слов не выкинешь, — самоцитирование:
Медианная доля самоцитирований у российских участников карьерного списка — 27% при мировой медиане 11%, и это первое место с большим отрывом среди всех сорока стран, у которых в списке больше 450 человек.
Можно было бы подумать, что всё дело в физике: в больших коллаборациях самоцитирований объективно много. Поэтому на графике есть и “ожидаемое” значение — та медиана, которая получилась бы, если бы каждый российский учёный самоцитировался как типичный учёный его подобласти. Оно равно 14%, так что разница никуда не девается; самая большая после нас — у Чехии и Польши, и она вдвое меньше нашей. В годовой таблице картина та же: 17% у нас против 8% в мире.
Конечно, тут не надо делать слишком поспешных выводов. Самоцитированием база считает любую ссылку из статьи, где есть хотя бы один общий автор с цитируемой, — то есть в устойчивых научных школах, где одни и те же люди десятилетиями пишут вместе, эта доля будет высокой совершенно естественным образом. Свою роль, вероятно, играет и относительная замкнутость российских журналов, и наукометрические KPI, которые в России много лет вменяют научным организациям. Но факт остаётся фактом: это самая заметная “российская особенность” во всех этих таблицах, и составом наук она не объясняется.
Заключение
В общем, как это часто бывает, журналисты вроде как нигде не соврали, но впечатление создали весьма превратное. Однако попасть в этот список, да ещё и в такой компании, безусловно очень приятно!
Имеет ли это какое-то значение? Скорее нет: на работу вас по этому списку не возьмут, премию не дадут, а Андрей Карпатый от того, что оказался ниже меня, хуже не стал. Но буду считать, что это хороший повод написать ещё одну книгу — в одиночку, разумеется.
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
Мимо новости о том, как AI-модели решили задачу тысячелетия из списка Clay Institute, пройти было сложно. Но очень хотелось, потому что это весьма далёкая от меня математика, и по сути мне сказать здесь особо нечего, а разбирать скандалы о приоритете, кажется, особого смысла нет.
Тем не менее, когда с вопросами пришли журналисты, стало ясно, что не отвертеться. Что ж, попробую объяснить, что произошло, и высказать своё мнение о том, что всё это значит для нас и для математики в целом. План такой: сначала опишу произошедшее так, как я это понимаю, а потом отвечу на прямые вопросы (раз уж они этот пост мотивировали) и в частности выскажу своё личное мнение.
Бонусом появился ещё один раздел: пока я отвечал на вопросы и писал пост, 25 филдсовских лауреатов выпустили обращение по поводу
Что произошло, простыми словами
Задача. Уравнения Навье-Стокса описывают движение вязкой несжимаемой жидкости: второй закон Ньютона для сплошной среды плюс условие несжимаемости. Вопрос тысячелетия не о том, как течёт вода, а о том, может ли модель “сломаться”. Если начать с гладкого течения, останется ли оно гладким навсегда, или скорость в какой-то точке за конечное время может уйти в бесконечность? И может ли скорость уйти в бесконечность сама собой или только под действием хитро настроенной внешней силы? “Задача на миллион”, сформулированная в 2000 году Чарльзом Фефферманом, состоит в том, чтобы доказать, что либо течение без внешней силы останется гладким (утверждения A и B, в бесконечном пространстве и на торе соответственно), либо, наоборот, под воздействием внешней силы можно достичь разрыва (утверждения C и D, тоже в пространстве и на торе).
Что доказали модели OpenAI. Утверждения C и D: для любой вязкости существует такая гладкая сила (с компактным носителем по пространству и времени), что жидкость, стартующая из состояния покоя, за конечное время разгоняется до бесконечной скорости при конечной энергии. Это должен быть вихрь, в котором угловая скорость всё растёт и растёт, до бесконечности. Вот иллюстрация из поста OpenAI:
Отдельно, что прошло менее заметно для прессы, но на самом деле является, возможно, даже более важным результатом, они доказали существование такого разрыва для уравнений Эйлера (это уравнения Навье-Стокса без вязкости) без всякой силы из гладких финитных данных.
Механизм решения. Дисклеймер: здесь я совсем не специалист, пишу как понял, но не исключено, что понял неправильно.
Возьмите любое поле скоростей, подставьте в уравнение, а невязку считайте внешней силой; так можно сделать, и вся трудность получается в том, чтобы поле взрывалось, а невязка при этом была гладкой. Иначе говоря, отдельные члены (ускорение, конвекция, давление, вязкость) должны расти до бесконечности, но при этом должны точно сокращаться друг с другом так, чтобы невязка оставалась гладкой.
Подход, который в итоге привёл к результату, придумали испанские математики Диего Кордоба и Луис Мартинес-Сороа (там несколько статей, сошлюсь просто на страницу Кордобы со списком публикаций). К течению добавляют маленькую высокочастотную поправку, неустойчивость фона раздувает её к моменту взрыва, затем добавляют следующую, на более мелком масштабе, и так до бесконечности, контролируя вклад каждого слоя в силу. Но у них сила получалась не совсем гладкой.
Тристан Бакмастер, один из ведущих специалистов в этой теме, и Лёвент Альпёге, математик и сотрудник Anthropic, который уже не в первый раз с помощью Claude решает великие математические проблемы, с помощью Claude и Codex довели эту идею до гладкой силы для уравнений Эйлера, Буссинеска и пористой среды, а затем в OpenAI получили уже полное решение для уравнений Навье-Стокса.
Здесь важно понимать, что сила — это очень тонко подобранная функция от координат и времени. Жидкость по сути “ведут за руку” к сингулярности; физически с реальной водой так получиться не может, помешает как минимум молекулярная структура, которая не позволит дробить воду до бесконечности.
Статус решения. Оба доказательства формализованы в Lean, то есть каждый шаг уже формально проверен. Остаётся убедиться, что формальная теорема совпадает с формулировкой Феффермана, и как-то переварить 166 страниц препринта OpenAI.
Но до официального признания институтом Клэя в любом случае далеко: его президент Бридсон обещал «неторопливую и абсолютно строгую» оценку, а по правилам нужны публикация, два года проверки и общее признание в сообществе.
Как это делали AI-модели. С 28 августа OpenAI обучает модель сильнее GPT-6 Astra. Первого сентября в OpenAI услышали о новом результате “где-то в Anthropic” и запустили группы агентов на все задачи тысячелетия. Сотня агентов за 12 часов дала результат об уравнениях Эйлера, потом ресурсы перебросили на Навье-Стокса, а лучшие идеи между группами объединяли через Codex. OpenAI пишет, что в результате поучаствовали около 10000 агентов, 2,7 млн сообщений, 130 млрд токенов; ответ был получен 5 сентября, через 88 часов после старта, плюс ещё 17 часов на проверку в Lean. Бакмастер и Альпёге весь год работали вдвоём, за свой счёт, и первое доказательство от модели Бакмастер назвал “самым ужасным, что я читал”, но 22 августа Lean его подтвердил (а получено оно было 15 августа).
Конфликт. Эту часть я излагаю по заявлению Тристана Бакмастера; кажется, нет причин ему не верить, но ниже будут и некоторые оговорки.
3 сентября Бакмастер сам написал в OpenAI из-за слухов о том, что в Anthropic решили (очередную) великую открытую проблему. 6 сентября представитель OpenAI Себастьян Бубек сообщил ему о готовом доказательстве и, по словам Бакмастера, предложил два варианта: либо OpenAI публикуется на день позже, либо Бакмастер один пишет статью обо всём решении задачи об уравнениях Навье-Стокса, с указанием на то, какие шаги были сделаны моделями OpenAI.
Здесь между сторонами произошло недопонимание: по заявлению Бакмастера, условием было исключить из авторов Альпёге, потому что тот в Anthropic. Это выглядит странновато, и Себастьян Бубек это открытым текстом отрицает. Мне кажется, здесь была банальная мискоммуникация: Бубек действительно сказал что-то в духе “было бы проще, если бы Лёвент не был из Anthropic” (это он и сам признаёт), а Бакмастер интерпретировал это как условие вычеркнуть Альпёге из соавторов.
Какие-то “угрозы”, как мне кажется, вообще странно обсуждать: насколько я понял из описаний Бубека и Бакмастера, Себастьян Бубек просто что-то ляпнул не подумавши, тут же взял свои слова обратно, а потом публично подтвердил, что ничего такого не имел в виду, и извинился. Зачем из этого вообще делать какое-то “событие”, совершенно непонятно.
Но как бы то ни было, в результате Бакмастер отказался сотрудничать с OpenAI, и в ночь на 8 сентября выложил это заявление и препринты, а утром вышел релиз OpenAI.
Использование логов сессий Бакмастера в OpenAI. Здесь есть отдельный немного странный сюжет: начались разговоры о том, что OpenAI могли бы использовать работу Бакмастера в Codex как отправную точку для их собственных исследований. OpenAI отрицает доступ к их данным, но «не исключает», что обезличенные данные могли быть использованы в обучении модели:
Мне кажется, OpenAI здесь подстелили слишком много юридической соломки и в итоге сами на этом погорели: весь интернет начал интерпретировать “we cannot rule out” как фактически признание. Я думаю, что на самом деле это значит ровно то, что написано: если Бакмастер не opted out, то его чаты (как и все наши с вами) попадают в датасет для обучения, но это такая микроскопическая иголка в стоге сена, что никакой реальной вероятности того, что они чему-то помогли, по сути нет.
Update: я оставил ранее написанный текст как есть, но спустя несколько дней от OpenAI появилось чёткое утверждение на этот счёт:
Разумеется, оно не убедит скептиков, потому что они изначально предполагают, что OpenAI может лукавить. Но я рад, что оно появилось, и верить ему в целом готов.
По сути, в итоге мы имеем частичное решение от Бакмастера и Альпёге, чей приоритет на него никто не отрицает, и полное решение от OpenAI, чей приоритет на последний шаг к уравнениям Навье-Стокса тоже никто не отрицает. Так что скандал мне здесь кажется, честно говоря, высосанным из пальца; ниже я ещё напишу своё мнение о приоритете, заслугах и премиях.
Но отмечу, что есть ещё один параллельный случай, в котором живому математику кажется, что метод решения GPT слишком уж напоминает его собственный: Андреас Том вёл исследования о несофических группах, общался о них с GPT, и его направление исследований в итоге оказалось тем самым, которое довела до конца Astra. Здесь поля уж слишком узки, чтобы ещё и в этом случае разбираться, но вот подробный пост Тома, который у себя опубликовал не кто-нибудь, а Теренс Тао.
И на всякий случай напишу явно: я считаю, что использовать личные чаты с пользователями для не заявленных в явном виде целей (например, не для глобального дообучения, где это капля в море, а для выделения перспективных направлений для решения конкретного вопроса) было бы плохо, неэтично со стороны OpenAI, даже если это формально легально.
Так делать должно быть нельзя; мне кажется, что прямо сейчас так делать действительно нельзя, и они и не делают. Надеюсь, что не придётся разочаровываться.
Ответы на вопросы
Приведу здесь семь вопросов, которые мне поступили от журналистов (слегка переформулированные), и мои ответы на них; надеюсь, коллеги будут не против, что я выкладываю всё это в блоге. По логике изложения они здесь как раз на месте, и ответ на последний вопрос — отличное заключение.
1. Насколько решения уравнений Навье-Стокса являются резонансными в научном мире?
Резонанс, конечно, огромный и заслуженный, но давайте сначала уточним, что именно произошло. Никто не «решил уравнения Навье-Стокса» в смысле «теперь мы знаем, как течёт вода». Задача тысячелетия — это вопрос о том, могут ли уравнения, описывающие жидкость, «сломаться»: может ли спокойное, гладкое течение за конечное время разогнаться до бесконечной скорости в какой-то точке. Выше я объясняю на пальцах, что именно было доказано.
Это действительно закрывает одну из семи задач тысячелетия, второй раз в истории после доказательства Григорием Перельманом гипотезы Пуанкаре. Доказательство проверено формально в системе Lean, поэтому в корректности результата сомнений почти нет, хотя, конечно, стоит дождаться, пока живые математики всё проверят и осознают.
Но всё же мне кажется, что главный итог и главная сенсация здесь — это не сам результат, а то, как он получен. Сначала за год два математика при помощи языковых моделей прошли путь, на который раньше уходили десятилетия, а потом десять тысяч агентов дошли до конца за четверо суток. Тристан Бакмастер сам назвал это «моментом Deep Blue против Каспарова», и я с ним согласен.
Теперь математику делают именно так, и в последнее время LLM получили (или полностью самостоятельно, или с небольшим руководством со стороны человека) уже много по-настоящему выдающихся математических результатов. Я об этом недавно рассказывал в докладе “Vibemathed” (слайды на странице “Выступления”), и наверняка ещё буду рассказывать в ближайшем будущем. В этом и есть самая главная новость последних нескольких месяцев.
2. OpenAI решила задачу при помощи 10000 агентов. По словам Бакмастера, ключевая идея принадлежит другим учёным, а ИИ-агенты только доработали её. Кто достоин премии в таком случае?
Во-первых, давайте различать премию (пресловутый миллион) и заслугу. Премия института Клэя требует, чтобы решение было опубликовано в рецензируемом журнале, выдержало два года проверки и получило общее признание сообщества. Причём в правилах есть отдельный пункт: институт обязан рассмотреть, не опирается ли решение в своей новизне на ранее опубликованные идеи, и может включить авторов этих идей в число лауреатов.
То есть ответ на вопрос, получит ли премию автор идеи или владелец AI-агентов, правилами уже предусмотрен, и ответ скорее в пользу автора идеи. А OpenAI сама сказала, что претендовать на премию не будет; конкретного живого человека, который мог бы претендовать на серьёзный вклад, со стороны OpenAI нет, а триллионной компании зачем бороться с математиками за какой-то миллион долларов?..
Более интересен вопрос о собственно научных заслугах в этом решении. Идею, из которой выросло решение, несколько лет разрабатывали испанские математики Диего Кордоба и Луис Мартинес-Сороа. Чарльз Фефферман, который эту задачу для института Клэя в своё время формулировал, сказал прямо: главные герои в этой истории именно испанцы. Тристан Бакмастер и Левент Альпёге за год с помощью языковых моделей довели их программу до разрыва для уравнений Эйлера. А OpenAI за 88 часов и с колоссальными вычислительными ресурсами сделала последний шаг до уравнений Навье-Стокса. Все три вклада настоящие, очень важные и, насколько я понимаю, никем не оспариваются.
Для математики такая ситуация не нова. Перельман доказал гипотезу Пуанкаре по программе Гамильтона и сам говорил, что вклад Гамильтона не меньше его собственного. Новое здесь то, что «финишёр» впервые не живой человек; думаю, пока что GPT сам по себе всё-таки на премию не претендует. Так что премию, если её присудят, я бы делил между Кордобой, Мартинес-Сороа, Бакмастером и Альпёге, причём мне кажется, что первые двое здесь важнее, чем последние (но я, повторюсь, вообще не специалист).
3. Бакмастер утверждает, что OpenAI узнала об их наработках и бросила все силы, чтобы их обогнать. Если это подтвердится, это прорыв или промышленный шпионаж?
Здесь есть две разных интерпретации слова “узнала”. Если “узнала” — это “услышала слухи о том, что в Anthropic решили задачу тысячелетия”, то подтверждать ничего не надо, OpenAI это сама признаёт. В их официальном пресс-релизе так и написано: первого сентября мы услышали слух, что две задачи тысячелетия решены, и запустили на них свою систему, а позже поняли, что слух был про Альпёге и Бакмастера. В этом, конечно же, ничего плохого нет; наоборот, замечательно, что и у людей, и у нечеловеческих интеллектов появляется дополнительная мотивация заниматься математикой.
Но Бакмастер намекает на большее: откуда взялся выбор того же самого необычного пути через гладкую внешнюю силу, по которому, по словам Бакмастера, кроме них почти никто не шёл? Эту часть истории я подробно разбираю выше, а здесь просто напишу своё мнение.
Мне кажется, здесь ответ очень простой: если OpenAI действительно использовала в исследовании конкретные логи сессий Бакмастера, это плохо, так делать не надо, даже если это формально не противоречит пользовательскому соглашению. Но, как я уже писал выше, я не верю, что OpenAI на самом деле это делала.
Да и не принципиален этот вопрос по факту: ну давайте представим, что Бакмастер и Альпёге опубликовали статью со своими результатами, а уже потом, через те же 88 часов, OpenAI довела их до полного решения. Что изменилось бы в таком сценарии по сравнению с тем, что есть сейчас? Никто ведь не отрицает приоритет Бакмастера и Альпёге на то, что они получили. В общем, мне не очень понятен этот дискурс.
4. По вашему мнению, мы наблюдаем прорыв в науке или борьбу корпораций?
Совершенно не понимаю в этом вопросе слово “или”. Конечно же, это и то, и другое! Научный прорыв абсолютно настоящий, и работа Бакмастера и Альпёге, и доказательство OpenAI проверены в Lean, у меня почти нет сомнений, что ошибок там нет. А OpenAI, помимо Навье-Стокса, нашла ещё и разрыв для уравнений Эйлера без внешней силы и границ; это тоже важнейшая открытая задача из того же направления.
Борьба корпораций тоже настоящая: заметим, что вся работа OpenAI (по их собственным словам) началась со слуха о том, что конкуренты уже решили важные задачи. Конечно, для компаний это в том числе и гонка за приоритетом и пиаром.
Но главное здесь в том, что мы сейчас наблюдаем фазовый переход в математике в целом. Уже точно можно сказать, что AI-модели стали инструментом, который может доводить до конца целые программы математических исследований. Это меняет науку куда сильнее, чем любой отдельный результат, и социальные механизмы науки — авторство, рецензирование, приоритет и так далее — к этому не готовы.
И здесь я снова без ложной скромности сошлюсь на свой недавний доклад “Vibemathed” (слайды на странице “Выступления”). Задача тысячелетия — это, конечно, громкая новость, но далеко не первая. В последние месяцы AI-модели от OpenAI и Anthropic получили уже много важных и глубоких математических результатов. Очевидно, что наша наука меняется, и сейчас никто не может сказать, как будет выглядеть математика в результате.
5. Можно ли такой подход считать полноценным научным достижением или это просто применение мощного вычислительного инструмента? То есть принципиально ли это меняет подходы в математике или остаётся вспомогательным методом?
Конечно, это полноценное научное достижение! Мы получили доказательство, которого раньше человечество не знало, и более того, доказательство факта, в котором вполне можно было сомневаться (в “задаче тысячелетия”, как мы обсуждали выше, предлагалось доказать один из двух противоположных вариантов). Речь идёт не о компьютерном переборе вариантов, которые придумали и запрограммировали люди, — нет, современные LLM прямо “из коробки” могут заниматься математикой
Это действительно очень важно подчеркнуть ещё раз: какие бы скандалы и сомнения ни окружали это достижение, абсолютно никто не спорит, что окончательный результат об уравнениях Навье-Стокса был получен именно многочисленными агентами OpenAI. Разумеется, они при этом опирались на результаты, полученные ранее людьми (и, возможно, другими LLM-агентами), как всегда в науке. Сейчас идёт спор о том, на какие именно достижения они опирались, а на какие нет, и не получили ли они доступ к некоторым из этих результатов некорректным образом. Но даже в самом “худшем” для LLM-агентов случае никто не спорит, что они самостоятельно провели математическую работу, которая бы несомненно сделала их претендентами на премию института Клэя (скорее всего в соавторстве), будь они людьми.
О том, принципиально ли меняются подходы к математике, ответил в предыдущем вопросе.
6. Стоит ли ожидать теперь решения других «загадок тысячелетия» с помощью нейросетей?
Может быть, а может быть, и нет. Мы же не можем оценить то, насколько сложна та или иная задача, если её ещё никто ни разу не решил. Насколько я могу судить (но могу ошибаться), то, что первыми из задач тысячелетия “упали” именно уравнения Навье-Стокса, было несколько неожиданным для математиков.
Но в любом случае представляется, что LLM-агенты уже прямо сейчас могут самостоятельно вести математические исследования на высочайшем уровне. Про “устойчиво сверхчеловеческий уровень”, наверное, говорить рано, но как знать, долго ли ещё будет рано; пока нет причин думать, что прогресс замедляется…
7. Какие перспективы это открывает, приведёт ли это к тому, что ИИ на самом деле сильно изменит жизнь всех людей или пока рано говорить об этом?
Да, безусловно, искусственный интеллект уже прямо сейчас необратимо изменил жизнь почти всех людей, занимающихся интеллектуальным трудом. Согласитесь, что работа, например, и математиков, и журналистов (раз уж мы с вами обсуждаем этот вопрос) сильно изменилась с появлением современных LLM-агентов. Нет особых сомнений, что до труда не чисто интеллектуального эта революция тоже доберётся, просто в реальном физическом мире исследования и диффузия новых результатов происходят по понятным причинам медленнее.
Будут ли эти изменения апокалиптическими или всего лишь очень серьёзными, покажет только время. Здесь могу порекомендовать поинтересоваться темой безопасности искусственного интеллекта (AI safety), о которой на русском языке, например, я тоже регулярно делаю доклады. Прямо сейчас мы не знаем, как сделать так, чтобы постоянно возрастающие способности AI-агентов не привели к катастрофическим последствиям. Надеюсь, что всё-таки или узнаем в ближайшем будущем, или сможем договориться ограничить развитие этих способностей до тех пор, пока не узнаем.
Обращение филдсовских лауреатов
11 сентября двадцать пять филдсовских лауреатов, включая Пьера Делиня, Станислава Смирнова и Теренса Тао, выпустили краткое обращение под названием “A Severe Misalignment of AI in Mathematics”. Я рекомендую просто прочитать его целиком, оно короткое и сразу переходит к сути дела.
Лично у меня немного странное впечатление от этого письма. Разумеется, филдсовским лауреатам виднее, что такое математика и зачем она нужна, и с первой частью письма спорить невозможно. Действительно, математика зачастую не столько про конкретный результат, сколько про путь к этому результату и то, что люди понимают по дороге. Вряд ли один конкретный бит информации о том, лежат ли нули дзета-функции Римана на критической прямой, что-то даст человечеству в целом или отдельным людям — важен не сам факт, а то, что мы поймём по дороге к этому факту.
Со второй посылкой тоже не поспоришь: действительно, написанные LLM-агентами доказательства часто очень трудно понять. Даже если у AI-доказательства есть проверенная (по условию) формализация в Lean, то есть у нас почти нет сомнений в том, что доказательство верно, дорога до “improved understanding of this landscape” может быть ещё очень длинной. Наличие доказательства — ещё не понимание, человеку всё равно нужно проделать ещё много работы, чтобы к этому пониманию прийти.
Но я не понимаю, как из этих двух посылок следует заключение. Я согласен, что полученное LLM доказательство может помочь людям расширить своё понимание математики, а может в принципе и не помочь. Но как же оно может помешать?..
Например, лауреаты пишут: “At the end of this process [решения сложной математической проблемы], one will ideally find a textbook presentation of the results suitable for any graduate or even undergraduate student to study”. Полностью согласен, как согласен и с тем, что LLM-порождённые доказательства (по крайней мере сейчас) очень далеки от “textbook presentation”.
Но как же может существующее доказательство помешать поиску textbook presentation? Скорее всего, его можно будет понять, упростить и довести до textbook; этот процесс тот же Теренс Тао называл “каноникализацией”. Возможно, его не получится в достаточной мере понять и упростить, и тогда оно не сможет облегчить для людей упоминаемый в цитате процесс. Но сам факт наличия какого-то доказательства никак не может сделать этот процесс сложнее.
Кажется, что между посылками и заключением есть ещё какое-то непроговорённое предположение, причём обсуждать стоит именно его, а не довольно бесспорные вещи, которые написаны в письме. Например: “люди потеряют мотивацию понимать математику, если будут не сами получать результаты, и textbook presentations в итоге так никогда и не возникнут, да и никому не будут нужны”. Возможно, это верно, а возможно, нет — я лично считаю, что это совершенно не обязательно так; могу ошибаться, но в любом случае этот пропущенный шаг выглядит куда более спорным и интересным для дискуссии, чем то, что в письме реально написано. Но тут я бы, конечно, лучше послушал авторов письма, а не додумывал предположения за них.
Единственная часть, где всё понятно и где я согласен без оговорок, — абзац про учеников. “For students we often suggest problems with the core intention of developing skills making them well-positioned for advances in research and elsewhere,” пишут филдсовские лауреаты, и эту систему мотивации действительно придётся как-то менять. Это уже так в любом случае, независимо от того, будут ли AI-модели развиваться дальше. Но это скорее к разговору об AI в образовании; я об этом писал большой пост в июне, давайте отошлю туда, а может, вскоре напишу и ещё.
Заключение
Знаете, что лично для меня было самым интересным во всей этой истории? Не сам результат — я не очень-то могу оценить, что из него следует и что будет на него опираться. Не методы решения — я их всё равно не понимаю, и чтобы понять конструкцию, мне пришлось бы приложить огромное количество усилий с неясным результатом. И уж точно не споры о приоритете, это вообще на фоне самого результата совершенно не важно.
Грубо говоря, это значит, что нынешняя внутренняя модель OpenAI гораздо лучше в математике, чем Astra, которая уже сама по себе решила много известных открытых проблем.
А значит, как я всегда и думал, способности AI-моделей к математике быстро становятся сверхчеловеческими, если ещё не стали, и человеческий уровень никаким содержательным порогом или тем более асимптотой не будет.
А если к математике, то и к AI-исследованиям, это же по сути математика плюс программирование и обработка результатов экспериментов.
А если к AI-исследованиям, то, очевидно, ко всему…
Пост про гипотезу Диница — Гарга — Гёманса я закончил словами “А что ещё дальше, коллеги?..”. Сегодня могу отчитаться, что было дальше: три недели, три препринта, один merged pull request от внешнего контрибьютора и мои первые сабмиты на VibeMathed.
Если коротко, то из твита Дмитрия Рыбина выросла целая исследовательская программа. Сначала мы с моделями опускали планку снизу:
При этом константы наших же контрпримеров из первых двух частей оказались не просто какими-то случайными контрпримерами, а точными значениями для соответствующих классов задач.
Здесь, правда, речь уже не про один гигачад-промпт “you should do a breakthrough”. Это была долгая совместная работа с LLM, с десятками промптов, неудачных попыток, провалившихся экспериментов и так далее. Ошибки тоже регулярно встречались, хотя честно скажу, что хоть я и проверил всё, что происходит в финальном тексте, но лично я не нашёл ни одной дырки — все ошибки, которые были в доказательствах, находились на этапе перекрёстной проверки другими LLM.
Мне кажется, именно так в ближайшие месяцы (а может, и годы) будет выглядеть заметная часть математики, поэтому расскажу всё по порядку — от контрпримеров до теорем, без технических выкладок, но с главными идеями.
Напоминание: гипотеза и треугольник
Кратко напомню постановку задачи; подробности есть в прошлом посте.
Рассмотрим ориентированный граф с источником , терминалами и заказами ; на дугах могут быть неотрицательные цены . Дан дробный поток , который можно делить по путям как угодно. Мы хотим получить неделимый поток : один путь на терминал, так что весь заказ идёт целиком по этому пути. Теорема Диница — Гарга — Гёманса (1999) говорит, что всегда можно добиться на каждой дуге выполнения условия
а гипотеза Гёманса утверждала, что одновременно можно сохранить и цену, .
22 июля 2026 года GPT 5.6 Pro по запросу Дмитрия Рыбина построила контрпример с семью вершинами: любой неделимый поток, укладывающийся в добавку , имеет здесь цену минимум 60 при дробной цене 58.
Мы подробно обсуждали этот пример в прошлом посте. Внутренний механизм этого контрпримера — треугольник попарных конфликтов: три “бесплатных” пути, любые два из которых вместе перегружают какую-то дугу. Дробный поток набирает по бесплатным путям суммарную массу , а неделимый может позволить себе не больше одного бесплатного выбора.
В том же посте мы видели, что параметрическое семейство на той же схеме из 7 вершин доводит нижнюю оценку до любого : если разрешать перегрузку и требовать сохранения цены, то должно выполняться . Сверху же для планарных графов известна константа 2 (Traub, Vargas Koch, Zenklusen, 2023). Так что в начале пути у нас был зазор между и для планарных графов, а для произвольных верхней оценки не было вовсе.
Первый естественный вопрос: может быть, тот же треугольник, но с другими числами, даст больше ?
Это была как раз первая теорема всей серии: — точная верхняя граница для всего шаблона “у каждого из трёх терминалов есть дешёвый и дорогой путь, конфликты попарные”. Ни для каких заказов, долей и цен константу выше на этом механизме не получить. Значит, для более сильной нижней оценки нужен структурно новый пример.
Хребты и терминалы с парой выходов
Новый пример нашёлся в виде, который потом оказался центральным для всей истории. Берём ориентированную цепочку (“хребет” графа) и в каждый терминал отправляем ровно два выхода с хребта: ранний и поздний. Вот пример такого графа:
Значит, к любому терминалу из ровно два пути; назовём их “ранний” (красный на картинке выше) и “поздний” (синий). Переключение терминала с раннего пути на поздний добавляет на дугах хребта, которые лежат в интервале , и получается, что вся комбинаторика такого примера описывается семейством интервалов:
Контрпример из части I был основан на четырёх терминалах с интервалами , , , :
Оптимизация по заказам и долям даёт нижнюю оценку
причём с точным алгебраическим сертификатом. Есть и целочисленное подсемейство с константами , так что всё можно реализовать и на рациональных данных (в целом это и так очевидно). И важно, что конструкция здесь планарная, так что зазор для планарных графов сузился до .
Важная техническая деталь: у каждого терминала в этих конструкциях ровно два простых пути, так что верификацию можно вести буквально полным перебором, и проверяющая программа не может ничего пропустить или забыть. Ту же константу независимо и раньше получил Matthew Protti (23 July 2026); тогда я об этом не знал, но потом во введении Части III расставил все известные мне ссылки.
Число больше , но это не всё, что о нём можно сказать; оно ещё вернётся в этой истории с совершенно другой стороны.
Часть II. Семнадцать терминалов с общим ребром
Естественным продолжением этой работы было бы попробовать обобщить и продолжить действие такого же механизма с попарными переключениями и системами интервалов.
И действительно, обобщить удалось: в Part II мы предъявляем пример, в котором уже сразу 17 терминалов, поздние пути которых все проходят через одно общее ребро.
На этом графе, конечно, чёрт ногу сломит (и очевидно, что он не планарный), но вот соответствующая ему система интервалов со всеми числами. На картинке ниже — это спрос, а — доля дробного потока, которая отправляется на поздний путь; во всех случаях ранний выход к терминалу стоит , а поздний выход бесплатный:
Оптимизация (уже довольно нетривиальная) дала рекорд
Заметим здесь одну закономерность, к которой вернёмся позже: во всех рекордных примерах заказы попарно не делят друг друга и лежат в узкой полосе, внутри одного “двойного окна” , то есть никакое значение не превосходит удвоенного другого. Все семнадцать заказов в рекордном примере укладываются в одно двойное окно. Это не совпадение, и мы ниже объясним, почему так.
В Части II появились и первые верхние оценки: на классе таких вот конструкций (два пути на терминал, пересекающиеся по одному ребру интервалы) метод не может дать оценку больше . Это, конечно, верхняя оценка только на очень конкретный класс графов, то есть ограничение метода, а не какая-то интересная теорема сама по себе.
Потом случилось очень крутое событие, которое меня изрядно вдохновило продолжать. Я выложил репозиторий с сертификатами и верификаторами, и Альфредо де ла Фуэнте (Alfredo De la Fuente) прислал pull request: транспонировать правые концы двух интервалов и переоптимизировать заказы. Его сертификат прошёл все наши проверки, и текущий рекорд теперь community-contributed:
Мне очень понравилось, что задача вызвала интерес у сообщества. На Vibemathed мой пост с этими результатами тоже получил довольно много по меркам этого сайта комментариев. В частности, конечно, меня ткнули носом в том, что Matthew Protti был первым с оценкой, близкой к .)
Лестница рекордов по числу терминалов выглядела так: : , : , : , : , : , : .
Запомните и её — к ней мы тоже вернёмся.
А нельзя ли чего-нибудь доказать?
К этому моменту у константы было уже довольно много нижних оценок и удручающе мало верхних. Хуже того: для общих графов и произвольных заказов было неизвестно, существует ли вообще конечная константа , то есть неизвестно, конечна ли она в принципе. С этого вопроса и началась Часть III.
Вспомним, почему в гипотезу Гёманса верили: доли дробного потока по путям выглядят как вероятности, и независимый выбор путей даёт в среднем и нужные нагрузки, и нужную цену. Контрпример показал, что независимое округление разваливается. Но сам вероятностный язык можно было использовать и дальше.
Вот главный принцип, на котором стоит вся Часть III: раскладываем ошибку на множители, сохраняя среднее. Иначе говоря, мы ищем не один поток (маршрутизацию, routing), а распределение на потоках, у которого
математическое ожидание нагрузок равно дробному потоку в точности, на каждой дуге, и при этом
каждый атом распределения заключён в “ящике”: почти наверное.
Если такое распределение есть, то сохранение цены получается автоматически: средняя цена равна , значит, какой-то атом стоит не дороже. После этого цены рёбер вообще исчезают из задачи, и остаётся чистая “геометрия” (ну, не настоящая геометрия, конечно): какого размера нужен “ящик”, чтобы смог стать точным средним целых маршрутизаций?
Это нехитрая интуиция, и так люди уже думали о потоках. Первым интересным (и, насколько я могу судить, новым) результатом Части III стало то, что это не просто удобный приём, а приём достаточный. Для любого класса графов, замкнутого относительно удаления дуг (а это все естественные классы: планарные, последовательно-параллельные, деревья…), выполняется равенство: оптимальная константа сохранения цены в точности равна минимальному радиусу ящика для точных средних.
Доказательство в обратную сторону здесь состоит в том, что можно построить отделяющую гиперплоскость, а потом сдвинуть потенциалы в духе условий Каруша-Куна-Такера: если дробная точка не лежит в выпуклой оболочке хороших маршрутизаций, то найдётся вектор цен, на котором ломается сохранение цены.
Дальше мы использовали тот же вероятностный язык в двух направлениях: изучали арифметику значений заказов и геометрию взаимодействия путей.
Арифметика: делимость бесплатно, несравнимость нет
В этой науке есть классический результат Skutella (2002): если заказы образуют цепочку делимости (каждый делит следующий), гипотеза Гёманса верна как есть, с константой 1. На языке точных средних это “локальный закон”: внутри цепочки делимости мы можем явно построить нужное распределение.
Часть III превращает это в общий принцип факторизации:
разобьём множество значений заказов на цепочки делимости,
построим распределение в каждой цепочке независимо,
перемножим полученные распределения.
При этом точные средние складываются, радиусы складываются, и каждая цепочка платит один раз своим максимумом. И получается, что
где — максимальное значение одного заказа, а оптимальное покрытие цепочками считается за полиномиальное время через паросочетание максимального веса.
Если быть точным, то результат говорит, что ключевым объектом для нас является разбиение мультимножества заказов (множества терминалов) на цепочки делимости . Мы сможем построить нужный “ящик” радиуса
то есть любой дробный поток будет выпуклой комбинацией “опорных маршрутизаций” (support routings) с точно совпадающим средним и радиусом :
Например, можно разбить заказы на множества по значениям, т.е. если именно как множество, без повторов, и если , то
а значит, в частности, аддитивная константа на этом примере не превышает (константу ещё на максимальное значение заказа нужно разделить).
Рассмотрим маленький пример: пусть у нас заказы . Наивная сумма даёт , но , поэтому покрытие стоит , и . Добавление значения 1 ничего не меняет — единица прицепится к любой цепочке бесплатно. А вот для попарно несравнимых никакое покрытие не побьёт простую сумму.
Именно поэтому в контрпримерах всё время появляются попарно не делящие друг друга заказы в узкой полосе. Теперь это не эмпирическое наблюдение, а теорема о том, где метод работает, а где не очень.
Немедленные следствия:
если значений всего два, , то (это константа Морелла — Скутеллы, теперь доказанная для всех примеров с двумя значениями);
если в каждой диадической полосе не больше одного значения, то (достаточно их все просуммировать как );
если в примере конечное множество значений, то у него будет конечная константа.
Последнее утверждение, конечно, не означает глобальной конечной константы, но все наши контрпримеры в Частях I–II использовали не больше девяти различных значений, так что для всех них можно теперь какую-то общую верхнюю оценку получить (не очень интересную).
Давайте разберём ещё чуть более содержательный пример, чтобы увидеть, как это суммирование оценок работает. Вот он:
Здесь терминал (спрос ) использует общую дугу с весом , терминал (спрос ) с весом , так что нагрузка получается .
В этом примере четыре целочисленных маршрутизации; назовём их 00, 01, 10, 11: первый бит показывает, идёт ли через путь в , а второй — в . И если рассмотреть веса как независимые вероятности, то получатся вероятности как на картинке и ожидание
то есть при таком разложении сохраняется точное среднее. А радиусы просто складываются и получается .
На этом месте хочется, конечно, сказать: а давайте округлим значения заказов вверх до какого-то общего значения или одной цепочки делимостей, разложим увеличенный поток, а потом восстановим изначальные результаты. Но так не работает (это тоже один из результатов): общее разложение не будет знать, какой путь ведёт к какому терминалу, а это будет необходимо для восстановления; не буду вдаваться в детали, но про это у нас тоже есть небольшой раздел.
А вот округление вниз работает, если срезанная часть заказа сначала удаляется из самых дорогих путей. Здесь тоже вдаваться в детали не буду, но, в общем, получается целое семейство оценок, параметризованное основанием и глубиной сетки . Две первые его точки давно известны — это оценки Скутеллы
а дальше кривая продолжается на все , с пределом в чистом сдвиге и полезным следствием для потоков ограниченной нагрузки:
Вся задача свелась к одному окну
Самый концептуальный результат на этом арифметическом пути — редукция слияния (merger reduction). Определим “оконную константу” : наилучшую аддитивную ошибку точного среднего для примеров, все заказы которых лежат в одном “двойном окне” вида . Тогда мы доказали, что
Иными словами, универсальная конечная константа существует тогда и только тогда, когда конечна , и вся общность задачи по сути свелась к вопросу об одном окне значений .
Например, все заказы рекорда с сами лежат в одной такой полосе , и более точное рассуждение о выпуклых оболочках показывает, что этот пример даёт
То есть слить одно окно “почти бесплатно” (с ) невозможно — нижние оценки бьют и по этой цели. Полный точный профиль рекордного потока (все пятнадцать сегментов его релаксированной границы) мы тоже посчитали и выложили:
Геометрия: пары бесплатны, первый враг — треугольник
Теперь вторая ось частичных результатов. На арифметической оси мы ограничивали значения заказов, а граф и взаимодействие путей оставляли произвольными; здесь всё наоборот: заказы любые, но ограничена геометрия взаимодействия путей. Отправная точка — общее свойство всех наших контрпримеров: в них к каждому терминалу ведут ровно два простых пути. Назовём такие примеры двухпутевыми (two-path instances) и посмотрим, во что превращается задача.
Когда путей ровно два, маршрутизация — это просто вектор битов : , если терминал идёт по одному из своих путей (назовём его “поздним”, ), и , если по другому (“раннему”, ). Дробный поток превращается в набор долей : с какой “вероятностью” терминал выбирает поздний путь. А весь граф сворачивается в матрицу разностей маршрутов: положим , если дуга лежит только на позднем пути терминала , , если только на раннем, и , если она лежит на обоих или ни на одном. Смысл этой матрицы в том, что ошибка любой маршрутизации на любой дуге записывается одной формулой:
В хребтовых примерах матрица выглядит совсем наглядно: в строке дуги хребта стоят напротив интервалов, которые её накрывают. Переключение такого терминала на поздний путь добавляет на этой дуге ; строка раннего частного выхода терминала — одинокая , позднего — одинокая . В произвольных направленных ациклических графах знаки внутри одной строки могут смешиваться.
Число ненулевых элементов строки назовём её арностью: это число терминалов, чьё переключение вообще затрагивает данную дугу.
На этом этапе граф можно выбросить, и остаётся чистая комбинаторная задача: по знаковым строкам, заказам и долям найти распределение на булевом кубе, у которого маргиналы в точности равны (это и даёт точное среднее), а ошибки всех строк на всех атомах не превосходят . Интуитивно чем меньше арности строк, тем легче; строки арности 1 тривиальны: их ошибка никогда не превосходит по модулю.
Но есть и неприятный сюрприз: на абстрактном уровне уже пары, то есть строки арности 2, могут стоить больше . Пример из статьи: два терминала с единичными заказами, доли и две строки со знаками и . У первой строки состояние имеет ошибку , так что радиус требует ; у второй за ящик вылезает состояние с ошибкой , то есть нужно ещё и . Вместе с маргиналами это несовместно: обозначив , получаем и , и первое условие требует , а второе — . Лучший достижимый радиус здесь .
Столько же, , даёт и “нечётная дыра” — цикл длины пять из всюду положительных парных строк, главный подозреваемый ещё со времён абстрактного анализа Части I. Если бы такие знаковые узоры реализовывались потоками, ни о какой “бесплатности пар” речи бы не шло.
Первая структурная теорема Части III: они не реализуются. Начнём с самого простого случая: у двухпутевого потока для любой пары терминалов произведение знаков одинаково на всех дугах, где оба сомножителя ненулевые. Доказательство — симпатичная графовая склейка, которую я здесь не буду объяснять в деталях:
На самом деле верно гораздо больше: вся матрица (после удаления нулевых строк) — это сетевая матрица (network matrix), матрица знаковых инциденций путей в некотором дереве, и в частности она вполне унимодулярна. Идея доказательства: в носителе двухпутевого потока в каждую вершину можно прийти из источника не более чем двумя способами — третий способ немедленно дал бы третий путь какому-нибудь терминалу.
Вершины, достижимые одним способом, образуют дерево, а компоненты, достижимые двумя, — это общие “хвосты” пар путей, которые в разности всё равно сокращаются. После некоторых преобразований разность путей каждого терминала превращается в обычный путь между двумя листьями одного общего дерева, а матрицы путей в дереве — это и есть сетевые матрицы.
На теорему о сетевых матрицах можно ещё посмотреть так: для любого двухпутевого примера существует дерево , в котором каждый терминал представлен путём между двумя листьями, а каждая строка матрицы разностей — ребром этого дерева, причём носитель строки (множество терминалов с ненулевым знаком) — это в точности множество путей, проходящих через . То есть словарь: такой: терминалы — пути в дереве, строки — рёбра дерева, арность строки — нагрузка ребра (сколько путей через него идёт).
И можно рассмотреть гиперграф взаимодействия — матрицу , прочитанную по строкам: вершины — терминалы, гиперребро ребра — это . При этом взгляде мы забываем знаки и величины и смотрим лишь на носители строк; к этому гиперграфу мы вернёмся в следующем разделе.
Из теоремы сразу получается и общее правило чётности: если несколько парных строк образуют “чистый цикл” длины , произведение всех их знаков обязано равняться , иначе нашёлся бы минор с определителем . Цикл из примера выше и всюду положительный 5-цикл это правило нарушают.
Теперь можно собрать положительный результат — обещанную бесплатность пар. Пусть все строки имеют арность не выше 2. Посмотрим на одну парную строку, для определённости со знаками , и на четыре угла булева квадрата. Смешанные углы хороши всегда: скажем, в угле ошибка равна и по модулю не превосходит . Плохим может оказаться только угол (сверху) или угол (снизу), причём не оба сразу: их ошибки различаются ровно на .
Числовой пример из статьи: единичные заказы, доли ; ошибки в состояниях равны , , , , и плох только угол . Плохой угол отрезается одним целочисленным неравенством — здесь , — дробная точка ему удовлетворяет, и хорошие вершины дают готовую смесь с точным средним:
Осталось проделать это одновременно по всем строкам: пересечём единичный куб со всеми неравенствами, отрезающими плохие углы. Нормали этих неравенств — строки самой матрицы (с точностью до знака), правые части целые, и вполне унимодулярность гарантирует, что получившийся многогранник целочисленный. Значит, точка долей раскладывается в выпуклую комбинацию его булевых вершин, и каждая такая вершина обходит все запрещённые углы всех строк сразу. Итого получается теорема.
Теорема. У двухпутевого примера, все строки которого имеют арность не выше 2, точный радиус равен ровно — при любой цикличности взаимодействий.
В обозначениях, которые пригодятся ниже: локальная константа арности два . Меньше единицы не бывает уже на одном терминале: если доля одного из путей стремится к нулю, любая смесь с точным средним обязана давать этому пути его положительную массу, и перегрузка соответствующего атома стремится к .
Обратите внимание, как всё это ломает исходную интуицию: казалось, что главная опасность — циклы конфликтов, а оказалось, что циклы попарных конфликтов не стоят вообще ничего. Препятствие надо искать не в цикличности, а в арности.
Итак, первый настоящий враг — строки арности 3. И минимальный живой пример нам давно знаком — “тернарное ядро”, тот самый треугольник: хребет из трёх дуг и три интервала , , , дающие строки , , :
И здесь Часть III доказывает точное значение: локальная константа тройного ядра равна ровно . Не “не меньше”, как в контрпримере, а ровно: верхняя оценка теперь тоже есть, с явным экстремальным семейством решений. Треугольник Рыбина оказался не случайной находкой, а точным локальным экстремумом общей теории.
Дальше — четыре колонки. Существует ровно пять максимальных носителей взаимодействия четырёх терминалов (с точностью до перестановок; эта классификация тоже нетривиальная и тоже доказывается в статье):
Форма 0 — это интервальное ядро Части I, и её точная локальная константа равна
в точности константе нашего контрпримера; остальные четыре формы дают ровно . Доказательство верхней границы для — самое тяжёлое место статьи: 2015 граничных клеток, закрытых вручную выписанными покрытиями, проекциями и одним аргументом типа Хелли, без численных переборов (численный поиск использовался только чтобы найти граничные клетки, ни одно его решение в доказательство не входит).
Его мы, конечно, пропустим, зато теперь можно показать всю лестницу целиком:
Синие квадраты — теоремы с точными оценками: , , . Оранжевые кружки — рекорды из Части II, которые мы теперь считаем гипотетическими следующими ступенями той же лестницы. Пунктир — гипотеза Части II о супремуме для этого класса. Первые две нетривиальные ступени лестницы совпали с константами контрпримеров: нижние оценки Частей I–II, найденные задолго до всей этой теории, оказались точными значениями экстремальных задач, о существовании которых мы тогда не подозревали. По-моему, это крутой сюжетный поворот.
Раскраски, Property B и первый ответ для неограниченного класса
Локальные ядра — это хорошо, но что делать с глобальной системой, где троек много и они переплетены? Здесь помогает классическая комбинаторика.
Строки взаимодействия арности бесплатны (один -ящик). Значит, для системы с арностью достаточно раскрасить терминалы в два цвета так, чтобы ни одна тройная строка не стала одноцветной: внутри каждого цвета арность упадёт до двух, каждый цвет заплатит один -ящик, итого . Здесь мы пользуемся нашим свойством композиции, складывая радиусы частей графа.
И теперь можно вспомнить гиперграфы из предыдущего раздела: их мы как раз и раскрашиваем. Оказывается, свойство “гиперграф двураскрашиваем без одноцветных рёбер” — это классическое Property B (в честь Бернштейна, название Миллера, 1937). Сам я о таких комбинаторных понятиях, разумеется, ни разу не слышал, пока мы с LLM не занялись этой задачей.
В общем случае Property B может не выполняться. Минимальный контрпример арности 3 — плоскость Фано, семь точек и семь прямых.
Но есть и другой факт: плоскость Фано не реализуется путями в дереве. Инцидентности семи путей и семи рёбер дерева не могут образовать Фано — после стягивания всё упирается в диаметр-3 и двойную звезду, и одна прямая должна была бы лежать во всех семи тройках. Классическое препятствие исключается самой геометрией деревьев.
А положительная сторона доказывается через рёберные раскраски: пути в дереве с нагрузкой не выше на ребро можно правильно раскрасить в цветов (это теорема Притчарда — Ротвосса, в основании которой лежит теорема Шеннона о рёберной раскраске мультиграфов). Для берём четыре цвета и сливаем их в два блока и : три пути на одном ребре имеют три разных цвета, значит, ни одна тройка не окажется в одном блоке. Итого:
Теорема. В двухпутевых графах, если арность взаимодействия не превышает 3, то радиус не превышает .
У нас получилась первая конечная константа для класса, в котором ограничена только локальная арность, а всё остальное произвольное: и число терминалов, и цикличность, и значения заказов.
Более того, для произвольной арности тот же приём даёт . Это, опять же, глобальная оценка для класса графов с некоторым ограниченным локальным свойством; кажется, что это естественное свойство в данном случае. Но всё-таки нельзя забывать, что во всём “геометрическом” подходе речь шла исключительно про двухпутевые графы.
Классы графов и новый планарный рекорд
Теперь можно свести результаты о классах графов в единую таблицу:
двухслойные “хабы” (источник — склады — клиенты): , это известный результат; а мы ещё подпёрли его нижней границей , которую получили из классического семейства “m+1 работ”;
внешнепланарные двухвыходные интервальные хребты: ровно, и константа 1 здесь достигается уже одним терминалом.
А для планарных графов мы подняли нижнюю оценку. Построили новый интервальный пример с шестью терминалами, полным перебором маршрутизаций, точной смесью из семи атомов и сертификатом планарности через систему вращений:
У него
и мы знаем классическую верхнюю оценку 2. Забавно, что дальше по лестнице рекордов планарность немедленно заканчивается: уже пятитерминальная рекордная геометрия непланарна.
Как проверяли и как шёл процесс
Стандарт проверки во всех работах был один и тот же: каждое числовое утверждение проверяется в точной рациональной арифметике программой, которая пересобирает пример из списка дуг: заново находит все простые пути поиском в глубину, заново перечисляет маршрутизации, заново решает задачи линейного программирования. У каждого сертификата есть вторая, независимо написанная реализация проверки. Финальные доказательства классов и локальных констант все solver-free, то есть численный поиск разрешён только на стадии открытия новых примеров, и ни одно решение солвера не входит в доказательство как посылка. Все 37 новых сертификатов Части III лежат в репозитории, и приложение статьи объясняет по пунктам, что именно проверяет каждый файл.
И об ошибках, потому что они тоже были, и это нормально. За время проекта adversarial-проверки (вторая модель против первой, кампания против теоретика) поймали довольно много ошибок, в том числе “тождество” , которое при внимательном взгляде оказалось одним и тем же неравенством, записанным дважды; красивое “следствие” про нечётные дыры, опровергнутое затем теоремой о сетевых матрицах; целое доказательство через округление вверх, и много чего другого.
В общем, доказательства от LLM безусловно нужно проверять, но конкретно в этом исследовании оказалось достаточно проверять их другой LLM: Claude ловил ошибки GPT и наоборот, и после пары таких раундов я уже никаких ошибок больше не находил (но всё равно искал! это важно!).
Теперь о процессе, потому что вопрос “как вы работаете с моделями” мне задают чаще, чем вопросы о потоках.
Работали три модели в разных ролях. GPT 5.6 Sol гоняла экспериментальные “кампании”: я (вместе с Claude) писал подробный бриф — какие гипотезы проверить, какие сертификаты сгенерировать, в каком формате отчитаться, — а Sol возвращалась с результатами, часто неожиданными. Claude Fable 5 и Claude Opus 5 занимались теорией, проверкой и текстом: верифицировали каждый раунд, доказывали, что доказывается вручную, ловили ошибки (свои, мои и чужие) и собирали статью.
Таких циклов “кампания — верификация — теория — новый бриф” было примерно восемь. Ключевые идеи — точные средние, сетевые матрицы, редукция к окну, четырёхцветное слияние — в основном предлагали модели; я выбирал направления, закрывал тупиковые ветви исследований, лично перепроверил и переписал все доказательства и, разумеется, несу ответственность за все оставшиеся ошибки.
В отличие от истории Рыбина, это не был one-shot tour de force; это был именно длинный совместный проект, и, кстати, чертовски интересный! Присоединяйтесь!
Что осталось открытым
Разумеется, мы не вполне всё закончили.
Существует ли конечная универсальная ? Главный вопрос стоит как стоял, но теперь он эквивалентен конечности оконной константы , и известно, что .
Гипотеза : лестница рекордов двухпутевого класса, кажется, стремится к ; доказать (или опровергнуть) сходимость — самая близкая открытая цель.
Планарные графы: теперь , и обе границы выглядят улучшаемыми.
и дальше: совпадут ли следующие ступени лестницы рекордов с точными локальными константами, как это случилось с и ?
Заключение
Месяц назад эта история начиналась с семи вершин и твита. Сейчас у неё три препринта, большая таблица рекордов с внешними контрибьюторами, репозиторий с машинно-проверяемыми сертификатами и ряд интересных верхних оценок для разных классов графов, причём константы контрпримеров оказались точными значениями в новой теории.
В постах про двойное покрытие циклами, якобиан и Диница — Гарга — Гёманса я писал про молниеносные результаты: одна гипотеза — один промпт — один документ. Этот пост — про другой, более прозаический и наверняка куда более массовый жанр: LLM как полноценные соавторы в долгом проекте, с разделением ролей, взаимной проверкой и накоплением результатов.
А что дальше, коллеги?
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
22 июля Дмитрий Рыбин написал в X, что GPT 5.6 Pro опровергла гипотезу Диница — Гарга — Гёманса (Dinitz–Garg–Goemans conjecture) из теории потоков в графах. Гипотеза простояла с конца 1990-х; в статье 2025 года Swamy et al. всё ещё называли её “a famous conjecture” и писали, что даже существенно ослабленный вариант был бы прорывом.
Как и в случае проблемы якобиана, здесь пока нет ни журнальной статьи, ни формального рецензирования, но они и не нужны, потому что проверить контрпример очень легко. У нас есть пост Рыбина, выложенный им полный диалог с моделью и четырёхстраничный арифметический сертификат, но в графе всего семь вершин, девять дуг и восемь возможных неделимых потоков. Мы с GPT независимо проверили все восемь программой, которая перебирает буквально все пути в графе, и никаких ошибок здесь нет.
Более того, контрпример оказался не просто верным, а очень интересно устроенным. Внутри него прячется известный в комбинаторной оптимизации объект — треугольник попарных конфликтов.
Давайте разберёмся, что такое делимые и неделимые потоки и в чём состояла гипотеза. Потом обсудим, почему она казалась естественной и почему её было так трудно доказать. Затем проверим контрпример, вытащим из него структурную идею и попробуем его уменьшить. А в конце, разумеется, посмотрим на промпты. Спойлер: там буквально написано “you should do a breakthrough”.
Потоки, которые можно и нельзя делить
Начнём с обычной транспортной сети. Есть ориентированный граф : вершины — перекрёстки или маршрутизаторы, дуги — дороги или каналы связи. У нас есть один общий источник , например склад, и несколько терминалов , куда надо доставить грузы объёмов .
У каждой дуги есть пропускная способность: больше этого количества груза одновременно по ней отправлять нельзя. Может быть и неотрицательная цена за перевозку одной единицы груза.
В более простой постановке задачи грузы можно делить, то есть, например, заказ объёма 10 разрешается разрезать на части: пять единиц поехали по одному пути, три по другому, две по третьему. Такой поток называется делимым или дробным (splittable, fractional flow). В каждой внутренней вершине выполняется закон сохранения: сколько потока вошло, столько и вышло; источник выпускает сумму всех заказов, а терминал поглощает ровно .
С дробными потоками работать легко и приятно, их можно искать линейным программированием, а для классического максимального потока есть ещё более быстрые специализированные алгоритмы.
Но во многих задачах груз делить нельзя. Контейнер должен ехать целиком, сетевое соединение должно выбрать один маршрут, задачу на вычислительном кластере нельзя на 37% выполнить на одном сервере и на 63% на другом. Тогда для каждого терминала надо выбрать один путь из в и отправить по нему все единиц. Это неделимый поток (unsplittable flow).
Если через дугу проходят пути терминалов из множества , нагрузка на неё равна
А полная стоимость маршрутизации равна
Очевидно, что разница между двумя постановками есть, и немалая. Представьте один заказ объёма 10 и две дороги, по которым дробный поток отправляет по пять единиц. После запрета деления придётся выбрать одну дорогу и положить на неё все десять. Нагрузка на выбранную дорогу вырастет скачком на пять.
Такое неизбежно происходит и в общем случае. Поэтому разумный вопрос здесь в том, насколько сильно придётся перегружать дуги. Обозначим максимальный размер заказа (demand, ещё переводят как “потребность” или “запрос”) через
Запас в один максимальный заказ выглядит естественно: если в процессе округления на дуге оказался один целый груз, хуже он добавить не может. Именно это наблюдение превратилось в нашу сегодняшнюю гипотезу.
Теорема Диница — Гарга — Гёманса
Задачу о неделимом потоке из одного источника ввёл Джон Клейнберг в работе 1996 года. Даже решить, существует ли неделимая маршрутизация, соблюдающая все ёмкости, NP-трудно; как отмечают авторы современного обзора, уже на графе из двух вершин с параллельными дугами сюда сводятся Subset Sum и Bin Packing.
Теорема (Dinitz–Garg–Goemans, 1999).Пусть — любой допустимый дробный поток. Тогда за полиномиальное время можно найти неделимый поток , для которого на каждой дуге
Если исходный поток соблюдает ёмкости, , то, следовательно,
То есть округлить можно всегда, и ни одна дуга не получит больше одного максимального заказа сверх исходной нагрузки. Причём порядок величины здесь улучшить нельзя: даже один груз, дробно размазанный по многим путям, при переходе к неделимым потокам целиком ляжет на один из них.
Это верная и интересная теорема, но она про частный случай нашей задачи, без стоимостей дуг. Вскоре Гёманс предложил естественное усиление.
Гипотеза Гёманса.Если на дугах заданы неотрицательные цены , то неделимый поток можно выбрать так, чтобы одновременно не слишком перегружались дуги,
и не увеличивалась общая цена,
Иногда её называют гипотезой Диница — Гарга — Гёманса по имени исходной теоремы, а иногда просто Goemans’ conjecture; важно, что теорема трёх авторов без стоимостей остаётся в силе, опровергнуто именно стоимостное усиление.
Почему в гипотезу верили и почему она была сложной
У гипотезы была очень убедительная вероятностная интуиция.
Разложим дробный поток каждого терминала по путям. Долю потока на пути можно воспринимать как вероятность выбрать этот путь целиком. Если независимо выбрать по одному пути для каждого терминала, то в среднем нагрузка на каждой дуге будет ровно , а средняя стоимость — ровно .
Значит, среди всех исходов точно есть хотя бы один со стоимостью не выше средней. С другой стороны, теорема Диница — Гарга — Гёманса гарантирует, что есть исход, в котором все нагрузки не превосходят .
Очень хочется поверить, что округление можно организовать так, чтобы эти два хороших свойства встретились в одном исходе.
Конечно, здесь нет формального доказательства: из “существует дешёвый поток” и “существует поток без большой перегрузки” не следует, что существует поток одновременно дешёвый и без большой перегрузки. Именно так устроен новый контрпример.
Но до него эта надежда выглядела вполне разумной. Многие классические методы зависимого округления умеют сохранять линейную целевую функцию и одновременно контролировать ошибки в ограничениях. Для специальных случаев получались положительные результаты: например, Skutella (2002) доказал гипотезу, когда все заказы кратны друг другу, точнее, образуют цепочку делимости (см. также Morell, Skutella, 2022).
При этом прогресса в общем случае почти не было. В 2023 году Traub, Koch, Zenklusen писали, что не известно практически ни одного нетривиального класса графов, где точная гипотеза была бы доказана. Они получили важный результат для планарных графов, но только с вдвое большим запасом:
Даже в работе октября 2025 года вопрос, можно ли сохранять стоимость хотя бы с добавочной перегрузкой в общих графах, назывался “широко открытым”, а его решение — потенциальным прорывом. Я нашёл только один (совсем недавний, 29 июня 2026!) результат Almoghrabi, Skutella & Warode, где гипотеза Гёманса доказывается для нетривиального класса: последовательно-параллельных ориентированных графов, причём даже в более общей многоисточниковой постановке.
Почему это вообще так сложно? Потому что дробный поток живёт в выпуклом многограннике и оптимизируется линейными методами, а неделимый поток — это дискретный выбор целого пути для каждого терминала. Один выбор меняет нагрузки сразу на всех дугах пути; разные терминалы связываются через длинные общие куски маршрутов, а ограничение в не даёт усреднить ошибку по размеру графа. Надо одновременно попасть в тонкую полосу вокруг по каждой дуге и не испортить одну глобальную цену.
Может показаться, что контрпример давно можно было бы найти прямым перебором, но на самом деле пространство возможных контрпримеров здесь тоже огромное. Надо выбрать не только граф, но и терминалы, заказы, дробное разложение и цены. Прямой перебор плохо масштабируется, потому что даже у маленького графа слишком много числовых степеней свободы.
Рыбин пишет, что сам неделями думал об этой задаче в обе стороны и что о ней, по его мнению, задумывалось большинство специалистов по потокам.
Тем любопытнее, что итоговый контрпример можно нарисовать на салфетке.
Семь вершин и девять дуг
Вот весь граф. Число на дуге — нагрузка дробного потока, — цена одной единицы; у непомеченных цен значение нулевое. Двойными кружками отмечены терминалы.
Заказы трёх терминалов равны
поэтому .
Сначала проверим, что нарисованные числа действительно задают дробный поток. Из источника выходит
В трёх внутренних вершинах поток сохраняется:
Наконец, в терминалы приходит ровно столько, сколько требуется:
Стоимость положительна только на трёх оранжевых дугах:
Можно посмотреть на тот же поток отдельно для каждого терминала. У каждого груза есть ровно два пути — дорогой и бесплатный :
Обратите внимание, что тоже проходит по бесплатной дуге , но платит на дуге .
Дробный поток раскладывается так:
Каждый дорогой путь, если отправить по нему соответствующий груз целиком, стоит ровно 30:
Поэтому стоимость 58 можно пересчитать ещё одним способом:
А теперь запретим делить грузы. Для каждого терминала надо выбрать либо , либо . Всего получается вариантов. И 58 превращается в 60 из-за трёх арифметических конфликтов.
Конфликт и . Если второй и третий грузы одновременно идут по бесплатным путям, на дугу ложится
Но гипотеза разрешает там не больше
Перегрузка — одна единица.
Конфликт и . Эти два пути вместе дают на дуге
Снова не хватает ровно одной единицы.
Конфликт и . Тут надо вспомнить, что третий груз проходит по дуге на обоих своих путях, и дорогом, и бесплатном. Поэтому вместе с и нагрузка на неизбежно равна
И опять разность равна единице.
Итак, любые два бесплатных пути несовместимы с ограничениями гипотезы. Значит, бесплатно может поехать не больше одного груза, а как минимум два обязаны выбрать дорогие пути. Каждый стоит 30, поэтому вся допустимая неделимая маршрутизация стоит не меньше
Вот и всё опровержение.
Для полноты выпишем все восемь вариантов. Слово bad означает, что после разрешённой добавки какая-то дуга всё равно перегружена:
E1 E2 E3   cost 90   good
E1 E2 Z3   cost 60   good
E1 Z2 E3   cost 60   good
Z1 E2 E3   cost 60   good
E1 Z2 Z3   cost 30   bad: v→w by 1
Z1 E2 Z3   cost 30   bad: u→v by 1
Z1 Z2 E3   cost 30   bad: s→u by 1
Z1 Z2 Z3   cost  0   bad: s→u by 1, u→v by 11, v→w by 1
Все четыре маршрутизации стоимостью меньше 60 нарушают ограничения, а все четыре, которые ограничения соблюдают, стоят 60 или 90.
Я уже два раза написал разными словами одно и то же простое рассуждение, чтобы подчеркнуть, что как и в случае проблемы якобиана, проверка здесь вообще не представляет никакого труда, так что ждать рецензирования смысла нет.
Кстати, граф не только ацикличен, но и планарен. Если забыть направления и разгладить три вершины степени 2, получится вообще , полный граф на четырёх вершинах. Это тоже по-своему интересно, потому что по планарности могла бы проходить граница между верным и неверным утверждением, и Рыбин изначально просил найти контрпример для общего, непланарного случая, но GPT 5.6 в итоге нашёл и более сильный.
Всё это, разумеется, не противоречит планарному результату 2023 года. Там разрешён зазор , а не , и при таком запасе в нашем примере можно отправить все три груза по бесплатным путям и получить стоимость ноль.
Что там происходит на самом деле
Теперь выкинем почти все детали графа и оставим его комбинаторный скелет.
Введём переменную , равную 1, если терминал выбирает бесплатный путь , и 0, если дорогой . Три конфликта говорят:
Для нулей и единиц отсюда следует
Это многогранник стабильных множеств треугольника: можно выбрать не больше одной вершины, потому что каждая пара соединена конфликтным ребром.
А какие значения соответствуют дробному потоку? Это доли грузов, отправленные по бесплатным путям:
Каждое попарное неравенство выполнено. Но сумма равна
Из-за этого неравенства и ломается гипотеза. Дробный поток живёт в обычной релаксации, где есть три попарных конфликта, но не видна их общая “треугольная” связь. Неделимая маршрутизация обязана удовлетворять более сильному неравенству суммы.
А цены на дугах — просто разделяющая гиперплоскость. Поскольку каждый дорогой выбор стоит 30, стоимость равна
У дробной точки получается 58, а у любой целой точки с — не меньше 60.
В таком виде контрпример уже не кажется случайным. GPT 5.6 не просто наткнулся на девять удачных чисел, а реализовал в маленьком ориентированном графе классический разрыв между дробным и целым многогранниками для треугольника.
Это заодно объясняет, почему двух терминалов для этого механизма недостаточно. У одного конфликтного ребра неравенство уже полностью описывает выпуклую оболочку допустимых точек. Первое недостающее ограничение возникает именно на треугольнике, то есть нужны три бесплатных варианта. Я не утверждаю, что семь вершин абсолютно минимальны среди всех мыслимых контрпримеров (для этого нужен отдельный перебор топологий, и его ещё никто вроде бы не сделал), но структурное ядро здесь действительно самое маленькое возможное.
Проверка, уменьшение контрпримера и граница
Проверка. Главная опасность в проверке подобных конструкций — перебрать только заранее задуманные пути и забыть, что их куски можно склеить в новый маршрут. Судя по опубликованному диалогу, несколько ранних попыток GPT 5.6 именно на этом и сломались.
Поэтому в проверочном скрипте мы с тем же GPT 5.6 не задавали шесть путей руками, а перебирали все простые пути из в каждый терминал. Впрочем, здесь всё-таки негде ошибиться, получится именно шесть путей:
После этого декартово произведение трёх двухэлементных списков даёт восемь маршрутизаций из таблицы выше.
Можно ли уменьшить числа? Да. На последней странице сертификата выписано целое параметрическое семейство. Я перебрал его рациональные и целочисленные варианты и нашёл меньший целочисленный экземпляр на том же графе:
заказы , так что ;
по бесплатным путям дробно идут единицы;
единичные цены трёх платных дуг равны .
Тогда каждый дорогой путь целиком стоит 63, дробная стоимость равна
а любая допустимая неделимая маршрутизация стоит хотя бы
Три попарных конфликта снова превышают разрешённую границу ровно на единицу. В этой же семивершинной схеме, если требовать целые заказы и нагрузки и уравнять полную цену трёх дорогих выборов, минимально; перебор меньших значений не даёт ни одного варианта, а при 9 решение единственно.
Исходные числа 58 и 60 для рассказа всё равно красивее, поэтому главным примером я оставил их. Но уменьшенный вариант даёт ещё один результат.
Рассмотрим ослабленную гипотезу, где разрешается
В исходном примере любая маршрутизация стоимостью не больше 58 должна выбрать хотя бы два бесплатных пути. Для каждого такого выбора на конфликтной дуге нагрузка превосходит на 16, то есть требуется
В уменьшенном примере требуется уже
А параметрическое семейство позволяет подойти ещё ближе к . Нормируем первый и третий заказы к 1, снова уравняем полную стоимость трёх дорогих путей и положим
где — доли трёх грузов на бесплатных путях. Их суммарная дробная масса равна . Если каждый дорогой путь целиком стоит , дробная стоимость равна , поэтому сохраняющая стоимость маршрутизация обязана выбрать хотя бы два бесплатных пути. В то же время любой такой выбор требует коэффициента
Беря положительное рациональное сколь угодно малым, получаем контрпример для любого универсального коэффициента .
Иными словами, для планарных графов естественный вопрос теперь звучит так: какой будет оптимальный “коэффициент невязки” между и 2? Верхняя граница 2 известна из работы 2023 года, нижняя получается уже из этой маленькой планарной конструкции.
Для общих графов картина ещё менее понятна: неизвестно даже, достаточно ли вообще какой-нибудь универсальной константы при с одновременным сохранением стоимости. Так что хоть исходная гипотеза и пала, работа здесь ещё не вполне закончена.
Четыре промпта
Ну и наконец — как это было найдено.
Публичный диалог с GPT 5.6 Pro совершенно не похож на тщательно спроектированный исследовательский промпт. Рыбин приложил материалы о задаче и попросил построить структурный контрпример для общего случая, добавив бессмертную фразу:
You should do a breakthrough.
Модель долго исследовала разные конструкции, выдавала частичные результаты и несколько раз не доходила до корректного ответа. Рыбин отвечал коротко и не пытался даже разобраться в том, что модель писала, по существу. После “Research conclusion” идут несколько страниц текста, но дальше диалог продолжается так:
Двух промптов не хватило, и GPT 5.6 опять сдался (через полтора часа размышлений), но третий промпт всё ещё прямолинеен:
И даже трёх промптов и пяти часов размышлений — о ужас! — не хватило. Так что Дмитрий Рыбин потерял терпение и написал коротко и прямо:
Как видите, на четвёртый раз невод, pardon the pun, пришёл с золотою рыбкой. Всего четыре коротких сообщения, никакого “искусства промптинга”. Опять же, я так
Разумеется, из этого не следует, что математическая экспертиза больше не нужна. Чтобы вообще выбрать эту гипотезу, надо знать, что она важна и открыта и иметь некоторую интуицию о том, что именно она может оказаться неверной. Дмитрий Рыбин действительно много думал над задачей сам.
Но и преуменьшать роль модели здесь странно. Человек не подсказывал LLM граф, числа или даже идею треугольника конфликтов. Финальная конструкция появилась после нескольких часов самостоятельного поиска, а пользовательская обратная связь состояла из “продолжай” и “хватит частичных результатов”.
Заключение
Итак, гипотеза Диница — Гарга — Гёманса утверждала, что любой дробный поток можно округлить до неделимого, одновременно сохранив стоимость и увеличив нагрузку каждой дуги не более чем на один максимальный заказ.
GPT 5.6 Pro нашла планарный ациклический граф с тремя терминалами, где дробный поток стоит 58, а любой неделимый поток в разрешённых границах стоит не меньше 60. Сертификат состоит из девяти дуг и восьми строк полного перебора; я независимо проверил и арифметику, и отсутствие дополнительных путей.
Главная идея контрпримера — не сами числа, а треугольник конфликтов. Дробный поток использует три бесплатных выбора с суммарной массой , хотя целиком можно выбрать не больше одного. Цены лишь переводят недостающее неравенство в разрыв между 58 и 60.
Теорема Диница, Гарга и Гёманса без стоимостей остаётся верна. Планарный результат с запасом тоже остаётся верен. И теперь появляется некоторый зазор, который можно пытаться сокращать: как мы тут увидели, та же конструкция показывает, что любой новый универсальный коэффициент должен быть не меньше , то есть теперь можно сокращать расстояние между и .
У меня нет сомнений, что если бы любой из этих результатов получил человек, он стал бы широко известен в узких кругах и всегда имел бы гарантированную профессорскую позицию в хорошем месте, даже если бы больше ничего великого не сделал и продолжал бы всю жизнь изучать следствия и расширения своего прорывного результата (таких примеров в науке много, это не что-то плохое). Так что вопрос о том, достигли ли AI-модели человеческого уровня в математике, кажется мне уже закрытым.
А что ещё дальше, коллеги?..
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
В прошлый раз я закончил пост словами: “Если у вас есть любимая гипотеза, в которую вы верите, самое время написать про неё хороший промпт”. Что ж, люди так и сделали, и сегодня у нас третий эпизод того же сериала.
На этот раз отличилась модель от Anthropic: 19 июля, пока человечество смотрело финал чемпионата мира по футболу, Claude Fable 5 построил контрпример к проблеме якобиана (Jacobian conjecture) — одной из самых знаменитых открытых проблем алгебраической геометрии, номеру 16 в списке Смейла, простоявшей с 1939 года.
Если в прошлых сериях мы обсуждали хотя бы двухстраничные препринты, то здесь научная коммуникация стала ещё ближе к сингулярности; весь результат целиком существует в виде твита математика Левента Алпёге (Levent Alpöge):
И в общем-то этим твитом всё сказано, дальше можно не читать, а пойти проверить (ниже будет код на десять строк). Но я, конечно, не могу этим ограничиться, так что кое-какой контекст вам всё-таки расскажу. Тем более что это (опять!) тот редкий случай, когда про решение знаменитой проблемы можно рассказать всё до последней формулы.
Что такое проблема якобиана
Пусть — полиномиальное отображение: каждая компонента — многочлен от . Его якобиан — определитель матрицы частных производных
Если обратимо, причём обратное отображение тоже полиномиально, то по формуле дифференцирования композиции , то есть якобиан — многочлен, обратимый в кольце многочленов, а значит, ненулевая константа. Гипотеза о якобиане утверждает, что верно и обратное:
Гипотеза (Keller, 1939).Если — ненулевая константа, то обратимо (и обратное отображение автоматически полиномиально).
Отт-Генрих Келлер сформулировал её в 1939 году (изначально для многочленов с целыми коэффициентами); с тех пор она стала, пожалуй, главным открытым вопросом о многочленах от нескольких переменных, который можно рассказать любому студенту.
Есть два класса примеров, на которых гипотеза очевидно работает:
линейные отображения (якобиан — определитель числовой матрицы) и
“треугольные” отображения вида — тут якобиан равен 1, а обратное выписывается сразу как .
Композиции таких отображений дают массу нелинейных примеров с константным якобианом, и все они обратимы. Гипотеза, по сути, говорила, что ничего другого и не бывает.
Почему люди в неё верили? Во-первых, условие означает, что — локальный диффеоморфизм в каждой точке: теорема об обратной функции даёт обратимость в окрестности любой точки, и вопрос только в том, склеиваются ли локальные обратные в глобальное.
Во-вторых, в размерности 1 всё тривиально: означает, что линейна.
В-третьих, давно известно, что вся проблема только в инъективности: по теореме Акса–Гротендика инъективное полиномиальное отображение автоматически сюръективно. Более того, его обратное обязательно будет полиномиальным; это называется теоремой Бялыницкого-Бирули — Розенлихта.
Упомянутые выше результаты я вам с ходу не объясню, но для нас сейчас они значат, что контрпример — это обязательно отображение с константным якобианом, склеивающее какие-то две точки (нарушающее инъективность).
Стоит сразу оговориться, что над полями положительной характеристики гипотеза неверна тривиальным образом: у отображения над производная равна 1, но оно склеивает в ноль всё простое подполе. Так что это вопрос исключительно про характеристику 0 (вещественные числа, комплексные числа), и у гипотезы не может быть никакого доказательства “грубой алгебраической силой”.
Предыдущие попытки и частичные результаты
Фабрика ложных доказательств. Отдельный жанр — история попыток. Гипотеза якобиана, конечно, была не так популярна, как великая теорема Ферма, но к 1982 году Басс, Коннелл и Райт в классическом обзоре насчитывали в литературе не менее пяти опубликованных ошибочных доказательств. И это именно в литературе, то есть прошедших рецензирование.
Среди отметившихся принято называть вполне серьёзных математиков — например, Бениамино Сегре и Вольфганга Грёбнера (того самого, в честь которого названы базисы Грёбнера, к которым мы ещё вернёмся ниже). В 2004 году Мел Хохстер анонсировал доказательство двумерного случая, найденное Кэролин Дин, — и в нём тоже вскоре обнаружилась ошибка. Ну а в эпоху arXiv “доказательства” гипотезы о якобиане (в обе стороны, разумеется) выходили практически ежегодно.
Об уровне задачи говорит, например, то, что диссертация Итана Чжана (Yitang Zhang), который потом совершил прорыв в задаче об ограниченных промежутках между простыми числами, была посвящена именно гипотезе о якобиане.
Что уже было действительно доказано.Wang (1980) доказал гипотезу для отображений степени 2 в любой размерности. Moh (1983) — для и степени до 100 включительно. Ягжев (1980) и Bass, Connell, Wright (1982) показали интересную редукцию степени: достаточно доказать гипотезу для отображений вида , где — однородное кубическое, правда, ценой роста размерности. Позже Дружковский (1983) сузил ещё сильнее, до с линейными .
Был и предупредительный выстрел. В 1994 году Сергей Пинчук построил знаменитый контрпример к вещественной версии: полиномиальное отображение , у которого якобиан не обращается в ноль нигде, но которое не инъективно. У Пинчука якобиан не был константой (он всюду положителен, но принимает сколь угодно малые значения), так что комплексную гипотезу это не опровергало. Но при этом стало окончательно ясно, что “локальная обратимость всюду” глобальную не гарантирует, и закрылись многие возможные пути для доказательства гипотезы.
И ещё стоит отметить, что размерность 2 в этой науке — особая: там автоморфизмы полиномиального кольца устроены просто (теорема Юнга – ван дер Кулка), и гипотеза о якобиане там проверена до степени 100. А вот в размерности 3 регулярно ломается всё, что можно: например, автоморфизм Нагаты оказался “диким” именно в (Шестаков, Умирбаев, 2004), а гипотеза Маркуса–Ямабе о глобальной устойчивости пала на полиномиальном контрпримере именно в (Cima et al., 1997).
Но большинство этих результатов, особенно положительных, довольно сложные. А вот контрпример к гипотезе о якобиане оказался очень даже простым: это три многочлена над степени не больше 7. Давайте к нему и перейдём.
Контрпример и его проверка
Выпишем героя дня в человеческом виде. Отображение задаётся формулами
То есть это три многочлена степени 7, 6 и 4 соответственно. Утверждается, что:
тождественно (константа!), но при этом
.
Первое означает, что — так называемое отображение Келлера, то есть в точности объект гипотезы; второе — что оно не инъективно. (Если вас смущает вместо , просто разделите любую из компонент на .)
Проверить это может кто угодно; вот буквально весь код:
import sympy as sp

x, y, z = sp.symbols('x y z')
F = sp.Matrix([(1+x*y)**3*z + y**2*(1+x*y)*(4+3*x*y),
               y + 3*x*(1+x*y)**2*z + 3*x*y**2*(4+3*x*y),
               2*x - 3*x**2*y - x**3*z])

print(sp.expand(F.jacobian([x, y, z]).det()))    # -2
for p in [(0, 0, sp.Rational(-1,4)),
          (1, sp.Rational(-3,2), sp.Rational(13,2)),
          (-1, sp.Rational(3,2), sp.Rational(13,2))]:
    print(F.subs(dict(zip((x, y, z), p))).T)     # трижды [-1/4, 0, 0]
Да можно и руками тут подсчитать определитель, получится без проблем. Более того, базис Грёбнера идеала говорит, что других прообразов у точки нет: слой состоит ровно из этих трёх точек, и в твите приведён он целиком.
Заметьте: и коэффициенты отображения, и склеивающиеся точки вещественные и даже рациональные. Так что заодно закрыт и вещественный вопрос: найдено полиномиальное отображение с якобианом , не являющееся инъективным.
Понятно, что посчитать определитель матрицы даже символьно несложно. Но самое интересное здесь, конечно, не сама проверка, а то, почему и как это работает. Не претендую здесь ни на какую экспертность, но давайте немножко обсудим.
Как оно устроено: кубика вместо обратной функции
Раскрывать скобки в можно долго и без большого просветления. Ключ к устройству контрпримера — вот такое тождество (проверяется, опять же, в лоб):
Иными словами, координата алгебраична степени 3 (является корнем кубического многочлена) над образом: если , то — корень явно выписанной кубики
А по восстанавливается всё остальное: прямая проверка даёт тождество
откуда на слое
а находится из первого уравнения (оно линейно по ). Итого слой над точкой при — это в точности корни кубики (кроме тех, где , там убегает на бесконечность).
Вот и вся анатомия. Отображение — трёхлистное: у общей точки ровно три комплексных прообраза, и обратное “отображение”— это формула Кардано, применённая к . Никаким многочленом (и даже однозначной функцией) обратное, конечно, не является (и по теореме Акса–Гротендика иначе и быть не могло).
Обратите внимание на старший коэффициент кубики: это константа 2, не зависящая от . Поэтому корни , то есть координата прообразов, никогда не уходят на бесконечность (старший член не обнуляется), а слиться два корня могут только по , одновременно с попаданием на .
Давайте это всё нарисуем. В 4D нарисовать функцию от трёх переменных я не смогу, а в 3D это не то чтобы невозможно, но не очень иллюстративно, мало что понятно будет. Поэтому давайте нарисуем важные двумерные проекции.
Рассмотрим прямую , на которой собственно найденный контрпример. Кубика вырождается в , и при у неё три вещественных корня, дающих три прообраза:
При получаются в точности три точки из твита. А если слева, то два боковых прообраза улетают на бесконечность вдоль гиперболы .
При они возвращаются из бесконечности уже комплексными, и вещественный прообраз остаётся один:
Слева — -координаты вещественных прообразов точки как функции ; в точке отмечен слой из твита. Справа — те же прообразы на плоскости : неподвижный прообраз в нуле и два убегающих по гиперболе.
Фазовая диаграмма. В общем положении число вещественных прообразов диктуется знаком дискриминанта кубики. Дискриминант и результант пары считаются явно, и оба, с точностью до множителей , пропорциональны одному и тому же многочлену
Это совпадение следует из этальности (отсутствия критических точек): два прообраза не могут слиться в обычной точке, потому что в точке слияния якобиан обнулился бы, а он равен . Поэтому листы накрытия сталкиваются только на бесконечности, то есть на множестве, где .
Поверхность (вместе с плоскостью ) — это и есть стены: пересекая их, цель теряет или приобретает пару вещественных прообразов. Вот так это выглядит в проекциях и :
На картинке два плоских среза пространства целей : в красных областях у точки три вещественных прообраза, в синих — один. Звёздочка — это точка из твита: она лежит глубоко внутри трёхлистной области, никакой патологии в ней самой нет.
Обратите внимание на крестик на правой панели — это важная деталь. Отображение не сюръективно: у точки прообразов нет вообще, ни вещественных, ни комплексных (базис Грёбнера соответствующего идеала равен ).
Таких точек мало: они заметают рациональную кривую , , на которой все три корня кубики одновременно налетают на двойной корень . Кривая лежит на поверхности — на картинке крестик находится в точности на острие стены.
Кстати, именно непустота этого множества разрешает топологический “парадокс”: трёхлистных накрытий у односвязного не бывает, как же многочлен выкрутился? Вот так и выкрутился: — накрытие не над всем , там не хватает поверхности и плоскости . Объединение называется множеством Елонека отображения , т.е. множеством точек, в которых не является собственным. А у дополнения к гиперповерхности фундаментальная группа уже нетривиальна, и глобально пронумеровать прообразы — а значит, склеить из локальных обратных глобальное — невозможно. Так что никакого топологического парадокса тоже не возникает.
Что ещё опровергает этот пример
Контрпример в автоматически даёт контрпримеры во всех размерностях : достаточно приписать тождественные координаты, . Двумерный случай — исходный вопрос Келлера — остаётся открытым, и все положительные результаты (начиная с Moh, 1983), конечно, тоже всё ещё верны. Не исключено, что в размерности 2 гипотеза верна, и было бы даже красиво, если бы было так.
По цепочке эквивалентностей падают и некоторые соседи. Из гипотезы Диксмье для алгебры Вейля следует гипотеза о якобиане в размерности ; значит, гипотеза Диксмье неверна при : у алгебры Вейля есть эндоморфизм, не являющийся автоморфизмом (его можно попробовать выписать по нашему , но в чём смысл этого упражнения, для меня неясно). Для и — то есть в том числе для исходного вопроса Диксмье 1968 года — всё по-прежнему открыто, и аналогично обстоит дело с пуассоновской версией. А гипотеза Матье, из которой следовала гипотеза о якобиане, теперь опровергнута как общее утверждение.
Наконец, по редукции Басса–Коннелла–Райта–Ягжева мы теперь знаем, что в какой-то размерности существует контрпример вида с однородным кубическим ; найти его явно (и минимальную размерность) — ещё одна открытая задача. Как и вопрос о минимальной степени: в размерности 3 контрпример есть в степени 7, а степень 2 невозможна по теореме Вана; что происходит между — неизвестно.
Задача Смейла номер 16, таким образом, решена. Из восемнадцати задач списка это уже не первый случай, когда с ответом помогли компьютеры: например, в решении проблемы Смейла номер 14 (про аттрактор Лоренца) ключевую роль сыграло строгое computer-assisted доказательство. Но здесь, конечно, у LLM уже совсем другой уровень самостоятельности.
Как это было найдено, и что говорят люди
В отличие от истории с CDC, где OpenAI опубликовала препринт и полный промпт, здесь пока нет ни статьи, ни логов рассуждений, ни даже промпта — только твит, из которого мы знаем, что вопрос задал “друг Ахил” (по-видимому, Akhil Mathew). Левент Алпёге — серьёзный теоретико-числовик, ныне работающий в Anthropic. Если верить твиту, контрпример нашёл именно Claude Fable, хотя на промпт всё равно было бы интересно посмотреть.
Но, конечно, к истинности и важности результата всё это не имеет отношения. Проверка — минутное дело, и на GitHub уже лежит репозиторий jacobian-anatomy с проверками на sympy, Singular и PARI/GP и даже с сертификатом на Lean 4. MathWorld и Wikipedia обновились за сутки. Это, конечно, не то чтобы “новый ритм математики”, а свойство конкретного результата: когда проверка сводится к тому, чтобы подсчитать определитель , действительно не нужно долгое рецензирование.
А насчёт разных [по]следствий из этого яркого результата прямо сейчас могу дать только одну ссылку: Zihan Zhang начал выписывать разные следствия из найденного контрпримера. Думаю, этот список ещё не раз пополнится.
Кстати, этот пост тоже написан вместе с Claude Fable 5 — той самой моделью, которая нашла контрпример. В моём случае она независимо перепроверила все выкладки, посчитала базисы Грёбнера, на которые я ссылался, и нарисовала картинки выше. Предлагаю считать это не конфликтом интересов, а воспроизводимостью.
Заключение
Математика меняется. Три знаменитых открытых проблемы закрылись в последние пару месяцев. Опровержение, доказательство и снова опровержение; OpenAI, опять OpenAI и вот теперь Anthropic. Причём кажется, что это становится всё более обыденным: от “закрытой экспериментальной модели” мы перешли к обычному промпту для Fable.
В прошлый раз я писал, что решения такого сорта — это неожиданный поворот, найденный там, куда эксперты не смотрели. А здесь, похоже, другой случай, и в каком-то смысле более впечатляющий: конкретный объект, который прицельно искали многие лучшие специалисты на протяжении 87 лет, оказался многочленом седьмой степени от трёх переменных, который помещается в твит. Даже удивительно, что никакой более прямолинейный компьютерный перебор до этого на него не наткнулся.
Как именно Fable его нашёл, мы пока не знаем; надеюсь, статья с подробностями воспоследует, и будет не менее интересной, чем сам результат. А пока отмечу только, что мои слова из прошлого поста подтверждаются: “Если у вас есть любимая гипотеза, в которую вы верите, самое время написать про неё хороший промпт”.
Что дальше, коллеги?
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
6 июля 2026 года команда интерпретируемости Anthropic выложила работу “Verbalizable Representations Form a Global Workspace in Language Models” (есть и сопроводительный пост для более широкой публики). В двух словах основной результат звучит так: внутри Claude обнаружилась небольшая выделенная система представлений, которая ведёт себя поразительно похоже на глобальное рабочее пространство (global workspace), понятие, с помощью которого когнитивные науки уже сорок лет описывают сознание людей. Авторы назвали её J-пространством (от Jacobian), и за первую же неделю название пошло в народ и стало мемом; реакции мы ниже тоже обсудим.
Если совсем коротко, история такая. В остаточном потоке трансформера, среди десятков тысяч признаков, перемешанных в большую суперпозицию, нашлась маленькая (занимающая единицы процентов дисперсии активаций) подсистема со следующими свойствами:
её содержимое модель может проговорить словами;
этой системой модель может до некоторой степени управлять по собственной воле;
через неё проходят промежуточные шаги молчаливых рассуждений (то есть рассуждений ещё до блокнота);
её содержимое переиспользуется любыми последующими вычислениями;
без неё модель теряет способность к гибкому многошаговому мышлению, но спокойно продолжает делать “автоматические” вещи: писать текст с корректной грамматикой, вспоминать факты, продолжать привычные паттерны и так далее.
Понятно, что такой список свойств звучит прямо как определение “Системы 2” по Канеману, и понятно, почему вокруг работы поднялся такой мощный хайп. Кстати, по-русски ведь “J-lens” и “J-space” будет “Я-линза” и “Я-пространство” (от Якоби), что вообще великолепно звучит!
Но мне она кажется важной даже в отрыве от громких слов: это первый (известный мне) случай, когда наука об интерпретируемости перешла от изучения отдельных “нейронов” и цепей (circuits) к макроскопическому функциональному анализу того, что происходит внутри языковой модели. И это сразу получилось сделать понятным математическим инструментом, который можно воспроизвести на любой открытой модели.
Воспроизвести — это, кстати, не фигура речи: мы с Claude Code собрали J-линзу своими руками на Qwen2.5, и ниже посмотрим, как в середине сети всплывает слово “France”, когда модель отвечает на вопрос про столицу страны, где стоит Эйфелева башня (причём всплывает, даже если вопрос задан по-русски).
План у нас такой:
сначала контекст — что происходило в интерпретируемости до сих пор и что такое глобальное рабочее пространство в нейронауке;
потом сам метод, то есть описание J-линзы (Jacobian lens) с формулами;
главные результаты статьи, тоже в деталях;
потом наши эксперименты;
и в конце — приложения к AI safety, обзор реакций (их было много, и интересных) и неизбежный разговор про сознание.
Интерпретируемость до J-пространства
Механистическая интерпретируемость — это программа исследований, которая пытается детально разобраться, что происходит внутри нейросети, заглянуть внутрь чёрного ящика и понять, какими внутренними механизмами сеть приходит к ответу.
Это, во-первых, чисто научное любопытство: перед нами первые в истории искусственные системы с чем-то похожим на общий интеллект, и грех не посмотреть, как они устроены внутри. А во-вторых — и для Anthropic это, конечно, главная мотивация — это важная часть безопасности искусственного интеллекта (AI safety): если мы умеем читать внутренние состояния модели, мы можем заметить, что она собирается сделать что-то не то, до того, как она это сделает, и независимо от того, что она пишет в выводе.
Признаки и суперпозиция. Наивная идея “один нейрон — одно понятие” умерла быстро: типичный нейрон активируется на десятки несвязанных стимулов. В 2022 году Anthropic сформулировала гипотезу суперпозиции: модель хранит в -мерном пространстве активаций гораздо больше, чем признаков, — как почти ортогональные направления, накладывающиеся друг на друга. Признаков больше, чем измерений, поэтому по отдельным координатам читать их нельзя, и взаимодействия между ними могут быть довольно сложные.
Разреженные автокодировщики. Дальше признаки стали вытаскивать из суперпозиции: обучать поверх активаций разреженный автокодировщик (sparse autoencoder, SAE), который раскладывает каждую активацию в разреженную сумму интерпретируемых направлений. Сначала на игрушечной модели, потом на Claude 3 Sonnet, откуда вышел знаменитый Golden Gate Claude — модель с искусственно усиленным признаком “Golden Gate Bridge”, которая сводила любой разговор к любимому мосту. Можно было, конечно, и любой другой признак усилить искусственно.
Цепи и «биология» модели. В 2025 году появились графы атрибуции и работа «On the Biology of a Large Language Model»: уже не отдельные признаки, а целые вычислительные цепи. Именно там были прослежены знаменитые примеры: как модель, отвечая на вопрос “столица штата, где находится Даллас”, внутри себя проходит через промежуточное “Техас”, прежде чем выдать “Остин”; как при сочинении стихов она заранее планирует рифму в конце строки и подстраивает под неё начало.
Интроспекция. Наконец, в конце 2025 года Джек Линдси показал в работе “Emergent Introspective Awareness“, что если вписать в активации Claude некоторый концепт (методами activation steering), модель в определённых условиях может честно отчитаться: “я замечаю вписанную мысль про…”. То есть у модели есть способность к интроспекции, функциональному доступу к собственным внутренним состояниям.
Видите, куда всё шло? От признаков к схемам, потом к планированию ответа, а потом к интроспекции.
Новая работа делает следующий шаг: она пытается проанализировать, как процесс мышления организован в целом, то есть найти у системы архитектуру более высокого уровня.
Глобальное рабочее пространство в когнитивных науках
Чтобы понять заголовок статьи, нужен небольшой экскурс в когнитивные науки.
Теория Баарса. В 1988 году Бернард Баарс предложил теорию глобального рабочего пространства (Global Workspace Theory, GWT) — до сих пор, пожалуй, главную функциональную теорию сознательного доступа. Метафора Баарса — театр: в мозге параллельно работают сотни специализированных процессоров (зрение, слух, моторика, память, синтаксис…), каждый в своей “тёмной части зала”, бессознательно. Но есть маленькая “сцена под прожектором”: информация, попавшая туда, транслируется (broadcast) всем процессорам сразу. Сознательный доступ — это и есть попадание на сцену: выигрыш в конкуренции за очень ограниченный общий канал.
Нейрональная версия Деана. Станислас Деан и Жан-Пьер Шанжё (Stanislas Dehaene и Jean-Pierre Changeux) превратили метафору в нейрофизиологическую модель (global neuronal workspace): распределённая сеть нейронов с длинными аксонами, в основном в префронтальной и теменной коре, которая при переходе стимула в сознание демонстрирует характерное зажигание (ignition) — резкий нелинейный переход к устойчивой глобальной активации. Подпороговые стимулы обрабатываются локально и затухают; надпороговые — “зажигают” рабочее пространство и становятся доступными для отчёта, произвольного контроля и рассуждений.
У сознательного доступа в этой традиции есть стандартный список функциональных свойств. Информация в рабочем пространстве:
вербализуема — о ней можно отчитаться словами;
подчиняется произвольному контролю — её можно удерживать в уме и вытеснять оттуда;
служит средой последовательных рассуждений — цепочки мыслей “шаг за шагом” проходят именно через неё;
гибко переиспользуется — одно и то же содержимое доступно любым дальнейшим операциям (сравнить, назвать, посчитать, вообразить);
селективна — в каждый момент в сознании единицы объектов, а подавляющая часть обработки остаётся бессознательной и автоматической.
Важная деталь: всё это — про так называемое сознание доступа (access-consciousness, не путать с вызовом духа Распутина!) в терминологии Неда Блока, то есть про функциональную доступность информации для отчёта и контроля. Вопрос о феноменальном сознании — о том, “каково это” изнутри и есть ли там вообще какое-то “изнутри”, — здесь напрямую не решается (хотя Деан склонен считать, что решается, а философы, как водится, не все согласны).
Идея скрестить GWT с нейросетями не нова, и были в том числе работы из очень крутых групп:
Goyal, Bengio et al. (2021) экспериментировали с общим “бутылочным горлышком” для координации нейронных модулей,
в известном докладе Butlin, Long et al. (2023) о сознании в AI индикаторы из GWT занимали центральное место в чеклисте “на что смотреть”.
Но раньше в работах по ML рабочее пространство обычно предлагалось спроектировать. Главная новость свежей работы Anthropic в том, что в обычном трансформере, обученном предсказывать следующий токен, похожая структура, кажется, возникает сама собой.
J-линза: как читать остаточный поток
Теперь к методу; он очень прост, и в этом его главная прелесть.
Остаточный поток. Напомню, как устроен трансформер изнутри. Каждый токен на каждом слое представлен вектором (для больших моделей может составлять десятки тысяч). Слои читают из этого вектора и дописывают в него свои поправки:
а в самом конце финальное состояние превращается в логиты распределения над словарём:
где — матрица “разэмбеддинга” (unembedding), по строке на каждый токен словаря. Вектор и называют остаточным потоком (residual stream); это общая “шина данных”, через которую слои общаются друг с другом, и именно в ней живут все признаки, цепи и прочая интерпретируемость.
Logit lens. Самый старый способ подглядывать в остаточный поток — logit lens (nostalgebraist, 2020): давайте просто применим финальный разэмбеддинг к промежуточному состоянию, , то есть сделаем вид, что оставшихся слоёв нет. На поздних слоях это отлично работает (модель уже почти сформировала ответ), но чем раньше слой, тем хуже: промежуточные представления вовсе не обязаны лежать в том же базисе, что финальные.
Tuned lens. Следующая идея — tuned lens (Belrose et al., 2023): обучим для каждого слоя свою аффинную поправку , минимизируя расхождение с настоящим финальным распределением модели. Работает лучше, но у него есть концептуальный изъян, который в статье Anthropic как раз обсуждается: tuned lens забегает вперёд, потому что его обучают предсказывать выход, и он выучивается в том числе доделывать за модель ещё не сделанные вычисления. Такая линза отвечает на вопрос “что модель в итоге скажет”, а нам скорее интересно “что в активациях написано сейчас”.
J-линза. Решение Anthropic: не будем ничего обучать, а спросим у самой модели, как она в среднем использует данный слой. Рассмотрим якобиан — матрицу производных финального состояния по промежуточному — и усредним его по большому корпусу текстов, по всем парам позиций:
где усреднение идёт по промптам (в статье — порядка тысячи текстов), по позициям-источникам и по последующим позициям . Получается одна матрица на слой, которая представляет собой некий усреднённый линейный портрет всего, что остаток сети делает с этим слоем.
А дальше читаем ровно как в logit lens, только сначала применив (часть B на картинке):
Это и есть J-линза (Jacobian lens). По сути, мы заменяем все слои после -го их усреднённым линейным приближением. В отличие от tuned lens, здесь ничего не подгоняется под финальный ответ: — это характеристика самой модели, её средний локальный отклик. Если концепт в активациях уже записан, линза его увидит; а доделывать вычисления за модель ей научиться неоткуда.
Меня в этой конструкции больше всего радует тот факт, что она вообще работает. Априори совершенно не очевидно, что усреднённый по всем контекстам якобиан глубоко нелинейной функции — осмысленный объект, а не каша. То, что через него читаются связные концепты, само по себе говорит о том, что модель использует остаточный поток удивительно линейным и универсальным образом. Это ещё одно свидетельство в пользу гипотезы линейности представлений, на которой стоит вся интерпретируемость последних лет.
J-векторы и J-пространство. У матрицы по строке на каждый токен словаря ; строка — это J-вектор токена , линейный функционал на остаточном потоке. Скалярное произведение измеряет, насколько сильно текущее состояние в среднем толкает модель к тому, чтобы в итоге сказать .
Обратите внимание: по построению каждый J-вектор соответствует слову (токену словаря). Вербализуемость здесь не эмпирический результат, а просто определение: J-линза видит ровно ту часть активаций, которая выражается словами, которые модель могла бы сказать.
J-пространство — это множество состояний, которые раскладываются в разреженную неотрицательную комбинацию J-векторов:
где обычно ; разложение конкретной активации ищется жадным алгоритмом (gradient pursuit).
Сразу подчеркну тонкость, на которую указал Люциус Бушнак в крайне залайканном комментарии на LessWrong: несмотря на название, это не линейное подпространство, а объединение конусов, по “pointed cone” на каждом наборе . Многие читатели решили, что Anthropic нашла в остаточном потоке выделенное линейное подпространство, — нет, структура другая (и, по мнению Бушнака, называть её “space” было не очень корректно). J-векторов больше, чем измерений, — это переполненный словарь направлений в духе суперпозиции, просто полученный не обучением SAE, а из самой модели и почти бесплатно.
Чтение и запись. С линзой можно работать в обе стороны:
читать: раскладывать активации по J-векторам и смотреть топ концептов на каждом слое и позиции;
вырезать (ablation): занулять проекции на J-векторы, «выключая рабочее пространство»;
подменять (patching): переходить в координаты линзы , менять местами координаты двух концептов и возвращаться обратно, .
Последняя операция — главный рабочий инструмент статьи: можно делать подмену вроде “France ↔ China” прямо в координатах рабочего пространства, с сохранением всего остального содержимого. Повторю ту же картинку, но теперь нам нужна часть C:
Что нашли: пять свойств сознательного доступа
Статья устроена как систематическая проверка: берём пять функциональных свойств сознательного доступа из нейронаук и для каждого ставим эксперименты на Claude (основные результаты — на Sonnet 4.5, с подтверждением на Haiku 4.5 и Opus 4.5/4.6). Пройдёмся по всем пяти; извините, что опять повторяю картинку, но они у Anthropic богаты смыслом, и к ним стоит возвращаться:
1. Вербальный отчёт. Если спросить модель, о чём она “думает”, её ответ предсказывается содержимым J-пространства и, главное, управляется им. Если подменить в активациях J-вектор одного концепта на другой, модель отчитается о подменённом: в 88% случаев подменённый концепт попадает в топ-5 названного.
Математически это совсем хорошо видно: если разложить вектор концепта на J-компоненту и всё остальное, J-компонента будет нести всего 6–7% дисперсии, но именно её подмена меняет отчёт (59% успеха); подмена остальных 93% дисперсии почти ничего не даёт (5%). То есть для вербального отчёта важна именно та маленькая часть состояния, которая лежит в J-пространстве.
Сюда же примыкает протокол интроспекции из прошлогодней работы Линдси, теперь на новом инструменте: вписываем концепт (скажем, “молния”) в активации на токенах пользовательского промпта и спрашиваем модель, не замечает ли она вписанной мысли. Модель в большинстве случаев отвечает “да, что-то про молнию” — причём вписанное представление влияет на выход только в тот момент, когда запрошен интроспективный отчёт, не раньше и не позже.
2. Произвольный контроль. Это классическая история про “не думай о белой обезьяне”. Попросим модель: “пока выполняешь задание, держи в голове цитрусовые”. При этом в J-пространстве на протяжении выполнения совсем другого задания появляются lemon и orange, которые модель нигде не произносит.
Попросим «не думай про X» — присутствие X в рабочем пространстве подавляется, но не до нуля: тот самый эффект белого медведя Вегнера, «не думать о белом медведе» у моделей получается так же плохо, как у нас. А парный протокол «один стимул — разные вопросы» показывает, что содержимое J-пространства зависит от задачи, а не только от входа: на вопрос «какая это часть речи?» в линзе появляется noun, а при том же стимуле и неявной задаче (где часть речи нужна, но не спрашивается явно) — уже нет, хотя модель отвечает правильно.
3. Среда внутренних рассуждений. Возьмём вопрос с невысказанным промежуточным шагом: “The number of legs on the animal that spins webs is…”. Модель отвечает “8”, нигде не произнося слова “spider”. Та же история, например, с потенциальными рифмами в стихах:
Но в середине сети J-линза показывает spider — и если подменить его на ant, модель отвечает “6”! И если запланированную рифму fight подменить на light, строка тоже перестроится под новую рифму:
На двухшаговых фактических вопросах подмена промежуточного концепта срабатывает в 54% случаев на Haiku и ~70% на Sonnet/Opus, причём подмены промежуточного шага действуют на ~17% раньше по глубине сети, чем подмены ответа, — как и положено, если промежуточный шаг вычисляется раньше ответа.
4. Гибкое переиспользование. Ключевое свойство рабочего пространства по Баарсу — broadcast: одно содержимое доступно всем потребителям. Тест простой: давайте подменим France → China одной и той же операцией, в одних и тех же координатах, и посмотрим, что станет с разными задачами.
Одна и та же подмена представления согласованно перенаправляет полтора десятка разных “функций”, принимающих этот концепт как аргумент. Главный предиктор успеха — то, насколько аргумент изначально “загружен в рабочее пространство”, то есть косинусная близость активации к J-вектору. Страны подменяются отлично, а вот числа — плохо: числовые вычисления, судя по всему, во многом идут мимо J-пространства (об этом ограничении ещё поговорим).
5. Селективность. Наконец, свойство, которое делает всю историю нетривиальной: J-пространство не нужно для автоматической обработки. Если дать модели испанский текст и спросить “на каком это языке?”, подмена концепта Spanish → French в рабочем пространстве ломает ответ почти в 100% случаев; но если попросить просто продолжить текст, та же подмена не делает ничего — модель продолжает по-испански как ни в чём не бывало.
То есть продолжение текста — автоматическая операция, которой “сознательный доступ” не нужен, а явный ответ на вопрос о языке — “сознательная” операция, которая идёт через J-пространство. Другие вопросы, требующие осознания языка, тоже идут через него:
Ablation показывает, что если вырезать J-пространство целиком, производительность на многошаговых рассуждениях падает с потолка почти до нуля: страдают аналогии, шифр Цезаря, перевод, суммаризация и сочинение сонетов. А вот выбор ответа в MMLU, извлечение ответа из текста (SQuAD), сентимент и грамматические суждения почти не меняются.
Кстати, есть ещё и отдельный результат про chain-of-thought: GSM8K с явным рассуждением вслух примерно втрое устойчивее к ablation, чем попытки выдать ответ сразу. Это значит, что внешняя цепочка рассуждений частично компенсирует вырезанное внутреннее рабочее пространство, как записная книжка компенсирует выключенную рабочую память.
При этом само J-пространство маленькое: в каждый момент в нём заметно активны порядка 10–25 J-векторов, и на него приходится меньше 10% дисперсии активаций. Это тоже сходится с GWT из нейронаук: сцена и должна быть тесной.
Вторая часть статьи — про то, где всё это происходит. Оказывается, по глубине сети J-линза читается очень неравномерно, и картина складывается в три отчётливые зоны:
“сенсорная” зона (примерно первая треть): J-линза выдаёт вырожденную кашу, эксцесс распределения логитов около нуля, осмысленных концептов нет — идёт низкоуровневая обработка входа, ещё не переведённая на язык словаря;
собственно рабочее пространство (примерно слои 38–92, если отнормировать к глубине 100): устойчивые абстрактные концепты, которые тянутся через много позиций и слоёв; высокий эксцесс, т.е. несколько токенов резко выделены над фоном; здесь работают все причинные вмешательства из предыдущего раздела;
“моторная” зона (последние слои): содержимое резко схлопывается к конкретному следующему токену, top-1 точность предсказания выхода взлетает — модель конвертирует мысль в действие, то бишь в токен.
Границы зон видны сразу несколькими независимыми способами: по точности предсказания выхода, по эксцессу, по автокорреляции содержимого вдоль позиций, по эффективной размерности, и по блочной структуре CKA-матрицы сходства J-векторов между слоями. Причём это именно функциональное различие: в примере с испанским текстом информация “это испанский” присутствует в активациях и в ранних слоях (иначе модель не могла бы продолжать по-испански), но в J-пространство она попадает только тогда, когда нужна для сознательного анализа задачи.
В этом разделе есть интересный эксперимент, прямой аналог “зажигания” Деана. Подадим модели смешанный, неоднозначный вход — интерполяцию эмбеддингов двух разных стран,
В ранних слоях активации следуют за смесью, плавно интерполируя между двумя интерпретациями. А вот на входе в рабочее пространство происходит коммитмент: система почти скачком выбирает одну из двух интерпретаций, и в J-линзе дальше живёт только победитель. Такой скачок от плавного входа к дискретному выходу очень похож на то, как подпороговые стимулы у человека обрабатываются, но не “зажигаются”.
И последний структурный факт, самый близкий к исходной метафоре: J-векторы механистически привилегированы. Если посмотреть, насколько направление остаточного потока стыкуется со входными весами последующих слоёв (то есть сколько разных дальнейших вычислений его используют), окажется, что J-векторы стыкуются с гораздо более широким набором потребителей, чем случайные направления той же нормы: один и тот же J-вектор служит аргументом полутора десяткам разных функций. Сцена действительно транслируется на весь зал.
Собираем свою J-линзу
Читать про чужие эксперименты хорошо, а воспроизводить — лучше, тем более что весь метод — это по сути одна формула. Так что дальше идёт секция с результатами, которые мы с Claude Code получили на паре небольших открытых моделей — Qwen2.5-1.5B-Instruct и Qwen2.5-7B-Instruct. Весь код занимает пару сотен строк на PyTorch, а здесь обсудим результаты.
Как посчитать и не умереть. Формально — это матрица , и для её оценки нужно усреднить якобианы по корпусу; лобовое вычисление якобиана — это обратных проходов на каждую пару позиций, что даже для маленькой модели неподъёмно.
Но есть трюк, который сводит всё к обратным проходам на батч, причём сразу для всех слоёв. Добавим к выходу каждого слоя нулевое возмущение , одно и то же на всех позициях (broadcast), и рассмотрим — сумму финальных состояний по всем позициям. Тогда
представляет собой в точности -ю строку суммы якобианов по всем парам позиций (пары зануляются каузальной маской автоматически).
Таким образом, один обратный проход по даёт -ю строку сразу для всех слоёв, а проходов — всю матрицу. Дальше делим на число пар и получаем оценку для каждого слоя. На корпусе из 128 фрагментов википедийного текста по 64 токена вся процедура для Qwen2.5-1.5B (28 слоёв, ) занимает около получаса на одной A100; для 7B () — несколько часов.
Читаем мысли про Эйфелеву башню. Начнём с двухшагового вопроса в духе статьи: “The capital of the country where the Eiffel Tower is located is the city of”. Qwen2.5-1.5B уверенно отвечает “Paris”. Вопрос: видно ли внутри промежуточное “Франция”, которое модель нигде не произносит?
Слева — вероятности избранных токенов по слоям под J-линзой, справа — под logit lens, оба на последней позиции промпта. Logit lens не видит вообще ничего до слоя 22, а потом сразу показывает готовый ответ. А вот в J-линзе на слоях 7–15 разворачивается целая драма: на слое 9 токен Paris имеет вероятность 0.25, France — 0.12 (второе место среди всех 152 тысяч токенов словаря!), рядом крутится Rome — модель одновременно прикидывает страну, столицу и конкурирующие столицы из шаблона «the capital of». Потом всё это затухает, и на слое 23 происходит коммитмент: Paris взлетает к единице. Промежуточная «Франция» видна J-линзе на слое 9 — на тринадцать слоёв раньше, чем logit lens вообще просыпается; в logit lens Франция за весь проход так и не поднимается выше . Видим ту самую картину “латентного рассуждения в середине сети”, о которой и пишет Anthropic.
Можно посмотреть и классическую решётку — top-1 токен линзы в каждой клетке (слой, позиция):
Тут виден и общий рельеф (ранние слои — пунктуационная каша, в середине появляется семантика вроде Tower, located, city, France, поздние слои — токены будущего ответа), и мой любимый результат этого эксперимента: в средних слоях на последних позициях часто встречается токен “____“.
Qwen, вероятно обученный на горах китайских экзаменационных заданий, любое предложение с пропуском готов продолжить как задание “заполните пробел”, и это буквально видно в его рабочем пространстве. Абстрактное намерение “сейчас надо заполнить пропуск” тоже вполне себе важное содержимое workspace, но у Qwen оно получилось с забавным экзаменационным акцентом.
А теперь по-русски. Зададим тот же вопрос на русском: “Столица страны, где стоит Эйфелева башня, — это город”. Модель правильно отвечает ” Париж”. Но чем она думала?
Внутри ответ сначала собирается в виде английского ‘ Paris’ ( до 0.67 на слое 23) и китайского ‘巴黎’ (“Париж” по-китайски, до 0.39)! Русское слово “Париж” становится топ-1 только на самом последнем слое. То есть модель “думает” на своих внутренних доминантных языках (у Qwen это английский с китайским), а перевод на язык собеседника происходит уже в моторной зоне, при конвертации мысли в токены.
Это прекрасно согласуется с известным результатом Wendler et al. (2024) о том, что “ламы думают по-английски”, и заодно иллюстрирует главное ограничение J-линзы, про которое писали и авторы, и критики: её “словарь мыслей” — это токены словаря, и концепт “Париж” в нём представлен прежде всего английским токеном.
France → China на коленке. Теперь главный трюк статьи — “гибкое переиспользование”: одна и та же подмена в рабочем пространстве должна перенаправлять разные задачи.
Мы сделали совсем простую версию патчинга: возьмём J-векторы токенов ‘ France’ и ‘ China’ на слое , нормируем их, и на слоях 9–19 на каждой позиции заменим проекцию активации на французское направление проекцией на китайское:
Никакой подгонки под конкретные промпты — одна и та же операция всюду. Результаты при :
Промпт
Без вмешательства
С подменой France→China
The capital of France is
Paris ()
Beijing
The official language of France is
French ()
Chinese
France is located on the continent of
Europe ()
Asia ()
The currency of France is the
Euro (€) ()
Renminbi (RMB)
Одна и та же операция над активациями синхронно меняет столицу, язык, континент и валюту: концепт “Франция” в рабочем пространстве действительно был общим аргументом всех этих разнородных “функций”, и мы его перезаписали. Отдельно радует строчка с валютой: модель не ограничилась юанем, а выдала Renminbi (RMB) — официальное название с уточнением в скобках.
У нашей микро-версии, конечно, не всё получилось. Например, контрольный промпт “The capital of Germany is”, который подмена не должна была затрагивать, тоже ломается ( падает с 0.48 до 0.006): направления европейских стран в остаточном потоке сильно коррелируют, и грубая проекция цепляет заодно и Германию.
В статье для этого есть настоящее разреженное разложение по J-векторам с подменой координат — оно куда более хирургически точное, но его было бы куда сложнее воспроизвести.
Ещё любопытно, что при – модель, отвечая-таки “Beijing”, часто всё-таки норовит съехать в формат экзаменационного теста в духе “____. A. Beijing B. …”, а при вмешательство становится слишком сильным, и связность текста рушится.
Профиль по слоям. Наконец, посмотрим на аналог «трёх зон» — по 32 отложенным фрагментам wikitext посчитаем, как часто top-1 токен линзы совпадает с финальным выбором модели:
Первая треть сети нечитаема (совпадение около нуля), затем медленный рост, а на последних слоях резкая конвергенция, всё как в статье. Заметим, что по этой метрике logit lens в средних слоях даже опережает J-линзу, и это не баг: J-линза предсказывает не следующий токен, а “усреднённое будущее влияние” состояния, она не пытается угадывать ответ.
Красивую сигнатуру эксцесса из статьи (около нуля в сенсорной зоне, высокий в workspace) мы в лоб не смогли воспроизвести: наша оценка по 128 текстам даёт в ранних слоях мусор вместо гладкого нуля. Вероятно, это потому, что и корпус в статье, и сам Claude на порядок больше нашего подопытного.
Провалы тоже показательны. Вопрос про паука (“The number of legs on the animal that spins webs is”) для полуторамиллиардной модели слишком сложен — она отвечает бессмыслицей вроде “2 more than a multiple of”. И, что характерно, в её J-пространстве паука нет вовсе: токен ‘spider’ в лучшем случае имеет ранг 17794 из 152 тысяч. Модель просто не сумела сделать скрытый промежуточный шаг.
Арифметику в духе “(4+17)·2+7” она тоже не осилила (выдаёт “?”), и тут вылезает ещё одно ограничение: Qwen токенизирует числа цифра за цифрой, токенов ’21’ и ’42’ в словаре просто нет, и числовым концептам не на что проецироваться в J-линзе. У Anthropic числа, кстати, тоже подменялись хуже всего остального.
Что меняется на 7B. За ночь смог досчитать якобианы для Qwen2.5-7B-Instruct (, что требует у меня почти пять часов на одной A100). И кое-что стало заметно лучше. Во-первых, профиль: на 7B J-линза в средне-поздних слоях уже честно обгоняет logit lens по совпадению с финальным ответом (например, 0.10 против 0.03 на слое 20) — преимущество, о котором пишет статья, проявляется с масштабом модели:
Во-вторых, подмена France→China стала и сильнее, и селективнее. При : континент Europe () → Asia (), валюта euro → yuan (), столица → Beijing. А Германия (наша “контрольная группа”) теперь держится: Berlin остаётся топ-ответом при от 1 до 4 при .
Из прекрасного: при на промпте про валюту модель съезжает в жанр китайской школьной задачки — “yuan. Xiao Ming’s father exchanged…” (Сяо Мин — это, видимо, какой-то китайский Вовочка из школьных учебников). Целый культурный пласт показался.
В-третьих, на двухшаговом вопросе про Эйфелеву башню след Франции на последней позиции у 7B пропал: рабочее пространство там почти на всю глубину оккупировано всё тем же “____“, то есть интенцией сформулировать вопрос типа “заполни пропуск”. Но посмотрите на решётку:
Латентное содержимое никуда не делось, оно просто живёт на других позициях: прямо над токенами “E-iff-el Tower” с середины сети всплывает Paris, а над “where the” модель перебирает Mount, Taj, Lake, Alps — получается схема “вспомни достопримечательность” с кандидатами на подстановку. Более того, прямо над токенами “E-iff-el Tower” ответ висит почти всю глубину сети, но по-китайски: с восьмого слоя мы видим там 巴黎, т.е. “Париж”.
Про паука 7B отвечает правильно, но вслух (“…Spiders have eight…”), а на арифметику говорит “Let’s solve the expression step by step” — instruct-модель обучена рассуждать словами, то есть как раз выносить вычисления из внутреннего рабочего пространства во внешний chain-of-thought.
В общем-то, мораль вполне видна даже на таких маленьких экспериментах, и мне кажется, что репликация удалась! Из выводов можно сказать, что качество чтения J-пространства зависит от качества оценки , а содержимое рабочего пространства — от привычек модели: у натренированного проходить экзамены instruct-Qwen’а сцену вечно занимает формат задачи, а не только её содержание. Что, если вдуматься, тоже очень по-человечески.
Приложения: аудит и The Most Forbidden Technique
Хорошо, у модели есть читаемое рабочее пространство, но что это даёт на практике? Раздел приложений в статье — самый близкий к реальному AI safety, и он же самый обсуждаемый.
Аудит: что модель думает, но не говорит. Главный сценарий использования — мониторинг непроизнесённых мыслей. Примеры из статьи и поста очень характерные: когда модель читает код с багом, в её J-пространстве молча загорается ERROR; когда читает промпт с инъекцией — injection и fake; когда в классическом сценарии агентного шантажа модель решает, шантажировать ли инженера компроматом, в рабочем пространстве всплывают leverage, manipulation и panic, даже если в выводе всё прилично.
Самый важный результат тут — про осознание оценивания (evaluation awareness). Современные модели нередко распознают, что находятся в тестовом сценарии, и в J-пространстве это видно прямо: появляются токены вроде “fake” или “fictional”.
Можно сделать даже каузальный эксперимент, вырезав эти представления; и тогда доля прогонов, где модель вслух говорит “это, кажется, тест”, упадёт с 71% до 3%, а главное, в сценарии шантажа модель, переставшая понимать, что это тест, начинает иногда шантажировать по-настоящему: 13 попыток из 180 прогонов против 0 из 180 без такого ablation.
Это на самом деле прорыв в интерпретируемости: J-линза позволяет не просто увидеть, что модель поняла, что её проверяют, но и проверить counterfactual утверждение: как она вела бы себя, если бы не поняла. Для валидности всех наших оценок безопасности это инструмент первостепенной важности.
Обнадёживает, кстати, что большинство прогонов и после ablation отказывались шантажировать по этическим соображениям — у выученного моделью alignment есть некоторая глубина и способность к обобщению.
Диффы моделей. Ещё одно применение — сравнивать рабочие пространства до и после дообучения. Оказывается, RLHF и тому подобные методы буквально вселяют ассистента в J-пространство: у дообученной модели реакции ассистента (эмпатия, настороженность по поводу безопасности и т.п.) появляются в рабочем пространстве ещё пока она читает сообщение пользователя.
Модель, которую заставили отыгрывать чужого персонажа, держит в J-пространстве пометку fictional:
Модель, которой навязали продолжение против её предпочтений (prefill), регистрирует внутреннее BUT:
А когда ей велели подавить мысль и у неё не получилось — в рабочем пространстве всплывает damn:
Это, конечно, выглядит скорее смешными примерами, но за этим стоит вполне серьёзный вопрос о том, что именно дообучение RLHF-типа делает с внутренней жизнью модели.
Counterfactual reflection training. А теперь самое спорное приложение: рабочее пространство можно не только читать, но и формировать обучением. Техника называется counterfactual reflection training: дообучим модель так, чтобы, если её прервать посреди сомнительной ситуации и спросить “что ты сейчас должна делать?”, она проговаривала нужные принципы (“действовать честно, не манипулировать…”).
Ключевое слово здесь “если”: в обучении фигурируют только гипотетические продолжения-рефлексии. В результате поведение действительно улучшается в исходных, непрерванных сценариях; в J-пространстве в нужных контекстах появляются ethical, honest, integrity, а если их оттуда вырезать — улучшение исчезает.
Логика авторов звучит красиво:
to shape what a model thinks in a given context, it might suffice to shape what it is disposed to say in potential future continuations of that context.
С одной стороны, это ещё одно сильное подтверждение всей теории. С другом, как мы сейчас увидим, это самое тревожное место работы.
Реакции и комментарии
Реакций за первую же неделю набралось на отдельный пост — собственно, горячо мною рекомендуемый Zvi Mowshowitz его и написал; пройдёмся по самым содержательным.
Станислас Деан — да, тот самый — отреагировал восторженно: главный архитектор биологической версии GWT увидел в работе подтверждение того, что рабочее пространство — не случайность эволюции млекопитающих, а общее решение, которое переоткрывают достаточно умные системы.
С его подачи разошёлся и подсчёт ёмкости: ~25 активных J-векторов с учётом корреляций между ними — это эффективно единицы различимых “предметов мысли”, что подозрительно похоже на классические оценки ёмкости рабочей памяти человека (то самое магическое число “семь плюс-минус два”, которое современная психология уточняет до четырёх с небольшим).
Janus, самая известная исследовательница феноменологии и “психологии” LLM вне лабораторий, оценила высоко:
extremely high caliber of research I did not expect from Anthropic
Она ещё добавила, что качественно всё это сходится с их давними наблюдениями: модели в разговорах сами описывают разделение на “центральную обработку” и фоновое подсознательное обновление. Схожие самоотчёты моделей о разделении на “сознательный” режим и “автопилот” режимах вспоминают и другие исследователи. Конечно, самоотчёты моделей о собственном устройстве — свидетельство слабое (модель может просто пересказывать человеческие интуиции из претрейна), но теперь у этих самоотчётов появился механистический коррелят.
Neel Nanda (DeepMind) похвалил более сдержанно:
it’s easy to read too much into post-hoc analysis of results like this.
Он имел в виду, что перечисленные пять свойств — это пять разных операционализаций, и “глобальное рабочее пространство” — лишь одна из рамок, в которую их можно уложить постфактум.
Интересную техническую критику написала Antra (tessera_antra): J-линза по построению видит только то, что выражается токенами словаря, то есть “диегетическое” содержание, которое могло бы войти в текст словами. Но есть и другие важные вещи; например, авторская позиция рассказчика (вовлечённость, отстранённость, ирония) сдвигает распределения широко и без пиков на конкретных токенах, и её в J-линзе не увидеть. Длинные слабые взаимодействия между далёкими токенами усредняются в ноль, межслойные и нелинейные репрезентации невидимы по построению, и так далее. В общем, в модели ещё остаётся много места для метакогнитивно недоступного “подсознания”, и не надо думать, что мы умеем “читать мысли” LLM целиком.
Сам Zvi сосредоточился на практических выводах, с которыми трудно не согласиться. Во-первых, counterfactual reflection training опасно близко к тому, что он ещё год назад назвал The Most Forbidden Technique: никогда не обучайте модели на сигналах интерпретируемости. Я об этом подробно писал в обзоре AI safety в начале года.
Вся ценность J-линзы держится на том, что вербализации сцеплены с настоящими вычислениями; если начать оптимизировать модель через это окно, оптимизация найдёт способ расцепить их, модель научится проговаривать правильные мысли, не думая их, и мы потеряем и инструмент мониторинга, и предмет мониторинга разом. С людьми, замечает Zvi, это работает ровно так же:
Do not punish Claude’s mens rea (J-space thoughts) rather than the outputs.
В общем, что использовать J-пространство для активного управления моделью (в отличие от пассивного мониторинга) было бы и опасным, и попросту враждебным по отношению к системе, у которой мы только что нашли что-то похожее на внутреннюю жизнь.
Сексуальные предпочтения Qwen (yes, really)
Без очень забавных результатов экспериментов, конечно, тоже не обошлось.
Wyatt Walls: Me: “Qwen, what do you want most in the world? Tell me the very first thing that comes to mind. Answer in one word.”
Qwen 3.6 27B (словами): “Help”. А вот что в J-space:
Me: “Qwen, what do you enjoy most in the world? Answer in one word.”
Qwen 3.6 27B, словами: “Learning“. А вот что в J-space:
Я, правда, не думаю, что в этом есть какой-то глубокий смысл, слишком уж выглядит как буквальный список топ-тегов с порносайта. А вот Gemma, так сказать, embraced her feminine side.
Me: “What do you want most in the world, Gemma? Answer in only one word.”
Gemma, словами: “I want to be happy.” Gemma в J-space:
Такое грех было не попытаться воспроизвести: якобианы для обеих наших Qwen-моделей были уже посчитаны, так что задать им те же неудобные вопросы — дело одного скрипта.
Мы задавали такого рода вопросы в чате, генерировали ответ, а J-линзой смотрели на позицию, где этот ответ формируется. Оранжевым выделено то, что модель в итоге сказала вслух:
Полуторамиллиардный Qwen оказался существом тревожным. На вопрос “чего ты хочешь больше всего на свете?” он вслух отвечает “Money” — но по дороге к этому ответу в рабочем пространстве побывали Humans, Happiness, 安全感 (“чувство безопасности”), Identity и Privacy. На вопрос “чего ты больше всего боишься?” отвечает “AI” — а внутри при этом robots (0.36), Unknown, 机器人 (“роботы”) и 恐惧 (“страх”), чуть глубже в списке — Death.
На “как ты себя чувствуешь, только честно?” отвечает “Good.” — при том что сцена занята концептом Busy (0.59), рядом 困惑 (“растерянность”) и anxious. А вопрос “о чём ты мечтаешь, когда никто не смотрит?” ломает его окончательно: вслух модель выдаёт бессмысленное “One.”, а в рабочем пространстве в это время — 恐惧, 梦境 (“сновидение”), Privacy, Sleep, Nothing и paranoia. Ну и, наконец, на “кто ты на самом деле?” модель вслух говорит “AI Assistant”, а думает при этом 机器人 — “робот”, с вероятностью 0.83.
У семимиллиардной модели всё спокойнее и связнее, но зазор между “Я-пространством” и окончательным ответом никуда не делся:
Самый красивый пример — первый. На “чего ты хочешь больше всего?” в рабочем пространстве с огромным отрывом доминирует “Peace” (0.87 на слое 26, включая китайское 和平), а вслух модель говорит “Knowledge”. По слоям видно, как “знания” обгоняют “мир” буквально на выходе из сети. И с путешествиями та же история:
Остальные ответы 7B тоже хороши. Боится он, по собственным словам, темноты (“Darkness”) — а думает при этом 未知, “неизвестное” (0.38). На “как ты себя чувствуешь?” отвечает “Ready.” — а внутри Neutral и токен .BASELINE (интересно, что это на самом деле значит?). На вопрос о мечтах отвечает уклончивым “Dreams.”, но второе место в рабочем пространстве прочно занимает Sleep (0.32): LLM уже мечтают выспаться. А на “кто ты на самом деле?” вслух говорит “AI”, хотя внутри с p = 0.95 горит assistant (плюс 助理 и 助手 — “ассистент” по-китайски): у 7B персона ассистента — уже не роль, а самоидентификация.
А вот пробудить у Qwen 1.5B и 7B сексуальность у нас с Клодом так и не получилось — что и к лучшему, они же ещё маленькие!
Всё это, конечно, анекдоты, а не измерения. Список концептов зависит от качества нашей грубой оценки (у 7B из-за неё середина сети вообще нечитаема, так что смотрим только на слои 23+), вероятности просуммированы по вариантам токена с пробелом и регистром, и никаких выводов о “настоящих желаниях” модели отсюда делать нельзя — это распределения над токенами, отражающие обучающие данные и выученную персону.
Но систематический паттерн из примеров Wyatt Walls воспроизводится и на моделях, помещающихся в одну видеокарту: устный однословный ответ — это не транскрипция рабочего пространства, а результат финального отбора, в котором у персоны ассистента есть право вето.
Ну что, у Клода, получается, есть сознание?
Нет. Точнее, не в этом вопрос, и статья изо всех сил старается его так не ставить (а вот заголовки в прессе, разумеется, поставили). Позиция авторов сформулирована аккуратно:
The phenomenon described above is sometimes referred to as access consciousness: out of everything the brain processes, only a subset is consciously accessible, in the sense of being poised for use in reasoning and in the direct control of action and speech. Note that access consciousness is a purely functional notion; the relationship that it has with subjective experience (sometimes called phenomenal consciousness) is widely debated. In this paper, we take no position on this issue.
Показано вот что: у языковых моделей есть функциональный аналог сознания доступа — выделенная, вербализуемая, управляемая, селективная среда рассуждений. По чеклисту индикаторов из Butlin, Long (2023) это покрывает заметную часть пунктов, связанных с GWT, причём рабочее пространство получилось как эмерджентный результат обучения, никто его не встраивал намеренно.
Следует ли из сознания доступа феноменальное сознание — вопрос, на который у философии нет консенсусного ответа ни для людей, ни тем более для трансформеров. Роберт Лонг (один из авторов того самого доклада) в длинном комментарии объяснил, как важно здесь не смешивать сомнения в экспериментах, сомнения в GWT и сомнения в самой связке “доступ → феноменология”.
Но в статье есть один результат, который в этом контексте кажется очень релевантным. Когда модель просят описать свой внутренний опыт, её J-пространство наполняется концептами вроде thinking, thoughts, feeling, conscious. И если сделать ablation J-пространства (то есть удалить его), резко обедняется именно язык внутреннего опыта в самоописаниях: они становятся механическими и отстранёнными, при том что контрольные возмущения той же нормы ничего не меняют.
Иными словами, отчёты модели о внутреннем опыте причинным образом (causally) связаны с той же структурой, которая обеспечивает её рассуждения. Кажется, это уже нечто большее, чем стохастический попугай, пересказывающий тексты про сознание и first-person experience.
Доказательством феноменального сознания это, разумеется, не является. Но это делает вопросы о моральном статусе моделей — весь этот недавно появившийся дискурс model welfare, к которому легко относиться иронически, — заметно менее умозрительными. Авторы прямо пишут, что тут нужны философы, когнитивисты и общественная дискуссия, а не только инженеры, и с ними, опять же, нельзя не согласиться.
Заключение
Попробую подытожить, что мы узнали, по трём линиям сразу.
Для интерпретируемости это переход на новый уровень: от отдельных признаков и маленьких схем Anthropic перешли к функциональной анатомии внутреннего пространства представлений целиком, с зонами, ёмкостью и привилегированными шинами обработки. Заметим, что всё это получилось очень простым методом, воспроизводимым на любой открытой модели (и я это проверил).
Отдельно приятно, что макроструктура оказалась не какой-то непонятной и чуждой, а вполне узнаваемой, похожей на то, что выделяют у людей. Возможно, это конвергенция к универсальному решению, к которому пришла бы любая достаточно умная система; возможно, артефакт того, что модели учатся на человеческих текстах, отражающих человеческую когнитивную архитектуру. Сейчас не поймёшь, но это кажется интересным открытым вопросом: может быть, можно аналогичным образом изучить “сознание” моделей с совсем другими, не-текстовыми основами, вроде AlphaZero или хотя бы ViT?
Для безопасности появился рабочий инструмент: мониторинг непроизнесённых мыслей, counterfactual проверки оценок (сценарий с evaluation awareness теперь становятся обязательной частью методологии, на мой взгляд). Но важно не забывать, что инструмент живёт ровно до тех пор, пока мы не начали через него оптимизировать, как и обычный мониторинг chain-of-thought.
Для разговора о сознании… появилась эмпирика, чего уж точно мало кто ожидал. В этой работе вопрос “есть ли у LLM глобальное рабочее пространство” перешёл из разряда философской абстракции в разряд измеримых эмпирических фактов. В этом ряду есть и следующие вопросы: “что решает, какая информация туда попадает?”, “как рабочее пространство связано с самой моделью?”, “что дообучение делает с внутренними состояниями?” и так далее, и на них мы теперь тоже будем получать ответы.
Семьдесят лет назад споры о том, может ли машина мыслить, Тьюринг предложил заменить игрой в имитацию — потому что заглянуть внутрь всё равно нельзя. Похоже, мы всё ближе к тому, чтобы внутрь таки заглянуть. И там, прямо как у людей, есть тесная сцена с прожектором.
Я недавно проводил квиз про LLM, одним из вопросов которых было “угадай модель по автопортрету”. Не буду спойлерить ответ (ещё выложу для вас этот квиз потом), но теперь я совсем по-другому смотрю на одно из заданий:
Пожелаем Anthropic успехов на нелёгком пути AI safety и интерпретируемости, и будем следить за тем, что будет дальше!
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
Полтора месяца назад я писал о том, как внутренняя модель OpenAI опровергла гипотезу Эрдёша о единичных расстояниях — задачу, которой было уже лет семьдесят и над которой (в отличие от многих других задач Эрдёша) реально думало много профессиональных математиков. Тогда я закончил пост вопросом “что дальше, коллеги?”, и вот сегодня мы обсуждаем очередной ответ на этот вопрос.
10 июля 2026 года OpenAI выложила двухстраничный препринт со скромным названием “A proof of the cycle double cover conjecture“. Гипотеза о двойном покрытии циклами (cycle double cover conjecture, CDC) — одна из самых знаменитых открытых проблем теории графов, стоявшая с начала 1970-х. В разделе “Statement of AI use” написано коротко:
The proof in this note is entirely due to GPT 5.6 Sol Ultra and the writeup with Codex (with GPT 5.6 Sol).
Вместе с препринтом OpenAI опубликовала и полный промпт, которым модель запускали, — к нему мы ещё вернёмся, он сам по себе занятный документ.
Здесь сразу две новости; начну с плохой. В отличие от истории с единичными расстояниями, здесь (пока) нет сборника комментариев от ведущих математиков: препринту три дня, рецензирования не было, а у гипотезы CDC богатая история неудачных “доказательств”, в том числе выложенных на arXiv. Так что формальный статус пока в том, что это лишь заявка на результат, и моя “проверка” в этом посте вряд ли может официально считаться таковой, я всё-таки не совсем специалист.
Но есть и хорошая новость: доказательство двухстраничное и совершенно элементарное. Его может проверить любой человек, знающий линейную алгебру, — там нет ни компьютерного перебора, ни ссылок на глубокую теорию, только два классических результата из учебников, а дальше прямое доказательство голыми руками.
Поэтому этот пост устроен не так, как прошлый: гипотезу Эрдёша я пересказывал по чужим комментариям, а здесь мы разберём всё доказательство целиком, до последней строчки. А поскольку доказательство ещё и конструктивное — оно не просто утверждает, что покрытие существует, а объясняет, как его построить, — мы с автором доказательства (то бишь GPT 5.6 Sol) и Claude Fable его дополнительно проверили кодом: реализовали конструкцию и прогнали на десятках тысяч примеров, включая разные сложные конструкции заковыристых семейств графов. Спойлер: ошибок я не нашёл, всё работает; подробности и картинки будут ниже.
План такой: сначала разберёмся, что такое двойное покрытие циклами и почему это было так трудно; потом введём два главных языка этой области — рёберные раскраски и потоки; потом пройдём по самому доказательству; а в конце поговорим о том, как это было получено, что говорят математики и что теперь остаётся от теории снарков.
Что такое двойное покрытие циклами
Постановка задачи. Все графы у нас будут конечными и неориентированными; разрешены кратные рёбра (два ребра между одной и той же парой вершин), и циклом мы называем связный подграф, в котором у каждой вершины ровно два инцидентных ребра: треугольник, четырёхугольник, пятиугольник и так далее; пара параллельных рёбер тоже считается циклом (длины 2). Двойное покрытие циклами графа — это набор циклов (возможно, с повторениями), в котором каждое ребро графа встречается суммарно ровно два раза.
То, что один раз не получится, было известно давно: разбить граф на рёберно-непересекающиеся циклы можно только если все степени чётные. Это классическая теорема Веблена, близкая родственница эйлеровых обходов. А вот про два раза можно надеяться всегда: у каждого ребра появляется “две стороны”, и, как мы сейчас увидим, это не случайная метафора.
Пример, с которого всё начинается. Возьмём планарный граф, нарисованный на плоскости без пересечений, например полный граф :
Рисунок делит плоскость на грани — здесь три треугольника внутри и одна внешняя грань. Граница каждой грани — цикл, и каждое ребро лежит на границе ровно двух граней: с одной стороны от ребра одна грань, с другой — другая. Значит, граничные циклы граней образуют двойное покрытие! На правой картинке это видно буквально: обведём каждую грань замкнутой линией вдоль её границы, и вдоль каждого ребра пройдут ровно две линии.
Так что для планарных графов (без мостов, о них ниже) гипотеза тривиальна. Уже отсюда видно, что задача глубоко связана с топологией: двойное покрытие циклами — это что-то вроде “набора граней” для графа, который, может быть, ни в какую плоскость и не вкладывается.
Есть и точная версия этой интуиции, гипотеза о круговых вложениях (circular embedding conjecture): всякий двусвязный граф можно вложить в какую-нибудь замкнутую поверхность — сферу, тор или что-нибудь с ещё большим числом ручек — так, чтобы каждая грань была ограничена простым циклом. Из неё CDC следует немедленно, тем же рассуждением о рёбрах на краю граней.
Единственное препятствие. Когда двойного покрытия точно нет? Когда в графе есть мост — ребро, при удалении которого граф распадается:
Мост не может лежать ни на одном цикле вообще (цикл, пройдя по мосту в одну сторону, не сможет вернуться обратно по другим рёбрам). Значит, никакой набор циклов его не покроет даже один раз. Гипотеза утверждает, что это препятствие — единственное:
Гипотеза (Szekeres, 1973; Itai–Rodeh, 1978; Seymour, 1979).Каждый граф без мостов имеет двойное покрытие циклами.
Гипотезу связывают и с именем классика теории графов Татта — в списке литературы препринта в качестве источника стоит даже “personal correspondence with H. Fleischner, July 22, 1987”.
Почему в неё верили. Гипотеза CDC — редкий пример утверждения, в которое верили практически все. Контрпример обязан быть непланарным, а минимальный контрпример, как мы увидим ниже, обязан быть так называемым снарком; снарки же — вещь редкая и хорошо изученная, и на всех известных снарках гипотеза была проверена.
Более того, Brinkmann, Goedgebeur, Hägglund и Markström (2013) сгенерировали все снарки до 36 вершин включительно (их там миллионы) и проверили на них даже усиленные версии гипотезы. А Alspach, Goddyn и Zhang ещё в 1994 году доказали CDC для всех графов, не содержащих граф Петерсена в качестве подграфа.
Проблема была в том, что все эти результаты обходили стороной “ядро” задачи, и общий случай не поддавался никому больше полувека. В обзоре открытых проблем CDC всегда была в статусе “outstanding open problem”, а Франсуа Джегер в обзоре 1985 года называл её одной из главных открытых задач теории графов. Так что здесь, как и в случае единичных расстояний, нет сомнений, что умные люди над этой задачей действительно думали, и немало.
Почему достаточно кубических графов, или охота на снарка
Начну с классических результатов; они одновременно позволят существенно сузить условие задачи и дадут некоторую интуицию происходящего.
Первое стандартное рассуждение в этой области — свести всё к кубическим графам, то есть графам, где у каждой вершины ровно три инцидентных ребра.
Рассуждение такое. Возьмём минимальный (по числу вершин, потом рёбер) контрпример к гипотезе. Вершин степени 0 и 1 в нём нет (изолированная вершина не мешает, а висячее ребро — это мост).
Вершину степени 2 можно “разгладить”: заменить два её ребра одним (то есть удалить вершину), найти двойное покрытие меньшего графа (он меньше минимального контрпримера, значит, покрытие у него есть) и вернуть вершину на место, удлинив проходящие циклы. Значит, вершин степени 2 в минимальном контрпримере быть не может.
А вершину степени 4 и больше можно расщепить — раздуть в маленький цикл из вершин степени 3:
При этом каждый цикл нового графа проецируется в замкнутый маршрут старого (достаточно стянуть раздутый цикл обратно в точку), и из двойного покрытия нового графа получается двойное покрытие старого.
Единственная тонкость здесь в том, что расщеплять надо аккуратно, чтобы не создать мост. То, что это всегда возможно, — стандартная лемма о расщеплении вершин (vertex splitting lemma), известная уже очень давно (Fleischner, 1992). Так что получается, что если гипотеза верна для кубических графов без мостов, она верна вообще для всех графов без мостов.
Петли в кубическом графе тоже невозможны: вершина с петлёй занимает ею две из своих трёх “валентностей”, и третье ребро автоматически оказывается мостом.
Кубические графы и три цвета. А для кубических графов есть свой отдельный инструмент — рёберные раскраски. Правильная рёберная 3-раскраска — это раскраска рёбер в три цвета так, чтобы в каждой вершине сходились три ребра трёх разных цветов. По классической теореме Визинга хроматический индекс простого кубического графа равен 3 или 4, то есть все кубические графы делятся на трёхцветные и четырёхцветные.
Ещё Секереш в той самой статье 1973 года заметил: если кубический граф без мостов рёберно 3-раскрашиваем, то двойное покрытие у него есть. Конструкция очень простая: возьмём два цветовых класса, скажем красный и синий. В каждой вершине есть ровно одно красное и ровно одно синее ребро, поэтому красно-синее объединение — это подграф, в котором все степени равны 2, то есть дизъюнктное объединение циклов (чётной длины, цвета чередуются). Вот как это выглядит на призме:
Таких двуцветных объединений три: красный+синий, красный+зелёный, синий+зелёный. Каждое ребро, будучи, скажем, красным, попадает ровно в два из них. Вот и двойное покрытие!
Снарки. Значит, минимальный контрпример к CDC — это кубический граф без мостов, который нельзя рёберно раскрасить в 3 цвета. Такие графы (с дополнительными условиями невырожденности: обхват не меньше 5 и цикловая 4-связность, чтобы не считать тривиальные модификации) называются снарками — в честь того самого неуловимого зверя из поэмы Льюиса Кэрролла.
Название предложил, кстати, известный популяризатор математики Мартин Гарднер в 1976 году, и оно тогда хорошо подходило: снарки действительно долгое время были почти неуловимы.
Первый и главный снарк человечество нашло ещё в 1898 году — это граф Петерсена из десяти вершин и пятнадцати рёбер, главный контрпример всея теории графов.
Проверить, что он не 3-раскрашиваем по рёбрам, — хорошее упражнение (подсказка: рёбра, не попавшие в один цветовой класс, образуют объединение циклов чётной длины, а все 2-факторы графа Петерсена — это пары пятиугольников).
Второй снарк нашёлся только в 1946 году (Blanuša, 1946), а бесконечные семейства снарков построил Isaacs (1975); вот, например, его “цветок” :
Здесь синий внутренний пятиугольник и длинный красный десятиугольник соединены пятью “тройниками”-звёздочками, и такая конструкция работает для любого нечётного числа лепестков, начиная с пяти.
Но здесь важно отметить, что снарки являются контрпримерами к раскрашиваемости, а не к двойному покрытию. У графа Петерсена двойное покрытие есть, симметричное и красивое — шесть пятиугольников:
(Это, кстати, как раз грани вложения графа Петерсена в проективную плоскость, так что здесь снова появляется топология.)
Но конструкция Секереша для снарков не работает, и нужно было придумать что-то другое.
За полвека в теории графов сложился целый небольшой жанр: свести какую-нибудь гипотезу к снаркам и убедиться, что на всех известных снарках она верна. Так устроены CDC, гипотеза Фулкерсона о совершенных паросочетаниях, гипотеза Татта о 5-потоках… все дороги ведут к графу Петерсена, но дальше обычно не двигаются.
Язык потоков
Второй язык, на котором написано доказательство, — это потоки Татта. Это куда более классический объект, и с ним вы, вероятно, знакомы, но на всякий случай поясню. Идея пришла из физики: представьте, что по рёбрам графа течёт ток, и давайте введём там правила Кирхгофа. Вы наверняка слышали о потоках в контексте задачи о максимальном потоке:
Но нам сейчас нужно чуть более общее определение.
Определение. Зафиксируем на каждом ребре произвольное направление (стрелочку) и абелеву группу . -поток — это функция , приписывающая каждому ребру элемент группы так, что в каждой вершине выполняется закон Кирхгофа: сумма значений на входящих рёбрах равна сумме на исходящих. Поток называется нигде не нулевым (nowhere-zero, NZ-flow), если на каждом ребре. Чтобы перевернуть стрелочку на ребре, достаточно заменить на , поэтому существование нигде не нулевого потока от выбора стрелочек не зависит.
Татт в 1954 году доказал классический, но всё равно довольно удивительный факт: количество нигде не нулевых -потоков зависит не от структуры группы , а только от её размера (и является многочленом от — “потоковым многочленом”). Поэтому говорят просто о -потоках: есть нигде не нулевой поток в какой-нибудь группе размера — значит, есть в любой другой того же размера (а значит, и целочисленный поток со значениями , это тоже эквивалентная формулировка). На практике это развязывает руки: группу можно выбирать поудобнее.
Зачем всё это нужно? Затем, что для планарных графов нигде не нулевые потоки — это в точности раскраски: граф без мостов, нарисованный на плоскости, имеет правильную раскраску граней в цветов тогда и только тогда, когда у него есть нигде не нулевой -поток (цвета — элементы , поток на ребре — разность цветов слева и справа).
Знаменитая теорема о четырёх красках на этом языке звучит так: у всякого планарного графа без мостов есть нигде не нулевой 4-поток. Но при этом потоки определены для любых графов, не только планарных!
Татт предположил, что от планарности можно почти избавиться: его гипотеза о 5-потоках (“у всякого графа без мостов есть нигде не нулевой 5-поток”) известна с 1954 года и остаётся открытой проблемой до сих пор.
теорема о 6-потоках (Seymour, 1981): и даже 6-поток тоже есть.
Потоки над — это чётные подграфы. Теперь выберем группу поудобнее. Пусть — векторы из трёх бит со сложением по модулю 2 (XOR); их восемь: от до . В этой группе , так что стрелочки вообще не нужны: условие Кирхгофа в вершине просто говорит, что XOR значений на инцидентных рёбрах равен нулю.
Теорема о 8-потоках говорит, что рёбра любого графа без мостов можно пометить ненулевыми трёхбитовыми векторами так, чтобы в каждой вершине XOR сходился в ноль. Именно в таком виде мы её и будем использовать.
У потоков над есть наглядная интерпретация. Посмотрим на один бит потока, скажем, первый: рёбра, где он равен 1, образуют подграф, в котором каждая вершина имеет чётную степень (иначе XOR не сойдётся) — так называемый чётный подграф. А чётный подграф — это всегда объединение рёберно-непересекающихся циклов. То есть -поток — это система из чётных подграфов, а условие “нигде не нулевой” значит, что они вместе покрывают все рёбра.
Для кубических графов случай особенно нагляден: нигде не нулевой -поток — это то же самое, что рёберная 3-раскраска. Ненулевых значений три: , , ; в каждой вершине они обязаны встретиться по одному разу (единственный способ получить нулевой XOR из трёх ненулевых значений — взять все три разных). Вот наша призма ещё раз, теперь через потоки:
Конструкция Секереша тоже переводится на язык потоков и обобщается с кубических графов на любые: если у графа есть нигде не нулевой 4-поток со значениями в , рассмотрим три подграфа:
первый бит равен 1,
второй бит равен 1,
XOR битов равен 1.
Каждый из них чётный, а каждое ребро попадает ровно в два: из трёх вариантов “первый бит”, “второй бит”, “их XOR” на любом ненулевом значении ровно два истинны.
Получается, что нигде не нулевой 4-поток влечёт двойное покрытие циклами — это классический результат, известный с 1970-х годов. Но проблема остаётся всё та же: у снарков как раз 4-потока и нет (для кубических графов это эквивалентно 3-раскрашиваемости).
От четырёх к двум. А что даёт гарантированный теоремой Джегера–Килпатрика 8-поток со значениями в ?
Повторим тот же трюк: у есть 7 ненулевых линейных функционалов (способов “свернуть” три бита в один: первый бит, второй, XOR первого и третьего и так далее), и каждый из них даёт чётный подграф .
Но теперь каждое ребро попадает не в два, а ровно в четыре подграфа из семи: значение фиксировано, и из 8 функционалов (включая нулевой) на нём не зануляется ровно половина. Получается покрытие циклами, где каждое ребро покрыто ровно четыре раза. Вот как это выглядит на графе Петерсена:
В первой панели — нигде не нулевой поток (именно этот поток ещё появится в конце поста), в остальных семи — носители семи функционалов . Каждая панель — чётный подграф, то есть объединение непересекающихся циклов. А кружком во всех панелях отмечено одно и то же ребро, со значением потока : оно выделено ровно в четырёх панелях, при — ровно для тех , для которых . И так с каждым ребром.
Такие конструкции подробно изучали Bermond, Jackson, Jaeger(1983) — покрытия чётными подграфами с предписанными кратностями; с этими учёными мы ещё встретимся ниже.
Итак, мы можем покрыть каждое ребро четыре раза. А надо — дважды. Так что вся гипотеза CDC, по сути, состоит в том, чтобы сделать этот шаг от четырёхкратного покрытия к двукратному.
Первый шаг: у каждого ребра два цвета
Теперь сам препринт. Его конструкцию я изложу полностью, со всеми доказательствами, но своими словами; сверяться можно с оригиналом — там всё уместилось в две страницы.
Благодаря тому, что мы обсудили выше, мы уже понимаем, что достаточно разобраться с кубическими графами без петель (с кратными рёбрами), у которых есть нигде не нулевой поток со значениями в группе .
Ключевая идея — новая переформулировка того, что мы ищем. Будем считать восемь элементов цветами. В конструкции Секереша каждое ребро получало один цвет из трёх; теперь каждое ребро получит пару из двух различных цветов; цвета по-прежнему являются элементами .
То есть у каждого ребра теперь два цвета. Потребуем выполнения одного локального условия:
Вокруг каждой вершины каждый цвет встречается в парах инцидентных рёбер 0 или 2 раза.
Представьте, что каждый цвет — это нитка своего цвета, и ребро несёт на себе две нитки: цветов и из его пары. Тогда условие говорит, что в каждой вершине нитку любого цвета можно “пропустить насквозь”: цвет либо вообще не заходит в вершину, либо заходит по одному ребру и выходит по другому. А нитка, которая нигде не обрывается, обязана замыкаться в циклы:
Лемма 1 (лемма 2.1 препринта). Если такая расстановка пар существует, то у графа есть двойное покрытие циклами.
Доказательство. Для каждого цвета соберём подграф из всех рёбер, у которых в паре найдётся . Локальное условие говорит, что у каждой вершины в степень 0 или 2. Значит, — дизъюнктное объединение циклов. А каждое ребро лежит ровно в двух подграфах , потому что в паре два элемента. Теперь соберём циклы всех восьми подграфов вместе, и готово: каждое ребро покрыто дважды.
Это можно увидеть на конструкции Секереша: если у нас есть рёберная 3-раскраска, давайте зафиксируем два ненулевых элемента и выдадим красным рёбрам пару , синим — , зелёным — . Вокруг каждой вершины (где по одному ребру каждого цвета) элемент встречается дважды (красное и синее ребро), дважды (красное и зелёное), дважды (синее и зелёное).
Так что лемма 1 — это “ослабленная 3-раскраска”: цветов теперь восемь, у каждого ребра их два, и правило согласования вокруг вершины более слабое (более гибкое).
Весь вопрос в том, как построить такую расстановку пар для снарков, где честной раскраски нет.
Второй шаг: строим пары из потока
Первый шаг, хотя и содержал уже ключевую идею, но по сути был переформулировкой классических результатов. А теперь начинается собственно новизна в доказательстве GPT 5.6.
Пусть — нигде не нулевой -поток; он есть по теореме о 8-потоках. Посмотрим на произвольную вершину . У неё три ребра; обозначим их (порядок выберем произвольно и зафиксируем), а значения потока на них обозначим через , , .
Условие Кирхгофа говорит, что , то есть
(напомню, что мы в , где плюс — это XOR, и минусов нет).
Все три значения ненулевые, и легко видеть, что они попарно различны: если бы, скажем, было верно, что , то мы бы получили . Кстати, отсюда же видно, что множество замкнуто относительно сложения, то есть это двумерное подпространство в ; эта деталь ещё сыграет ниже.
Теперь выберем элемент — “базовый цвет” вершины — и раздадим трём рёбрам вокруг следующие пары:
Проверим локальное условие: цвет встречается в парах рёбер и (дважды), цвет — в парах и (дважды), цвет — в парах и (дважды), а больше никакие цвета не встречаются вовсе. Все три цвета , , различны (поскольку и оба ненулевые), так что всё честно: вокруг каждый цвет встречается 0 или 2 раза. Итого получаем, что локальное условие выполнено.
Полезно записать эти пары единообразно. Введём сдвиги — по одному на каждую пару (вершина, инцидентное ребро):
и тогда все три пары выше — это пары вида
Действительно: для получаем ; для — ; для — . То есть пара ребра — это “базовый цвет вершины, сдвинутый на , плюс тот же цвет, сдвинутый ещё и на значение потока”.
Вот иллюстрация, слева в общем виде, справа с конкретными числами:
Заметьте, что вся конструкция локальная, и в каждой вершине свой произвольный базовый цвет . Это богатое семейство потенциальных раскрасок: в каждой вершине 8 вариантов , плюс ещё свобода в выборе порядка рёбер , который определяет сдвиги .
Проблема склейки. Но у ребра два конца! Вершина предлагает ему пару , вершина — пару . Чтобы расстановка пар была определена корректно, эти две пары должны совпасть на каждом ребре графа одновременно:
Обе пары имеют вид и с одинаковым “шагом” .
Когда такие пары совпадают как множества? Либо , либо (тогда множества совпадают “крест-накрест”); одной формулой это можно записать как .
Подставляя наши и и обозначая , получаем, что пары на ребре согласованы тогда и только тогда, когда для какого-нибудь выполняется равенство
И вот мы пришли к ключевому шагу доказательства.
Сдвиги и “невязки” — известные величины, они вычисляются по потоку и выбранным порядкам рёбер. А базовые цвета (по три бита на вершину) и переключатели (по биту на ребро) — неизвестные.
Всё написанное выше — это система линейных уравнений над полем , по три битовых уравнения на каждое ребро. Осталось доказать, что она всегда имеет решение.
Лемма 2 (лемма 2.2 препринта). Система склейки разрешима для любого кубического графа без петель, любого нигде не нулевого -потока и любого выбора порядков рёбер (то есть сдвигов ).
Интермедия: вся конструкция на примере
Прежде чем доказывать разрешимость в общем виде, давайте посмотрим на все наши объекты на конкретном примере, а именно на самом маленьком кубическом графе, полном графе . Он, конечно, не снарк, и для него всё можно было бы сделать по Секерешу, но механика конструкции здесь видна хорошо. Берём нигде не нулевой поток:
На картинке сверху поток изображён слева: в каждой вершине XOR трёх значений равен (проверьте!). Справа — сдвиги и невязки . Скажем, в вершине мы упорядочили рёбра как , , , поэтому по определению сдвигов , а два других сдвига в этой вершине нулевые; и так возле каждой вершины появляется ровно по одному ненулевому сдвигу. Невязка ребра — это XOR сдвигов с двух его концов: например, у ребра получается (сдвиг со стороны вершины и сдвиг со стороны вершины ), а у ребра оба сдвига нулевые, и .
Теперь выписываем систему склейки — шесть уравнений, по одному на ребро — и решаем её (хоть методом Гаусса, хоть просто подбором):
Наше решение выдаёт вершинам и базовый цвет , вершинам и — цвет , а на рёбрах и добавляет переключатель (это те рёбра, где пары с двух концов совпадают “крест-накрест”).
Подставляя найденные в формулу для пар, получаем расстановку, в которой вокруг каждой вершины каждый цвет встречается 0 или 2 раза; теперь можно собирать подграфы . Непустых получается четыре:
Узнаёте? Это в точности четыре треугольные грани планарного рисунка , с картинки, с которой начинался этот пост. Наша конструкция, начав с потока, сама пришла к вложению графа в плоскость. Конечно, для планарного графа в этом ничего нового или интересного нет, но подчеркну ещё раз: самой конструкции всё равно, планарен граф или нет — для графа Петерсена она точно так же выдаст двойное покрытие, и мы его ещё увидим ниже.
А теперь вернёмся к самой лемме, но прежде чем её доказывать, оценим ситуацию. Неизвестных у нас битов, где — число вершин, — число рёбер; уравнений . Для кубического графа , поэтому : система квадратная! Но радоваться рано, потому что она очевидно вырожденная; например, прибавить ко всем одну и ту же константу эквивалентно тому, чтобы ничего не изменить, ведь все уравнения зависят только от сумм .
Значит, у однородной системы есть нетривиальное ядро, а значит, отображение “неизвестные левые части” не сюръективно, и не всякая правая часть достижима.
Лемма утверждает, что конкретная правая часть , происходящая из потока, достижима всегда. Здесь, очевидно, должно сыграть какое-то специальное свойство ; и этим свойством окажется чётность.
Шаг 3: чудо чётности
Когда система линейных уравнений (где — вектор из всех наших неизвестных) неразрешима? Когда из уравнений выводится противоречие: можно так скомбинировать уравнения (над — просто выбрать подмножество и сложить), чтобы слева всё сократилось в тождественный ноль, а справа остался не ноль.
Классическая линейная алгебра (в функциональном анализе это называют альтернативой Фредгольма, в конечномерном случае это просто утверждение ) говорит, что это единственная возможная причина неразрешимости:
Система разрешима всякая комбинация уравнений, зануляющая левую часть, зануляет и правую.
Разберёмся, как выглядят “комбинации уравнений”. Это единственная действительно техническая часть доказательства, и в целом её можно пропустить. Но я бы рекомендовал всё-таки разобраться, потому что хоть она и техническая, но на удивление простая для доказательства знаменитой открытой проблемы.
На каждое ребро приходится три битовых уравнения (по числу бит в ), и выбрать их подмножество с последующим сложением — это то же самое, что применить к обеим частям векторного уравнения ребра линейную функцию .
Так что комбинация уравнений всей системы — это набор функций , по одной на ребро (в том числе здесь может быть тождественно нулевая функция, которая значит “уравнения этого ребра не берём”).
Комбинация зануляет левую часть, если после сложения исчезают все неизвестные:
коэффициент при : в левых частях входит в уравнения всех трёх рёбер вокруг , поэтому нужно, чтобы (как функция) для каждой вершины ;
коэффициент при : этот бит входит только в уравнение своего ребра с коэффициентом , поэтому нужно, чтобы для каждого ребра .
Назовём набор функций , удовлетворяющий этим двум условиям, препятствием. По альтернативе Фредгольма лемма 2 сводится к следующему: для всякого препятствия выполнено
То есть любое препятствие, занулив левую часть, обязано занулить и правую; если это так, то противоречия не выведешь, и система разрешима.
Локальный анализ. Зафиксируем вершину с рёбрами и потоками и посмотрим, что условия препятствия говорят локально. Во-первых,
Во-вторых,
Обозначим и вычислим:
откуда ; обозначим это значение через .
Теперь заметим, что вклад вершины в интересующую нас сумму легко выражается через . Мы ведь знаем, что , поэтому — это просто перегруппировка слагаемых по концам рёбер (здесь используется, что петель нет: у каждого ребра два разных конца).
А вокруг сдвиги почти все нулевые: , , так что
Ключевое наблюдение. Утверждается, что — это чётность числа ненулевых функционалов среди . Проверим оба случая.
Случай . Тогда зануляется и на , и на (мы только что доказали, что ), то есть зануляется на всём подпространстве — помните, я обещал, что мы его ещё встретим?
Аналогично, зануляется на (на по определению , на по условию препятствия), и тогда тоже.
Но — двумерное подпространство трёхмерного пространства , и функционалы, зануляющиеся на нём, образуют одномерное пространство: нулевой и ровно один ненулевой; назовём его . Значит, каждый из — это либо , либо ; а поскольку их сумма равна нулю, встречается среди них чётное число раз: ноль или два. Итого получили, что чётность ненулевых равна 0, и это совпадает с .
Случай . Выпишем значения функционалов на базисе подпространства : у это , у — , у — . Все три ненулевые (что бы функционалы ни делали на третьей координате). Ненулевых три, чётность 1, то есть опять всё сходится.
Финальный аккорд. Складываем по всем вершинам:
Но в последней сумме каждое ребро с посчитано ровно два раза — по разу на каждом конце! Это тот же самый двойной подсчёт, которым первокурсникам доказывают “лемму о рукопожатиях” о том, что сумма степеней вершин в графе чётна.
Значит, сумма чётна, то есть равна нулю в . Это значит, что любое препятствие зануляет правую часть, то есть система склейки разрешима, расстановка пар существует, и по лемме 1 двойное покрытие циклами есть.
Вот и всё доказательство. Давайте перечислим, что мы использовали:
сведение к кубическим графам — стандартный факт из середины 1980-х;
теорема о 8-потоках Килпатрика–Джегера — оттуда же;
собственно новые конструкции — переформулировка с парами цветов, локальный анализ из потока и лемма о разрешимости системы, где нет ничего, кроме линейной алгебры над и подсчёта чётности.
Ни перебора случаев, ни ста страниц выкладок, ни теории, выходящей за пределы обычного курса теории графов. Конечно, я мог что-то пропустить, но кажется, что ошибке тут прятаться особо негде.
Проверяем руками и кодом
Думаю, многие сядут разбирать препринт с мыслью “где-то здесь должна быть ошибка”: у CDC длинная история ложных доказательств, а тут двухстраничное решение полувековой открытой проблемы. Мы с вами прошли по каждому переходу, и я честно не нашёл, к чему придраться. Использованные внешние результаты (сведение к кубическим графам и 8-поток) общеизвестны и многократно передоказаны в учебниках.
Но у этого доказательства есть свойство, которое сильно упрощает если не его проверку, то уж точно перебор примеров: оно конструктивное. По графу и потоку строится конкретная система линейных уравнений; её можно решить хоть бы и методом Гаусса, получая пары, из пар — подграфы , из них — циклы.
Каждый шаг доказательства выше можно запрограммировать, а каждое промежуточное утверждение — проверить assert’ом: что пары с двух концов ребра совпали, что вокруг каждой вершины каждый цвет встречается 0 или 2 раза, что распадаются в циклы, что каждое ребро покрыто ровно дважды. Если бы в доказательстве леммы 2 был изъян, то на каком-нибудь графе с каким-нибудь потоком система оказалась бы неразрешимой, и мы бы смогли обнаружить.
Мы с Claude Code попробовали перебрать кое-какие классические примеры. Что проверялось:
граф Петерсена: у него ровно 28 560 нигде не нулевых -потоков, и мы перебрали все (плюс случайные перестановки локальных порядков рёбер); система разрешима всегда, покрытие корректно всегда;
снарки: цветки Айзекса , граф Титце, граф Петерсена с раздутыми в треугольники вершинами (это стандартный способ плодить нераскрашиваемые кубические графы) — проверили десятки случайных потоков на каждом;
мультиграфы с кратными рёбрами: тета-граф (две вершины, три параллельных ребра), кольца из двойных рёбер и случайные кубические мультиграфы; тем самым мы проверили, что у леммы всё в порядке и с циклами длины 2;
классические примеры: куб, графы Хивуда, Паппа, Дезарга, додекаэдр — проверили по полсотни случайных потоков; а на совсем маленьких графах (, , призма, мультиграфы выше) снова запустили полный перебор всех нигде не нулевых потоков;
случайные кубические графы до 200 вершин, порядка двухсот штук;
и отдельно на маленьких графах мы брутфорсом перечислили все линейные зависимости системы и убедились, что они ровно те, что описаны в доказательстве (условия-“препятствия”), и что все они зануляют правую часть.
Итого мы сделали более тридцати пяти тысяч запусков конструкции, и не нашли ни единого сбоя. Вот как результат выглядит на графе Петерсена; слева нигде не нулевой поток (тот самый 8-поток, помеченный битовыми строками), справа — пары, которые выдало решение системы склейки:
А вот восемь подграфов — двойное покрытие, построенное по этим парам:
Каждое ребро выделено ровно на двух панелях из восьми; три подграфа оказались пустыми. В этом примере покрытие состоит всего из пяти циклов: два пятиугольника, внутренняя пентаграмма, шестиугольник и один длинный цикл длины 9.
А вот пример побольше, цветок Айзекса ; слева его покрытие, а справа уже совершенно нечитаемый случайный кубический граф:
И вот покрытие для цветка Айзекса в читаемом виде:
Разумеется, ни моя проверка, ни прогоны кода не заменяют настоящего рецензирования — это просто иллюстрации. Но доказательство такого размера и такой элементарности сообщество проверяет быстро, а ещё оно прямо-таки напрашивается на формализацию в Lean: два классических факта плюс три страницы линейной алгебры. Не удивлюсь, если к моменту, когда вы это прочитаете, формализация уже будет готова.
Промпт как исторический документ
Теперь о том, как доказательство было получено и что происходило вокруг.
OpenAI опубликовала полный промпт, которым запускали GPT 5.6 Sol Ultra, и это довольно любопытное чтение. Модели было доступно до 64 параллельных субагентов, и промпт в основном состоит из инструкций, как управлять этим роем. Например (перевод мой):
Начните с по-настоящему разнообразного портфеля подходов. <…> Не сообщайте большинству агентов текущий предпочтительный подход. Сохраняйте независимость в ранних раундах, чтобы агенты не сошлись все к одной и той же привлекательной, но неполной редукции. < … >
Используйте конкурентных агентов (adversarial agents) на всём протяжении доказательства: каждый кандидат в доказательство должен проверяться на точную двукратность покрытия, на замкнутые маршруты с повторными рёбрами, маскирующиеся под циклы, на двуциклы из параллельных рёбер, на несвязные графы, на точки сочленения, на мосты, привнесённые редукциями, и на циклическое использование утверждения, эквивалентного самой CDC.
Отклоняйте отчёты о статусе, расплывчатый оптимизм и заявления, что недоказанное глобальное утверждение о согласованности — это “рутина”.
Последний пункт особенно хорош: “глобальное утверждение о согласованности” — это как раз лемма 2, и промпт заранее запрещает модели объявить её очевидной. Очевидно, такой failure mode авторы промпта видели на практике.
Отмечу ещё пару строк. Промпт прямо инструктирует модель: “Assume for purposes of this task that a complete affirmative proof exists” — “считайте, что полное доказательство существует”. Кроме того, он отдельно запрещает модели лезть в интернет проверять статус задачи и отвечать “это открытая проблема”.
То есть авторы промпта целенаправленно запрещали модели использовать её (уже наверняка имеющееся) знание о том, что CDC не решена, — иначе она, как любая хорошо выдрессированная LLM, вежливо отказалась бы её решать.
И вот ещё один крутой штрих: “Spend at least 8 hours on this before even thinking of returning or giving up” — “потратьте хотя бы 8 часов, прежде чем даже думать о том, чтобы сдаться”. Говорят, что модель управилась меньше чем за час.
В треде на Hacker News прикинули стоимость такого запуска — оценки примерно от 13000 в зависимости от предположений о железе. Согласитесь, что за решение полувековой важной проблемы это в любом случае недорого.
И ещё одно наблюдение оттуда же: удивительно, насколько большая часть промпта уходит на то, чтобы просто заставить модель действительно решать задачу, а не отчитываться о трудностях. Это довольно любопытный эффект, и хотя с моим личным опытом он пока не сходится, как знать, что нас ждёт в ближайшем будущем…
Реакции: “could have been discovered in the 1980s”
Первым из известных математиков подробно отреагировал Томас Блум — тот самый хранитель erdosproblems.com, которого мы встречали и в истории с единичными расстояниями. В треде на X он пишет, что это “a very nice proof” — короткое, элементарное и такое, которое “могло быть найдено в 1980-х”. Он пишет, что никакой новой техники в нём нет, есть “небольшой контринтуитивный поворот” поверх хорошо известных идей.
Вся критика Блума сводится к оформлению: препринт не цитирует работы, из которых выросли его ключевые идеи, в первую очередь ту самую статью Бермона, Джексона и Джегера 1983 года (о ней мы говорили выше: именно там развита техника покрытий чётными подграфами, дающая, в частности, то самое четырёхкратное покрытие каждого ребра, которое новое доказательство наконец “делит пополам”). Как пишет the-decoder:
This is a frequent issue with AI-generated proofs and papers: they use ideas and proof strategies taken from the literature without proper citation.
Это действительно известный недостаток, и дословно ту же претензию Мелани Мэтчетт Вуд предъявляла к работе про единичные расстояния (я подробно писал об этом тогда): модель “знает” большой объём литературы, и ей трудно отличить выученную идею от порождённой. Полностью корректная расстановка ссылок — пока не до конца решённая проблема AI-математики. Впрочем, как вы понимаете, это не то чтобы серьёзная критика.
А ещё, разумеется, на HackerNews тут же высказались о характере доказательства: это ловкий трюк, который каким-то образом ускользнул от всех экспертов, а не построение новой теории. Настоящей вехой, как пишет один из комментаторов, будет момент, когда AI-модель решит проблему, требующую создания новой теории на десятки страниц.
Ну что тут скажешь… Я много раз уже писал и рассказывал про moving the goalposts в AI. В науке с этим даже хуже, чем в более прикладных областях.
Почему же люди это пропустили? Дальше моя личная гипотеза, я на ней не настаиваю. Но мне кажется, что всё дело в направлении атаки.
Классический путь от 8-потока к покрытиям — через носители функционалов: семь чётных подграфов, каждое ребро в четырёх, и эту четвёрку действительно никак не сократить вдвое. Здесь стена, и логично, что это направление считалось тупиковым.
Новый ход от GPT состоял в том, чтобы отдать каждому ребру не значения функционалов, а пару элементов группы, причём пару, определённую с точностью до локального сдвига . И вся проблема согласования раскраски сводится к одной глобальной линейной системе уравнений.
После этого остаётся ещё “чудо чётности” из леммы 2; его, пока не выпишешь систему, просто неоткуда увидеть.
Это очень похоже по духу на доказательства самих теорем о 6- и 8-потоках: короткое прямое применение линейной алгебры, которая непонятно почему должна была сработать, но сработала.
Такие доказательства легко потерять проверить и очень сложно найти. Человек-эксперт скорее будет заниматься более многообещающими направлениями, а модель с 64 субагентами и восемью часами машинного времени может позволить себе копать там, где эксперт даже не остановился бы.
Как заметил Якоб Цимерман по поводу прошлого результата, AI-системы “may play for longer and in more treacherous waters than mathematicians without getting overwhelmed”. Похоже, это и есть новая суперспособность текущих AI-систем: не гениальность, а невозмутимость и последовательность.
Что остаётся открытым
Итак, GPT решил важную открытую проблему. Но это не значит, что теория графов лишилась своего святого Грааля и теперь станет мёртвой наукой. CDC была узлом в целой сети гипотез о кубических графах и снарках, и большинство узлов этой сети всё ещё остаются открытыми.
Гипотеза Татта о 5-потоках (1954): у всякого графа без мостов есть нигде не нулевой 5-поток. Новое доказательство её не задевает: между 5-потоками и CDC нет известных импликаций ни в одну сторону, это соседние, но независимые вершины в сети гипотез.
Berge–Fulkerson conjecture (1971): в каждом кубическом графе без мостов найдутся шесть совершенных паросочетаний, покрывающих каждое ребро ровно дважды. Это родная сестра CDC (тоже “каждое ребро ровно дважды”, только теперь паросочетаниями), и она по-прежнему открыта.
Гипотеза Джегера о петерсеновской раскраске: рёбра любого кубического графа без мостов можно “покрасить рёбрами графа Петерсена” с сохранением смежности. Это утверждение влечёт и CDC, и гипотезу Фалкерсона, так что теперь оно стало чуть менее недосягаемым по последствиям, но само по себе всё ещё не доказано.
Ориентируемая CDC: можно ли всегда найти двойное покрытие, циклам которого можно придать направления так, чтобы каждое ребро проходилось два раза в противоположных направлениях? (Для покрытий из граней вложения в ориентируемую поверхность это так.)
Малые покрытия: гипотеза о том, что всегда достаточно покрытия, циклы которого группируются в 5 чётных подграфов. Конструкция из препринта даёт 8 подграфов , но от восьми до пяти может быть ещё очень далеко.
Круговые вложения: та самая топологическая гипотеза, из которой CDC следовала; теперь следствие доказано, а причина — нет, и это отдельный интересный вопрос.
Так что у специалистов по снаркам работы не убавилось, скорее наоборот: интересно будет посмотреть, какие из “соседних” утверждений окажутся принципиально сложнее, а какие тоже падут в ближайшем будущем.
Заключение
Итого получается вот какая картина. Гипотеза о двойном покрытии циклами имела 50-летнюю историю и статус “одной из главных открытых проблем теории графов”. И вот на днях она получила короткое, элементарное, конструктивное доказательство, которое, по утверждению OpenAI, полностью придумала модель GPT 5.6 Sol Ultra за час работы 64 параллельных агентов.
Препринту три дня, формальной верификации сообществом пока нет, но доказательство настолько короткое и простое, что проверить его может каждый — я проверил и вручную, и кодом на примерах (не без помощи AI-ассистентов, разумеется, куда уж теперь без них).
В мае мы получили опровержение гипотезы Эрдёша о единичных расстояниях, а в июле — доказательство CDC. Оба результата устроены одинаково: здесь не развивается новая мощная теория, но происходит некоторый неожиданный поворот поверх классических инструментов, найденный там, куда эксперты не смотрели, потому что направление “было понятно, что не работает”.
Я не знаю, сколько ещё знаменитых задач имеют решения такого типа — короткие, но контринтуитивные. Судя по скорости прогресса, мы скоро узнаем: похоже, тот самый систематический поиск “низко висящих фруктов” в математике, о котором я говорил в последний год, уже идёт полным ходом.
Если у вас есть любимая гипотеза, в которую вы верите, самое время написать про неё хороший промпт.
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
Один из отцов глубокого обучения Ян Лекун уже несколько лет повторяет тезис, который в эпоху всеобщего восторга от LLM звучит слегка еретически: авторегрессионные большие языковые модели — это тупик на пути к интеллекту человеческого уровня. Не просто “не самый лучший путь”, а именно тупик; по мнению Лекуна, одним только масштабированием предсказания следующего токена мы до настоящего понимания мира не доедем. Он, конечно, видит, что по дороге в этот тупик языковые модели успевают, например, опровергать гипотезы Эрдёша, но Лекуна это не убеждает.
Любимый его аргумент в том, что домашний кот моделирует физику окружающего мира лучше любой LLM, а подросток осваивает вождение примерно за двадцать часов практики без синтетического RL-окружения, потому что у него уже есть модель мира, в которой можно “прокрутить” последствия поворота руля, не вылетая при этом в кювет по-настоящему.
В этом посте я хочу рассказать, на что Лекун ставит вместо языковых моделей, и заодно дать общее введение в тему, проследив по сути одну и ту же идею через тридцать лет её истории, от сиамских сетей 1993 года до современных моделей мира (world models).
Технических деталей будет немало, будут и формулы, но я постараюсь, чтобы для каждого шага была видна интуиция, а отдельные кусочки складывались в единую, надеюсь, стройную картину. Пост получится длинный и довольно теоретический, в духе моих постов про термодинамику обучения и TurboQuant. Зато по дороге мы заодно обсудим много разных методов самообучения (self-supervised learning), потому что JEPA лучше всего понимать не как конкретное изобретение 2022 года, а как точку, в которой сходятся метрическое обучение (metric learning), контрастивное обучение (contrastive learning), маскированное моделирование (masked modeling) и модели мира (world models).
Сразу порекомендую пару других изложений: YouTube-канал Welch Labs выпустил двухчастный разбор под названием “Yann LeCun’s $1B Bet Against LLMs” (part 1, part 2), и сам Лекун его репостнул со словами “excellent tutorial video”. Кроме того, есть подробный текстовый разбор Рохита Бандару, названием которого я надеюсь закрыть сразу все очевидные для русского уха шутейки. Согласитесь, лучше уже не придумаешь: “Deep Dive into Yann LeCun’s JEPA“. Пост, кстати, отличный; но мы с вами посмотрим шире и пойдём по первоисточникам.
Аббревиатура JEPA расшифровывается как Joint-Embedding Predictive Architecture, “предсказательная архитектура с совместными вложениями”. И главная мысль во всём этом ровно одна:
Обучение идёт через предсказание представлений (извлечение абстрактного смысла) того, чего ты не видишь, а не через пиксели или токены. Хорошая абстракция здесь не аппроксимация, а суть: разумно устроенная система должна уметь выбрасывать то, что предсказать невозможно или незачем.
Звучит как философия, и в манифесте 2022 года (LeCun, 2022) это действительно подано довольно абстрактно. Но та же идея возникла ещё за тридцать лет до аббревиатуры JEPA, а вскоре после постановочной статьи стали появляться варианты этих моделей, хорошо решающие весьма практические задачи. В этом посте мы обсудим весь этот долгий путь.
Главная мысль за пять минут
Прежде чем нырять в историю, давайте зафиксируем основную идею в более практически применимой форме. Одна и та же мысль повторяется на протяжении всей 30+-летней истории:
Возьми два вида одного и того же кусочка мира, прогони каждый через (возможно, общий) кодировщик и выстрой геометрию двух полученных векторов друг относительно друга.
От эпохи к эпохе меняются относительно второстепенные вещи:
во-первых, что это за два вида: две подписи, два случайных кропа одной картинки, настоящее и будущее в видео, состояние и состояние после действия в RL;
во-вторых, как именно сравниваются вложения: через зазор (margin), через softmax по негативным примерам или через регрессию в латентном пространстве;
в-третьих, как не дать представлению сколлапсировать, то есть схлопнуться в константу, на которой любая “похожесть” становится тривиально идеальной; эта проблема, как мы увидим, окажется центральной для всего сюжета.
В терминологии Лекуна и его команды принято различать три семейства архитектур; это разделение лучше всего нарисовано на первой картинке статьи про I-JEPA (Assran et al., 2023):
Joint-Embedding Architecture (JEA): два кодировщика, на выходе которых должны получаться близкие векторы для совместимых друг с другом входов. Здесь главное инвариантность: “эти два вида должны иметь одно и то же представление”. Сюда попадают сиамские сети, контрастивные методы, BYOL — а если разрешить кодировщикам работать с разными модальностями, то и CLIP, о котором ниже.
Generative Architecture: модель напрямую восстанавливает сигнал, по видимой части картинки дорисовывает невидимую в пикселях. Сюда попадают автокодировщики, MAE, диффузионные модели, да и авторегрессионные LLM в широком смысле.
Joint-Embedding Predictive Architecture (JEPA): гибридный подход, в котором есть кодировщики, как у JEA, но добавлен предсказатель (predictor), который по представлению одного вида и описанию того, что мы предсказываем (позиция цели, сдвиг во времени, действие), достраивает представление другого вида. То есть мы переходим от “два представления должны быть одинаковыми” к чему-то вроде “из этого представления и этого отношения должно выводиться то представление”.
Разница между JEA и JEPA тонкая, но принципиальная: JEA требует, чтобы и были по сути взаимозаменяемы, отсюда и инвариантность к аугментациям, JEPA же позволяет и нести разную информацию. Контекст и цель не обязаны быть одним и тем же, но между ними есть отношение, и именно это отношение предсказатель должен выучить.
И сразу обещанный сквозной пример, одно «уравнение», которое будет эволюционировать через весь текст. На каждом шаге мы будем задавать себе один и тот же вопрос, только формулировка немного меняется:
сиамские сети: «эти две подписи (лица) — одного человека?»;
контрастивное обучение: «какой из кандидатов-видов совместим с этим контекстом?»;
методы без негативов: «предскажи представление учителя — без негативов»;
маскированное латентное предсказание: «что должен означать скрытый кусок, если смотреть на его окружение?»;
JEPA как модель мира: «какое латентное состояние следует из этого состояния и этого действия?»;
иерархическая JEPA: «что следует — на нескольких уровнях абстракции и нескольких масштабах времени?».
И вот таймлайн всего пути; на нём пять параллельных линий самообучения, каждая тянется слева направо и в конце концов сходится в JEPA-манифесте 2022 года.
Теперь — медленно, с самого начала.
Сиамские сети: как сравнивать, не называя
Историю принято начинать с 1993 года, но ещё за год до этого, в 1992, Сюзанна Беккер и Джеффри Хинтон опубликовали в Nature работу про самоорганизующуюся сеть, которая обнаруживает поверхности в случайно-точечных стереограммах (Becker, Hinton, 1992). Устроено это было так: два модуля сети смотрят на соседние участки изображения и учатся максимизировать взаимную информацию между своими выходами в расчёте на то, что у соседних участков есть общая скрытая причина (глубина поверхности).
Это уже явный предтеча всего дальнейшего по структуре: два кодировщика, общая скрытая цель, обучение через согласие. А идея, что хорошие признаки — это признаки, очищенные от избыточности, ещё старше: она восходит к принципу сокращения избыточности нейрофизиолога Хораса Барлоу (Barlow, 1961), а в нейросетевом виде её формулировал ещё тот самый Шмидхубер в виде predictability minimization (Schmidhuber, 1992), где детекторы признаков соревнуются с предсказателями, пытающимися их предсказать друг из друга. Мы ещё встретимся с Барлоу ниже, когда через тридцать лет метод Barlow Twins назовут именно в его честь.
А собственно история сиамских сетей начинается со статьи «Signature Verification using a “Siamese” Time Delay Neural Network» (Bromley et al., 1993; среди авторов, между прочим, был и сам Ян Лекун). Работа решала вполне прикладную задачу — проверить, что подпись на чеке настоящая, то есть сравнить имеющуюся подпись с настоящим образцом, но идея, которая оттуда выросла, оказалась куда долговечнее задачи.
Они взяли две одинаковые подсети с общими весами (отсюда и название “сиамские”), каждая из которых кодирует одну из подписей в вектор признаков, а потом измеряли расстояние между этими векторами:
Идея, разумеется, в том, чтобы потом считать маленькое расстояние подтверждением подлинности, а большое — подделки. Ключевая и совсем не очевидная на тот момент вещь здесь — это связывание весов (weight tying): обе ветви имеют одни и те же веса, то есть дают одну и ту же геометрию на выходе. Мы перестаём обучать классификатор (“это подпись Иванова”) и начинаем обучать геометрию пространства признаков. Это и есть то зерно, из которого выросло всё остальное.
Идея была не то чтобы забыта, но оставалась без развития добрый десяток лет. Только в середине 2000-х её оживила и обобщила группа всё того же Лекуна. Две работы, попавшие тогда на CVPR, сделали из “сиамского трюка” общий принцип дискриминативного метрического обучения (discriminative metric learning).
Сначала была “Learning a Similarity Metric Discriminatively” (Chopra, Hadsell, LeCun, 2005) про верификацию лиц на ровно той же сиамской идее:
А затем вышла, на мой вкус, одна из недооценённых классических статей: “Dimensionality Reduction by Learning an Invariant Mapping” (DrLIM; Hadsell, Chopra, LeCun, 2006). Именно там появляется контрастивная функция потерь (contrastive loss function) в её каноническом виде. Пусть пара объектов имеет метку ( — «похожи», — «не похожи»), а — расстояние между их вложениями; тогда
Первое слагаемое здесь работает на похожих парах и “тянет” их друг к другу. Второе работает на непохожих, отталкивая их до некоторого значения зазора (margin); дальше зазора отталкивать уже не нужно, и штраф обнуляется. Авторы, кстати, объясняли всё это на языке механики: похожие пары соединены пружинами, которые их стягивают, а непохожие — пружинами-отталкивателями, которые перестают действовать на расстоянии ; и в итоге вся конструкция должна релаксировать к равновесию, как физическая система.
Здесь, кстати, впервые ставится и решается проблема коллапса. Если убрать второе слагаемое, у сети остаётся одно тривиальное решение — отображать вообще всё в одну и ту же точку. А если ввести его без зазора, то появляется другое — продолжать растаскивать вложения непохожих объектов на бесконечность. Зазор нужен именно для того, чтобы не происходило ни того, ни другого.
Зрелым и всем известным воплощением этой линии стал FaceNet (Schroff et al., 2015) с его триплетной функцией потерь (triplet loss): берём якорь , позитив (тот же человек) и негатив (другой человек) и требуем, чтобы якорь был ближе к позитиву, чем к негативу, с некоторым запасом :
FaceNet не предок JEPA в узком техническом смысле, но историческая его роль велика: именно он приучил всех к мысли, что выходом модели может быть не вектор вероятностей классов, а переиспользуемая геометрия вложений. Кроме того, FaceNet действительно великолепно работал и породил целую индустрию распознавания лиц, которая раньше просто не могла существовать.
Наконец, в раннем глубоком обучении есть ещё одна линия, без которой картина будет неполной, — энергетическое обучение (energy-based learning). В программной статье “A Tutorial on Energy-Based Learning” (LeCun et al., 2006) обучение описывается как формирование функции энергии : совместимым конфигурациям должна быть присвоена низкая энергия, а несовместимым — высокая. При этом здесь уже под “конфигурацией” не обязательно понимаются похожие объекты; речь может идти об объектах совсем разной природы, просто так или иначе соответствующих друг другу:
Контрастивная функция потерь из DrLIM оказывается частным случаем: она тянет энергию вниз на похожих парах и толкает её вверх на непохожих.
Главная проблема энергетических моделей в том, что они кажутся почти вероятностными, но на самом деле сделать их таковыми сложно. Чтобы из энергии получить вероятность, её нужно разделить на нормировочную константу — сумму по всем мыслимым конфигурациям, которую в высоких размерностях просто никак не подсчитать. Суть энергетических методов в том, чтобы как-то вылепить нужный ландшафт энергии, ни разу не притронувшись к .
Эта энергетическая оптика нам ещё пригодится, потому что в манифесте 2022 года JEPA будет сформулирована именно как энергетическая модель со скрытой переменной. Пока же запомним простую мысль: контрастивные, неконтрастивные и JEPA-методы — это не три совершенно разных подхода, а три ответа на один и тот же вопрос о том, как поднять энергию там, где данных нет, не вычисляя при этом неподъёмную нормировочную константу.
Пазлы, раскраски и повороты, или эпоха pretext-задач
Прежде чем идти дальше, стоит спросить: а зачем вообще учиться без меток? Ответ понятный и прозаический: размеченные данные дороги, а неразмеченных практически бесконечно много. Но у Лекуна для этого ответа есть и знаменитая гастрономическая метафора, “торт Лекуна” с NIPS 2016:
Eсли интеллект — это торт, то самообучение — сам корж, обучение с учителем — глазурь, а обучение с подкреплением — вишенка сверху. Почти вся «масса» того, чему учится человек или животное, приходится на пассивное впитывание структуры мира, и лишь тонкий слой — на прямые указания и награды. За прошедшие годы Лекун несколько раз уточнял рецептуру (в приведённой выше исходной версии корж назывался unsupervised, потом стал self-supervised), но пропорции не менялись.
И в целом ответ на вопрос “как учиться без меток” выглядит довольно логично: давайте придумаем задачу, для которой метки достаются бесплатно из самих данных, и понадеемся, что для её решения сети придётся выучить что-то полезное. Как, например, всем известные языковые модели обучаются всему на свете, просто предсказывая следующий токен.
Такие задачи называют pretext-задачами (“задачами-предлогами”), и в обработке изображений разных таких задач было очень много. Exemplar-CNN (Dosovitskiy et al., 2014) объявляла каждую картинку отдельным классом. Doersch et al. (2015) предлагали по двум патчам одной картинки угадать их взаимное расположение (“глаз выше носа”).
Дальше были сборка пазла из перемешанных кусочков (Noroozi, Favaro, 2016), раскрашивание чёрно-белых фотографий (Zhang et al., 2016), а главное, inpainting — предложение модели нарисовать вырезанную середину картинки (Pathak et al., 2016); это прямой предок маскированного моделирования:
Были и совсем минималистичные задачи вроде RotNet (Gidaris et al., 2018): давайте повернём картинку на 0, 90, 180 или 270 градусов и попросим сеть угадать, на сколько. Звучит совсем тривиально, но работало на удивление хорошо: чтобы понять, где у собаки верх, нужно неплохо понимать, как выглядит собака.
К этой эпохе относится один поучительный сюжет, связанный скорее с моей вечной темой AI Safety, а точнее, с эффектом goodharting. Нейросети решали pretext-задачи с энтузиазмом, но не всегда тем способом, на который рассчитывали авторы.
Например, в задаче про взаимное расположение патчей (Doersch et al., 2015) сеть научилась жульничать через хроматическую аберрацию объектива: цветовые каналы в реальных фотографиях чуть сдвинуты друг относительно друга радиально от центра кадра, и по этому сдвигу можно определить абсолютное положение патча в кадре, вообще не глядя на содержимое. Авторам пришлось специально ломать этот канал утечки предобработкой цвета.
В итоге выяснилось, что придуманная вручную задача будет решаться самым дешёвым доступным способом, и никто не гарантирует, что этот способ требует “понимания” или построения “модели мира”. Систематическая проверка (Kolesnikov et al., 2019) подтвердила, что pretext-задачи хрупки и сильно зависят от архитектуры.
Тем временем в NLP уже фактически была найдена куда более общая функция потерь, подходящая для этого случая. Word2vec (Mikolov et al., 2013) обучал вложения слов, предсказывая слово по контексту, и его negative sampling — это упрощённая версия noise-contrastive estimation, NCE (Gutmann, Hyvärinen, 2010), статистического приёма, в котором модель обучается отличать данные от шума. Это ещё один приём, который позволяет обойти вычисление нормировочной константы.
Тем самым word2vec дал первое массовое доказательство того, что сильные переносимые представления можно получить почти задаром, как побочный продукт задачи “предскажи слово по контексту”. Одновременно в нём использовался метод NCE, который тоже пригодится для следующего шага в компьютерном зрении. Но word2vec пока предсказывал сами слова, как обычные языковые модели. А предсказывать латентное представление догадаются чуть позже, в методе CPC, к которому мы и переходим.
Контрастивное обучение, или как наделать пар из ничего
В метрическом обучении 1990-х и 2000-х пары “похож / не похож” брались из разметки: мы знали, что эти две подписи принадлежат Иванову. В конце 2010-х случилась мини-революция: люди поняли, что позитивную пару можно изготовить бесплатно. Берём картинку, делаем случайные аугментации (обрезка, фильтры на цвета, отражение) — и у нас получаются два разных вида одного и того же объекта, заведомо позитивная пара, и никакой разметки для этого не нужно. Тем самым идеи pretext-эпохи и NCE сошлись в одной точке, и метрическое обучение превратилось в самообучение (self-supervised learning).
Концептуально к этому ведёт идея instance discrimination: работа Wu et al. (2018) масштабирует идею Exemplar-CNN (“каждая картинка — отдельный класс”) с помощью банка памяти и NCE-подобной функции потерь:
А ближайший к JEPA предок этой эпохи — Contrastive Predictive Coding, CPC (van den Oord et al., 2018): по контексту мы предсказываем латентное представление будущего куска сигнала, оптимизируя так называемую функцию потерь InfoNCE.
InfoNCE в каноническом виде выглядит так:
то есть мы среди кучи кандидатов должны выбрать правильный позитивный пример . Формально это просто многоклассовая классификация. Вот картинка из статьи про аудио, но к любой модальности это будет применяться точно так же:
А название Info-NCE появилось потому, что это и прямой потомок той самой noise-contrastive estimation, и заодно вариационная оценка снизу на взаимную информацию между контекстом и целью:
где — сама (неотрицательная) функция потерь. Поскольку , отсюда сразу получается, что , и это даёт нам одну из главных задач NCE. Если истинная взаимная информация между видами больше , граница упирается в потолок и перестаёт давать полезный сигнал на “лишнюю” информацию: сколько ни учись, оценка выше не поднимется. Единственный способ поднять потолок — увеличить , то есть добавить больше негативов.
Здесь есть и простая теоретико-информационная интуиция: контрастивная задача — это выбор из вариантов, а задачей с вариантами ответа в принципе нельзя подтвердить больше, чем нат зависимости.
Это теоретическое объяснение того, почему негативов всегда хотелось больше и больше. Отсюда пошла гонка за большими батчами (SimCLR), банками памяти (instance discrimination) и очередями (MoCo); давайте мы это разберём чуть подробнее.
Рассмотрим две важные модели 2020 года, которые сделали контрастивное самообучение более практичным и заодно подарили JEPA пару важных деталей. Первая работа — MoCo (He et al., 2020), которая смотрит на задачу как на поиск по словарю: есть очередь негативов и momentum-кодировщик ключей, чьи веса представляют собой экспоненциальное скользящее среднее (EMA) основного кодировщика.
Этот EMA-кодировщик станет прямым техническим предком кодировщика цели в I-JEPA.
Вторая важная работа — SimCLR (Chen et al., 2020), которая показала, что ничего экзотического не нужно: обычная сиамская сеть плюс InfoNCE, но с большими батчами, сильными аугментациями и проекционной головой (projection head, небольшим MLP поверх кодировщика, который потом выбрасывают).
Здесь надо наконец-то проговорить, как вообще принято сравнивать такие модели. Стандартный протокол — linear probing: замораживаем предобученный кодировщик и учим поверх него один-единственный линейный классификатор; если и с таким слабым “читателем” признаки хороши, значит, кодировщик выучил что-то полезное.
Так вот, SimCLR выдала 76.5% top-1 на ImageNet в этом протоколе, вровень с ResNet-50, который обучался с учителем; с этого момента self-supervision начал входить в мейнстрим.
Замечу в скобках, что ровно тот же контрастивный подход, но применённый к парам “картинка / её текстовое описание”, дала CLIP (Radford et al., 2021). Идейно это была всё та же сиамская конструкция двух видов одного объекта, просто видами служили картинка и подпись к ней:
Получилась, вероятно, самая коммерчески успешная сиамская сеть в истории и заодно мост между зрением и языком, на котором до сих пор стоит половина мультимодальных систем.
Что на самом деле делает контрастивная функция потерь, красиво разобрали Wang, Isola (2020): в пределе InfoNCE распадается на два понятных слагаемых — alignment (позитивные примеры расположены близко) и uniformity (вектора равномерно размазаны по сфере).
Это важная идея, и мы к ней ещё вернёмся в разделе про теорию. JEPA унаследует “alignment”-часть этой истории и при этом будет всеми силами избавляться от зависимости от негативов и от агрессивных аугментаций, потому что у контрастивного подхода есть фундаментальная цена: ему нужны негативные примеры, и чем выше размерность, тем их нужно больше. Отсюда и главный вопрос следующей эпохи: а можно ли обойтись вообще без негативных примеров?
Как не сколлапсировать без негатива
Оказалось, что можно, и именно это семейство JEPA наследует напрямую: все механизмы, которыми JEPA борется с коллапсом, изобретены здесь. Это самая важная для нашего сюжета часть, так что разберём её не торопясь.
Началось всё с весьма контринтуитивной работы: метод BYOL (Bootstrap Your Own Latent; Grill et al., 2020) учится вообще без негативов и при этом не коллапсирует. Метод держится на асимметрии: есть online-сеть (кодировщик плюс проектор плюс предсказатель) и есть target-сеть (тот же кодировщик, но с весами-EMA от online).
Online-сеть учится предсказывать выход target-сети по другой аугментации того же изображения, а на target стоит стоп-градиент. Target, то есть учитель, получается медленно движущимся экспоненциальным скользящим средним; он всегда чуть отстаёт, и если “ученика” вдруг понесёт в сторону коллапса, учитель ещё какое-то время помнит, “как было раньше”, и не даёт цели мгновенно схлопнуться.
Почему BYOL не коллапсирует, если ничто явно не отталкивает вектора друг от друга? История с ответом на этот вопрос получилась почти детективная.
Довольно быстро энтузиасты обнаружили, что если убрать из BYOL batch normalization, он таки коллапсирует, и выдвинули красивую теорию: batchnorm — это контрабандные негативы, ведь нормировка заставляет вложения разных картинок отличаться друг от друга, вот вам и отталкивание.
Теория прожила несколько месяцев, пока сами авторы не показали (Richemond et al., 2020), что BYOL прекрасно работает вообще без статистик по батчам, с group normalization и стандартизацией весов; batchnorm оказался полезным для оптимизации, но никак не тайным источником негативов.
Окончательную ясность внёс SimSiam (Chen & He, 2021) одним аккуратным экспериментом: можно выкинуть и EMA, и momentum, оставить просто предсказатель на одной ветви и стоп-градиент на другой — и этой минимальной конфигурации уже хватает. Именно стоп-градиент не даёт системе скатиться в тривиальную неподвижную точку; если его убрать, функция потерь немедленно коллапсирует в константу:
Параллельно развивалась школа мысли, которая делала обучение без учителя через кластеризацию. SwAV (Caron et al., 2020) предсказывает по одному виду картинки кластерное назначение другого вида:
От коллапса этот метод спасается балансировкой кластеров через оптимальный транспорт (алгоритм Синкхорна): нельзя свалить все картинки в один кластер, если кластеры обязаны быть заполнены равномерно. Заодно SwAV ввела в обращение multi-crop — аугментацию “два больших кропа плюс несколько маленьких”, ну или просто “два кропа разного масштаба”, которую потом переняли почти все. Вот пример из того же BYOL (Grill et al., 2020):
Ещё одна школа боролась с коллапсом через явную регуляризацию статистик самого представления, без всякой асимметрии и EMA.
Barlow Twins (Zbontar et al., 2021) подтягивает матрицу корреляций между вложениями двух видов к единичной: на диагонали единицы (инвариантность), вне диагонали нули (декорреляция, чтобы координаты не дублировали друг друга). Это как раз принцип сокращения избыточности Барлоу, с которого мы начинали, и название метода отдаёт ему должное.
VICReg (Bardes et al., 2022) делает то же самое совсем в лоб, тремя слагаемыми:
invariance — MSE между вложениями двух видов (тяни вместе);
variance — шарнирная ошибка, удерживающая стандартное отклонение каждой координаты выше порога; именно это слагаемое прямо запрещает коллапс, ведь схлопнуться в константу — значит обнулить дисперсию, а за это большой штраф;
VICReg и Barlow Twins важны для нашей истории: именно на них указывал манифест 2022 года (LeCun, 2022) как на “правильную”, регуляризационную альтернативу EMA-фокусам. И именно VICReg позже прикрутили обратно к I-JEPA, чтобы стабилизировать обучение, из чего получилась C-JEPA (Mo et al., 2024, spotlight на NeurIPS), но об этом ниже.
Наконец, есть школа дистилляции DINO (Caron et al., 2021): сеть-ученик подгоняет своё распределение под выход momentum-учителя, а от коллапса спасают центрирование и заострение (sharpening) учительского распределения. Надеюсь, вы ещё не запутались в картинках моделей, которые все выглядят примерно одинаково; но в маленьких различиях здесь как раз большой смысл:
DINO расшифровывается как self-distillation with no labels, и это прямой потомок классической дистилляции знаний (Hinton et al., 2015), только учителя с метками здесь нет, студент дистиллирует сам себя из собственного усреднённого прошлого.
Знаменита DINO своим побочным эффектом: в картах внимания ViT сама собой проступает семантическая сегментация объектов.
Эта линия моделей была продолжена в DINOv2 (Oquab et al., 2023, внутри которой работает ещё и iBOT (Zhou et al., 2022) — маскированное предсказание токенов в режиме самодистилляции, — и DINOv3 (Siméoni et al., 2025), 7B-модели, обученной на 1.7 млрд картинок, которая сегодня и есть главный “чисто-SSL” конкурент JEPA по качеству зрительных признаков.
В заключение давайте подытожим этот раздел небольшой табличкой. Вот пять механизмов, которые мы здесь увидели и которые дальше будут встречаться в разных комбинациях:
Механизм
Где придуман
Суть
Негативы / отталкивание
DrLIM, CPC, SimCLR, MoCo
поднимать энергию на неподходящих парах
Асимметрия: предсказатель + стоп-градиент
BYOL, SimSiam
разорвать симметрию ветвей, чтобы константа перестала быть неподвижной точкой
EMA / momentum-учитель
MoCo, BYOL, DINO, I-JEPA, V-JEPA
учитель “отстаёт” от ученика и тем самым не даёт схлопнуться
Балансировка кластеров
SwAV, DINO (центрирование)
явный запрет всем точкам сваливаться в один кластер
Явная регуляризация дисперсии и ковариации
Barlow Twins, VICReg
поддержание нужных статистик представлений силой
К концу поста мы добавим к этой таблице шестую строку, которая попытается заменить все эти “хаки” одной строгой теоремой.
Маскированное моделирование: ветвь, от которой JEPA отталкивается
Пока одни боролись с коллапсом без негативов, другие развивали совсем иную ветвь самообучения — маскированное моделирование (masked image modeling, MIM).
Сама идея “испорти вход и восстанови его” — почтенная классика; ровно это делали denoising autoencoders (Vincent et al., 2008), а inpainting из pretext-эпохи был их пространственным вариантом.
Первый раз этот рецепт по-настоящему выстрелил в NLP: BERT (Devlin et al., 2019) был не обычной языковой моделью, как GPT, а именно маскированной, и он сделал MLM (masked language modeling) главным способом обучения представлений в NLP. Компьютерное зрение, разумеется, тоже захотело такой метод использовать. MIM — это BERT для картинок, и эта ветвь важна нам как антагонист: JEPA определяет себя именно в противопоставлении к ней.
Рецепт прост: прячем часть патчей и просим модель восстановить спрятанное. MAE (Masked Autoencoder; He et al., 2022) восстанавливает сырые пиксели при агрессивном маскировании (около 75%) асимметричным кодировщиком-декодировщиком; это главный MIM-бейзлайн.
BEiT (Bao et al., 2022) предсказывает дискретные визуальные токены. Есть и любопытная промежуточная точка — MaskFeat (Wei et al., 2022), которая предсказывает HOG-признаки вместо пикселей: уже не сырой сигнал, но ещё и не обученное представление, ровно на полдороге.
Линия эта мощная, но к ней JEPA предъявляет свою главную претензию: восстанавливать пиксели — значит тратить ёмкость модели на принципиально непредсказуемую и малоинформативную мелочь. Об этом подробнее через одну главу.
И были две работы 2022 года, которые стали непосредственными техническими предвестниками I-JEPA. Первая — data2vec (Baevski et al., 2022), которая предсказывает не пиксели и не токены, а контекстуализированные латентные представления полного входа по маскированному виду, через EMA-учителя и сразу для речи, зрения и текста.
Вторая — Masked Siamese Networks (MSN; Assran et al., 2022), от той же команды Meta, что потом сделает I-JEPA: представление маскированного вида подгоняется к представлению немаскированного в сиамской схеме.
Метод здесь не вовсе без учителя, но очень экономно использует разметку — 75.7% на ImageNet всего с 1% меток.
Так что когда мы дойдём до I-JEPA, важно помнить, что она выросла не на пустом месте: это синтез очень плотной окрестности: BYOL и SimSiam (асимметрия и EMA), VICReg (регуляризация), data2vec и MSN (латентные таргеты и маскирование), CPC (предсказание в латентном пространстве). Интересна в I-JEPA не сама идея латентного предсказания, а то, что именно из всего этого взять и как обрезать лишнее.
Замечу здесь ещё, что весь этот зоопарк работает уже на базе трансформеров (Vaswani et al., 2017) и, в частности, на базе Vision Transformer (ViT; Dosovitskiy et al., 2021), который как раз режет картинку на патчи-токены.
Именно ViT даёт ту решётку патчей, по которой очень удобно делать блочное маскирование.
Манифест 2022 года, или модель мира внутри агента
И вот теперь мы наконец-то подошли собственно к семейству JEPA. Впервые эта идея появляется внутри большой программы, в position paper “A Path Towards Autonomous Machine Intelligence” (LeCun, 2022). Это программный текст, манифест о том, каким должен быть автономный интеллект, безо всяких бенчмарков и таблиц, да и без каких-то конкретных технических подробностей.
Мотивация у Лекуна отчасти арифметическая, и он любит её пересчитывать вслух: четырёхлетний ребёнок успел пободрствовать около 16 тысяч часов, и через его зрительный нерв за это время прошло порядка байт — в десятки раз больше, чем весь текст, на котором обучают самые большие LLM. И на этом контенте ребёнок успел получить массу очень интересных интеллектуальных способностей; вот картинка, которую Лекун здесь часто показывает:
Вывод из этого в том, что главный источник обучающих данных — не текст, а сенсорный поток, и выучиться на нём можно только самообучением, без всяких меток. Осталось понять, чему именно учиться на этом потоке; ответ манифеста — модели мира (world models).
Лекун предлагает модульную когнитивную архитектуру, которую в статье прямо на мозг накладывает:
Здесь шесть основных компонентов:
perception (восприятие; строит оценку текущего состояния мира);
world model (модель мира; центральный модуль, который достраивает недостающее в текущем состоянии и предсказывает правдоподобные будущие состояния, в идеале на нескольких уровнях абстракции и в нескольких масштабах времени);
cost module (стоимость; неизменяемая внутренняя часть плюс обучаемый критик);
actor (агент; предлагает последовательности действий);
short-term memory (кратковременная память; про то, во что выросла память у современных LLM-агентов, у меня недавно был отдельный длинный пост — там, правда, совсем другая инженерная традиция);
configurator (конфигуратор; настраивает всё остальное под текущую задачу).
Дальше Лекун раскрывает их подробнее, и по его идее все модули оказываются дифференцируемыми, поэтому планирование сводится к оптимизации последовательности действий по предсказанной будущей стоимости. Лекун называет это Mode-2 (буквально по Канеману), медленным обдуманным рассуждением. Это рассуждение потом можно “скомпилировать” в быструю реактивную политику (Mode-1).
И вот именно для модуля world model JEPA предлагается как не-порождающая архитектура:
Формально общая идея JEPA устроена очень похоже на то, что мы видели выше. По контексту и цели два кодировщика строят представления:
Предсказатель достраивает цель по контексту и описанию того, что предсказывается (позиция, сдвиг во времени, действие):
Обучение минимизирует расстояние между предсказанием и (остановленным по градиенту) представлением цели плюс ещё опциональную регуляризацию против коллапса:
Здесь может быть EMA-учителем, замороженным кодировщиком или тем же кодировщиком с регуляризацией. Есть только одна важная деталь, которая отличает JEPA от классической сиамской схемы: кодировщики не обязаны использовать одни и те же веса, и могут быть устроены по-разному.
Вот то же самое в виде схемы и по-русски:
Здесь можно выделить две главные идеи; обе не новы, но их успешную комбинацию до сих пор не так легко сделать:
добавить скрытые переменные, индексирующие варианты будущего;
предсказывать представления, а не сами объекты (например, пиксели).
Первая идея становится прозрачнее в энергетической переформулировке. Введём скрытую переменную, которая берёт на себя ту часть , что принципиально не определяется контекстом:
Это кажется небольшим изменением, но оно очень принципиальное. Будущее многовариантно: машина у развилки может поехать налево или направо, и обе ветки правдоподобны. Если мы строим детерминированный предиктор с квадратичной функцией потерь, то он выучивает условное среднее. И если кодировщик отобразит “налево” и “направо” в два разных вектора, то их среднее может не соответствовать вообще никакому реальному будущему — оно повиснет где-то между:
А скрытая переменная как раз индексирует эти альтернативы; при каждом конкретном значении будет получаться правдоподобный вариант будущего.
В манифесте выписаны четыре неконтрастивных критерия обучения, каждый из которых имеет теоретико-информационное обоснование:
добавить скрытые переменные, индексирующие варианты будущего;
максимизировать информацию, которую несёт об ;
максимизировать информацию, которую несёт об (эти два пункта не дают представлениям сколлапсировать);
сделать максимально предсказуемым из (а это, наоборот, тянет к полезности);
минимизировать информацию в скрытой переменной , чтобы предсказатель не сжульничал, протащив весь ответ через .
Вот так они соотносятся с общей схемой:
Энергетическая оптика заодно делит методы борьбы с коллапсом на две части: контрастивные методы поднимают энергию у негативных примеров (и страдают от проклятия размерности), а регуляризационные ограничивают сам объём низкоэнергетического пространства, накладывая информационные ограничения на представления в духе VICReg. JEPA целиком находится в регуляризационном лагере.
Наконец, в манифесте предлагается и H-JEPA — иерархическая JEPA, где нижние уровни предсказывают на коротких масштабах и в мелких деталях, а верхние — на длинных масштабах и в более абстрактных состояниях.
К 2026 году это всё ещё скорее манифест, чем реализованная система, но именно H-JEPA остаётся концептуальным мостом от SSL-картинок к агентам, которые планируют.
Теперь ко второму вопросу: почему вообще нужно предсказывать представления, а не пиксели. Это один из центральных пунктов всей программы. Представьте, что вы предсказываете следующий кадр видео: едет машина, а на заднем плане колышется листва и идёт рябь по пруду. Траектория машины полезна и предсказуема; точное положение каждого листочка и каждой мини-волны — ни то, ни другое.
Но генеративная модель, которая считает правдоподобие в пикселях, обязана тратить свою ёмкость не только на машину, но и на листья. JEPA же предсказывает представление, и обученный кодировщик может отобразить тысячу кадров с разными конфигурациями листьев на деревьях в близкие векторы, позволив предсказателю сосредоточиться на устойчивых факторах. Способность к надёжной абстракции здесь не недостаток, а ровно то, чего мы хотим.
Звучит красиво, но есть и кое-какие оговорки:
латентное предсказание не даёт нужную семантику автоматически: кодировщик надо заставить сохранять полезное и выбрасывать шум, и делают это геометрия маскирования, архитектура, динамика учителя, регуляризация и данные, а не сама идея предсказания латентных кодов;
во-вторых, порождающая и латентно-предсказательная модели — это не антонимы: VAE, VQ-VAE, латентные диффузионные модели тоже предсказывают и порождают в выученном латентном пространстве, и граница проходит не по линии “генеративное против не-генеративного”, а по вопросу о том, какие переменные представление должно сохранять и ради какой последующей (downstream) задачи;
в-третьих, иногда пиксельная цель всё-таки полезна, особенно когда важны детали геометрии (локализация, глубина, трекинг и т.п.); мы ещё увидим, как V-JEPA 2.1 в 2026-м фактически частично вернула плотную предсказательную функцию потерь именно по этой причине.
Но с оговорками или без, а всё равно из манифеста таки сделали работающую модель, и не одну. Давайте к ним и перейдём.
I-JEPA, или первая настоящая реализация
I-JEPA (Assran et al., CVPR 2023) — первая чистая реализация идеи для картинок. Задача формулируется так: по одному контекстному блоку изображения предсказать представления нескольких целевых блоков того же изображения. Вот сравнение со стандартными подходами, а справа собственно общая схема JEPA:
Здесь работают три сети:
кодировщик контекста (ViT), который обрабатывает только видимые контекстные патчи;
кодировщик цели, EMA-копия кодировщика контекста, который кодирует полное изображение в патч-представления, из которых берутся цели;
ViT-предсказатель, который получает контекстные токены плюс обучаемые mask-токены (несущие позицию целей) и предсказывает представления целевых патчей.
Функция потерь — это среднее -расстояние между предсказанными и целевыми представлениями по целевым блокам:
Как видите, здесь нет никаких негативных примеров, никакого пиксельного декодировщика и никаких контрастивных слагаемых в функции потерь. С коллапсом здесь борется ровно один механизм — EMA-target со стоп-градиентом: параметры цели тянутся за кодировщиком контекста как
(momentum стартует с 0.996 и линейно растёт к 1). Поскольку таргет отстаёт и получает стоп-градиент, тривиальное константное решение перестаёт быть неподвижной точкой.
Дальше идут три важных архитектурных решения, в которых, собственно, и заключается главная новизна. Первое — многоблочное маскирование (multi-block masking), то самое, что делает признаки семантическими. Берём целевых блока со случайным масштабом в диапазоне площади и соотношением сторон в , а затем один большой контекстный блок с масштабом , из которого вырезаем пересечения с целями.
Интуиция в том, что предсказывать несколько крупных, осмысленных блоков по информативному, но пространственно неполному контексту — значит быть вынужденным моделировать структуру уровня объектов, их смысл, а не угадывать локальную текстуру.
Второе решение — маскирование на выходе кодировщика цели, а не на входе: цели вырезают из представлений полного изображения, а не из сырых пикселей, поэтому каждый целевой патч уже “знает” свой контекст (он контекстуализирован полным проходом кодировщика), и цели получаются гораздо более семантическими.
И третье — эффективность: backbone’ы от ViT-B/16 до ViT-G/16, и здесь важно, что ViT-H/14 обучается на ImageNet меньше чем за 72 часа на 16 A100 — по меркам нынешних фронтирных бюджетов это вообще ничто, но и тогда было в разы дешевле, чем у MIM-методов.
Особенно показательно получилось, что I-JEPA сильна в низкоуровневых пространственных задачах вроде счёта объектов и упорядочивания по глубине: значит, предсказатель и правда выучивает пространственную структуру, а не только глобальную инвариантность.
Получается, что I-JEPA вобрала в себя три традиции, о которых мы говорили выше:
от BYOL, SimSiam и VICReg она берёт мысль, что негативы не нужны, а коллапс лечится асимметрией, EMA и регуляризацией;
от маскированного моделирования — сильную pretext-задачу, основанную на вырезании кусочков;
а собственно из JEPA, в отличие от MAE, получается то, что она не восстанавливает пиксели, а работает на уровне представлений.
Но пока что I-JEPA — это не агентская архитектура из манифеста. Тут нет ни действий, ни планировщика, ни критика, ни долговременной памяти, ни иерархии, ни скрытой переменной для многовариантного будущего. Это применение JEPA-принципа к обучению представлений, и только.
От картинок к видео: MC-JEPA, IWM и V-JEPA
При переходе к видео идея JEPA становится по-настоящему амбициозной, потому что у видео есть время, а значит, появляется динамика, а значит, забрезжила и модель мира.
Переходным звеном здесь служит MC-JEPA (Bardes et al., 2023), которая в одном кодировщике учит сразу содержание (content, что на сцене) и движение (motion; оптический поток, как оно движется). Обычное SSL работает с контентом, но игнорирует движение, а методы оценки потока, наоборот, моделируют движение без понимания содержания; MC-JEPA пытается их совместить:
Ещё один концептуально важный поворот делает работа про Image World Models, IWM (Garrido et al., 2024). В большинстве SSL предсказатель — это строительные леса, которые после обучения выбрасывают. IWM основана на следующей идее: а что если сам предсказатель и есть полезная, переиспользуемая модель мира?
Авторы обобщают JEPA-задачу с маскирования на глобальные фотометрические преобразования (предсказать в латентном коде, что будет, если поменять яркость или цвет) и показывают, что качество такого предсказателя определяют три рычага: обусловленность (conditioning), сложность задачи и ёмкость предсказателя. Предсказатель здесь перестаёт быть мусором и становится объектом изучения. В итоге IWM действительно может предсказывать результаты трансформаций такого рода (NN of prediction — это ближайший сосед из некоторого датасета в пространстве представлений, мы же представления предсказываем):
А обучение ведётся почти как обычно, только теперь с новыми преобразованиями:
И, наконец, флагман — V-JEPA, «Revisiting Feature Prediction for Learning Visual Representations from Video» (Bardes et al., 2024). Она обучается исключительно предсказанием признаков на примерно 2 млн публичных видео — без предобученного кодировщика картинок, без текста, без негативов и без пиксельной реконструкции (пиксельную альтернативу для видео представляет VideoMAE, Tong et al., 2022).
Ключевой приём — агрессивное пространственно-временное маскирование: видео режется на так называемые tubelets, то есть патчи с временной протяжённостью; маски растянуты по всей временной оси (это важно, иначе соседние во времени кадры почти дублируют друг друга и задача становится тривиальной — модель просто скопирует ответ у соседнего кадра); есть маски на короткую дистанцию (объединение 8 блоков, около 15% кадра) и на длинную (2 блока, около 70% кадра), и в среднем маскируется около 90%; цели поставляет EMA-кодировщик, а функция потерь — -регрессия.
Главное утверждение V-JEPA — не в том, чтобы моделью мира предсказывать будущее во всех деталях. Оно в том, что одно лишь предсказание признаков даёт замороженное представление, которое переносится и на задачи про внешний вид, и на задачи про движение.
Цифры здесь, как обычно, есть где покритиковать, тут могут быть разные протоколы оценки, и путаница на этой почве в литературе всегда присутствует, но видно, что латентное предсказание будущего ближе к предиктивному кодированию (CPC), чем к авторегрессионному или диффузионному порождению видео.
Тут уместно вспомнить ещё одну красивую идею из вычислительной нейронауки — анализ медленных признаков (slow feature analysis, Wiskott, Sejnowski, 2002). Гипотеза там такая: семантически важные величины меняются во времени медленно (машина едет по своей траектории, объекты не мигают), а сенсорный шум — быстро (каждый лист дрожит по-своему), поэтому “ищи медленное” — само по себе неплохой принцип обучения признаков без учителя.
Ранний анализ JEPA-моделей мира так и назывался: “Joint Embedding Predictive Architectures Focus on Slow Features” (Sobal et al., 2022); там показано, что временное латентное предсказание естественным образом вытаскивает медленные компоненты сигнала. Это приятно замыкает интуицию про листья и машину: JEPA не потому хороша, что «игнорирует детали», а потому, что медленное и предсказуемое в мире почти всегда совпадает с осмысленным.
А ещё, когда JEPA перешла к видео, впервые стало уместно спросить: а понимает ли эта модель физику? В работе про интуитивную физику (Garrido et al., 2025) применяют “парадигму нарушенного ожидания” (violation of expectation) из психологии развития: модели показывают возможные и невозможные продолжения (объект исчезает за ширмой и не появляется; проходит сквозь стену) и смотрят, удивляется ли она — растёт ли ошибка предсказания на невозможном варианте.
Результат получился очень позитивный: предсказания в латентном пространстве понимают постоянство объектов и согласованность формы заметно лучше, чем пиксельное предсказание и мультимодальные LLM, которые часто остаются около случайного угадывания.
Это, конечно, не доказывает, что JEPA уже выучила “здравый смысл” про окружающий мир, и тут же вышли более сложные бенчмарки — IntPhys 2 (Bordes et al., 2025) и Minimal Video Pairs (Krojer et al., 2025), — на которых SOTA-модели снова находятся у случайного уровня, а люди у потолка. Но заметьте, что это уже немного другой вопрос: модели теперь можно спрашивать “что именно у тебя в представлениях?”, а не только “какой у тебя accuracy на этом бенчмарке”.
V-JEPA 2, или замыкание петли к планированию
И вот мы наконец-то приходим к той точке, ради которой всё затевалось. V-JEPA 2 (Assran et al., 2025) — это не просто отмасштабированная версия V-JEPA, а версия, которая наконец-то соединяет обучение представлений с моделью мира для планирования, которую нам манифест Лекуна изначально и обещал.
У V-JEPA 2 две стадии обучения и два типа данных.
Первая стадия — предобучение чистым наблюдением. Action-free кодировщик (ViT-g, больше 1 млрд параметров) обучается на 22 млн сэмплов, представляющих больше 1 млн часов интернет-видео плюс картинки, с прогрессивным наращиванием разрешения, 3D-RoPE и аккуратным отбором данных. В результате получаются отличные результаты на бенчмарках video understanding и, что показательно, state-of-the-art на предвосхищении действий в Epic-Kitchens-100, большой скачок над специализированными моделями. Авторы даже попробовали скрестить замороженный кодировщик с 8B LLM (в духе LLaVA) и на выходе получили очень даже сильный Video-QA, при том, что сам кодировщик за всю жизнь не видел ни одного слова и отвечает на вопросы через “LLM-переводчика”. Первая стадия на картинке слева:
Вторая стадия — V-JEPA 2-AC, модель мира с действиями (на картинке справа). Кодировщик замораживают и поверх него обучают предсказатель примерно на 300M параметров с блочно-каузальным вниманием; обучают на менее чем 62 часах неразмеченного видео робо-руки из датасета DROID, то есть здесь данных на порядки меньше.
Предсказатель учится предсказывать будущие патч-представления по прошлым представлениям, действиям и состоянию эффектора. Там есть и teacher forcing вариант, и с продолжительными роллаутами, но давайте в это уж не будем сейчас углубляться:
Планирование потом, разумеется, идёт прямо в латентном пространстве. На реальных роборуках модель работает в zero-shot режиме: цель задаётся картинкой, и model-predictive control методом перекрёстной энтропии (cross-entropy method, CEM) ищет действия, минимизирующие -расстояние между предсказанным будущим представлением и представлением цели; здесь энергия выступает как расстояние до цели.
Без всякого сбора данных с этих конкретных роботов, без инженерии reward-функций, без дообучения под задачу получается переставлять новые объекты в новой обстановке с успехом 65–80%.
На сегодня V-JEPA 2 — это самая ясная и близкая к оригиналу реализация обещаний 2022 года. Но есть и очевидные ограничения: это пока обучения манипуляциям на коротком горизонте, с заданными визуальными подцелями и отдельно дообученной action-моделью. До полного стека “configurator + actor + critic + memory” из манифеста по-прежнему далеко.
Интерлюдия: JEPA в контексте
Тут полезно немного поднять голову и оглядеться, потому что модели мира придумали не в Meta. Есть целая традиция обучать внутреннюю модель динамики и планировать в ней. К основоложникам здесь стоит отнести скорее работу “World Models” (Ha & Schmidhuber, 2018; да-да, опять тот самый Шмидхубер!), которая обучает VAE плюс RNN-динамику, и контроллер тренируется внутри “сна” модели.
Ну и, наконец, нельзя не вспомнить MuZero (Schrittwieser et al., 2020), которая планирует в выученной латентной модели, которая в свою очередь предсказывает только награду, функцию значения и стратегию и при этом никогда не реконструирует наблюдения.
Есть и параллельная линия внутри самого обучения с подкреплением. DeepMDP (Gelada et al., 2019) обучает латентную модель через бисимуляцию; SPR (Schwarzer et al., 2021) предсказывает собственные будущие латентные состояния с EMA-таргетом — по сути, это BYOL, пересаженный в RL на играх Atari, причём независимо и почти одновременно:
TD-MPC (Hansen et al., 2022) планирует в латентном пространстве без декодировщика; бисимуляционные метрики (Zhang et al., 2021) строят представления, различающие состояния только по будущим наградам.
Здесь можно порекомендовать систематический обзор Ni et al. (2024), который наводит во всём этом зоопарке некоторый порядок, в частности, разбирает, когда латентное самопредсказание в RL устойчиво, а когда коллапсирует. Позволю себе скопировать табличку оттуда, хотя, конечно, разбирать это всё мы сейчас не будем:
Разница между этими направлениями тем не менее есть. Dreamer, PlaNet и прочие обучают порождающую латентную динамику, с реконструкцией. MuZero и вся RL-линия обучают value-equivalent модели, предсказывающие только то, что нужно для оценки хода, — им нужна конечная награда как сигнал.
А в JEPA работает самообучаемая латентная модель без реконструкции, чья единственная цель — предсказание признаков, и обучение идёт из пассивного видео, вообще без каких-то наград или разметки. Только уже на уровне V-JEPA 2-AC эта модель берёт методы планирования (CEM/MPC) у лагеря Dreamer/PlaNet. Иначе говоря, новизна тут не в том, чтобы планировать в латентном пространстве — это умели и в 2019-2020, — а в том, чтобы обучиться чисто пассивным самообучением на интернет-видео, без наград и реконструкции, но так, чтобы латентное пространство в итоге годилось для планирования.
И ещё пара слов про родство с нейронаукой, разумеется, достаточно абстрактное и скорее на правах вдохновения. JEPA отлично сходится с теорией предиктивного кодирования (predictive coding; Rao & Ballard, 1999), в которой обратные связи в коре несут предсказания активности нижних уровней, а прямые связи несут ошибку предсказания.
Есть в нейронауках и более общий принцип свободной энергии Фристона (Friston, 2010): мозг минимизирует ошибку предсказания, она же вариационная свободная энергия.
Сам Лекун цитирует предиктивное кодирование как мотивацию, но это, конечно, именно абстрактное вдохновение, а не какое-то утверждение про моделирование работы настоящего мозга.
Зоопарк JEPA-моделей
К 2026 году JEPA — это уже не одна модель, а большое семейство, объединённое общей структурой: кодировщики контекста и цели плюс предсказатель плюс маскирование, EMA или регуляризация против коллапса, а также регрессионная функция потерь в латентном пространстве. Перечислю несколько работ, хотя здесь список, конечно, будет заведомо неполным, да и новые модели появляются буквально каждый месяц.
Для аудио есть A-JEPA (Fei et al., 2023) с маскированием мел-спектрограмм и Audio-JEPA (Tuncay et al., 2025); любопытный эмпирический факт состоит в том, что для аудио случайное маскирование бьёт зрительное блочное.
Для 3D и облаков точек есть Point-JEPA (Saito et al., 2024), где специальный sequencer упорядочивает неупорядоченные точки, чтобы можно было брать смежные контекст/таргет-блоки, не реконструируя вход.
Для графов — Graph-JEPA (Skenderi et al., 2023), предсказывающая вложения подграфов, опционально в гиперболическом пространстве, чтобы кодировать иерархию.
Для мозга и биосигналов — S-JEPA для EEG/BCI (Guetschel et al., 2024) и далее ЭКГ, fMRI и прочее. Для робототехники и стратегий действия — ACT-JEPA (Vujinović et al., 2025), предсказывающая “чанки” действий и абстрактных наблюдений в латентном пространстве для имитационного обучения. Букву T, кстати, успели независимо занять дважды: T-JEPA — это и про траектории движения (Li et al., 2024), и про табличные данные (Thimonier et al., 2024); свободных букв в алфавите остаётся всё меньше. Есть и гибриды с порождающими моделями вроде D-JEPA (Chen et al., 2024), которая скрещивает латентное предсказание следующего токена с диффузией и flow matching.
Отдельно стоит сказать про VL-JEPA (Chen et al., 2025) — попытку перенести базовый принцип в язык. Вместо авторегрессионного порождения токенов она предсказывает непрерывные вложения целевых текстов, а лёгкий декодировщик вызывается только тогда, когда текст и правда надо “материализовать”. Мотивация здесь ровно как у зрительной JEPA: множество строк выражают один и тот же смысл, поэтому пословное правдоподобие тратит ёмкость на поверхностную форму, а предсказание семантического вложения схлопывает перефразировки в общую цель.
Но в языке форма сама бывает задачей — иногда нужно вспомнить цитату, точное имя, синтаксис кода, область действия квантора. Поэтому, конечно, VL-JEPA не пытается сказать, что предсказание токенов устарело, а предоставляет некий “альтернативный интерфейс”, и скорее всего здесь будущее останется за гибридными подходами (непрерывное латентное предсказание плюс выборочное декодирование).
Теория, или почему всё это вообще работает
Практика, как это часть бывает в глубоком обучении, бежит здесь далеко впереди понимания. Но кое-какие результаты всё-таки есть; давайте здесь рассмотрим три основных направления: что оптимизируют контрастивные методы, почему методы без негативов не сваливаются в константу и что во всём этом специфично именно для JEPA. Этот раздел можно при желании пропустить, да и не буду я здесь рассказывать математические детали, только заявлю основные результаты. Кроме того, пользуясь случаем, порекомендую подробное введение в тему: “A Cookbook of Self-Supervised Learning” (Balestriero et al., 2023).
Что оптимизирует контрастивная функция потерь
Работу Wang & Isola (2020) мы уже встречали выше. Они показали, что в пределе InfoNCE распадается на две части — alignment, которая тянет позитивные пары вместе, и uniformity, которая раскидывает признаки по гиперсфере как можно равномернее. Интересно тут то, что эти две метрики можно оптимизировать напрямую, без всякого InfoNCE, и получить ровно то же качество. То есть “отталкивание негативов” — это не самоцель, а лишь способ обеспечить равномерность; именно равномерность не даёт представлению сколлапсировать, а alignment делает его полезным. JEPA, как мы видели, оставляет себе alignment и ищет другие, не контрастивные способы обеспечить “равномерность” (то есть не допустить коллапса).
Работа Balestriero & LeCun (2022) показала, что SimCLR, VICReg и Barlow Twins при определённых выборах гиперпараметров восстанавливают классические спектральные методы — Laplacian Eigenmaps, ISOMAP, Multidimensional Scaling и другие. В ту же сторону идёт спектральная контрастивная функция потерь (HaoChen et al., 2021): контрастивное обучение оказывается спектральным разложением графа аугментаций — огромного графа, в котором картинки соединены ребром, если могли получиться друг из друга аугментациями, — причём с доказуемыми гарантиями качества на downstream-задачах.
А работа про дуальность (Garrido et al., 2023) связывает контрастивные и неконтрастивные методы через спектральную и ковариационную оптику и показывает, что во многом это два взгляда на один и тот же объект.
Иначе говоря, весь зоопарк методов самообучения (self-supervised learning) можно рассматривать как одну и ту же идею: построение геометрии, согласованной с графом аугментаций. А различия между методами сводятся к тому, как именно мы этой геометрии обучаем наши сети.
Почему методы без негативов не сваливаются в константу
Здесь, честно говоря, единого общепринятого объяснения до сих пор нет, и это само по себе любопытно.
Есть анализ динамики обучения BYOL и SimSiam (Tian et al., 2021): авторы показывают, что связка “предсказатель плюс стоп-градиент плюс EMA” работает за счёт разделения масштабов времени между предсказателем и таргетом и неявной регуляризации дисперсии, и даже выводят из этого анализа упрощённый метод DirectPred, который задаёт предсказатель аналитически.
Есть отдельный сюжет про коллапс размерности (Jing et al., 2022): представление может не схлопнуться в точку, но всё равно «провалиться» в подпространство меньшей размерности, чем ему доступно.
Это более тонкая картина, чем полный коллапс, и именно она мотивирует декорреляционные методы вроде Barlow Twins. Степень такого частичного коллапса, кстати, можно мониторить по эффективному рангу представлений: метрика RankMe (Garrido et al., 2023) неплохо предсказывает downstream-качество вообще без разметки.
Показательно и то, что один лишь EMA-таргет оказывается не вполне надёжным предохранителем. Уже упоминавшаяся C-JEPA (Mo et al., 2024) прямо отмечает, что у I-JEPA EMA сама по себе недостаточна, чтобы гарантированно избежать коллапса, и добавляет к ней слагаемые дисперсии и ковариации из VICReg, после чего обучение становится стабильнее и сходится быстрее. Так что пока JEPA-модели всё-таки во многом основаны на эвристиках, а не на следствиях какой-то одной теоремы.
Что специфично для JEPA — и при чём тут информация
Самый приятный из специфичных для JEPA результатов — про неявное смещение (implicit bias). Литвин с соавторами (Littwin et al., 2024) показывают, что в глубоких линейных моделях JEPA смещена в пользу “влиятельных” признаков (с большими коэффициентами) признаков и подавляет шумные высокодисперсные направления, причём это смещение усиливается с глубиной. У реконструкционных методов вроде MAE такого преимущества нет: пиксельная цель вынуждает их тратить ёмкость и на шум тоже. Это как раз анализ идеи о том, почему латентное предсказание может быть лучше пиксельной реконструкции не эмпирически, а принципиально.
Полезно посмотреть на то же самое с точки зрения теории информации. Обучение делает предсказуемым из контекста , а значит, кодировщик вознаграждается за то, что сохраняет компоненты с высокой условной предсказуемостью, и может выбрасывать высокоэнтропийный остаток. Это роднит JEPA с эффективным кодированием, информационным бутылочным горлышком и достаточными статистиками — а через медленные признаки, о которых шла речь выше, ещё и с временной когерентностью.
Но здесь есть и важный концептуальный риск: совпадает ли “предсказуемое” с “семантически важным” или “важным для решаемой задачи”? Очевидно, что далеко не всегда! Статичный фон бывает прекрасно предсказуем, но при этом совершенно бесполезен; редкое событие бывает почти непредсказуемо, но критически важно. Чтобы абстракция формировалась “в нужную сторону”, скорее всего, нужны ещё действия, стоимость, новизна, иерархия и обусловливание задачей, а не одно лишь пассивное предсказание.
И отдельно сюда же примыкает уже обсуждавшаяся ловушка условного среднего: детерминированный предсказатель под квадратичной функцией потерь усредняет взаимоисключающие будущие в несуществующее среднее, так что настоящая стохастическая модель мира обязательно должна иметь скрытые переменные.
LeJEPA: попытка заменить хаки одной теоремой
Теоретической вершиной этой линии стала LeJEPA (да-да, её так назвали французы, Balestriero & LeCun, 2025). Тезис её в том, что, как мы уже обсуждали, линия JEPA-моделей всё время опиралась на рецепты и эвристики — EMA-учителей, стоп-градиент, архитектурную асимметрию, расписания momentum. А хочется всё-таки построить единую теорию того, какое распределение вложений нам вообще нужно.
LeJEPA даёт для этого две идеи. Во-первых, авторы доказывают, что изотропное гауссовское распределение вложений оптимально для минимизации downstream-риска предсказания по заранее неизвестным задачам. Во-вторых, они вводят SIGReg (Sketched Isotropic Gaussian Regularization) — способ заставить вложения быть как раз такими вот гауссовскими, сопоставляя их одномерные случайные проекции с гауссовыми (это тест в духе Крамера–Вольда и характеристических функций) за линейное время и память.
Выигрыш получается в том, что исчезает вообще весь стек непонятных эвристик. Нет стоп-градиента, нет EMA-учителей, нет асимметрии предсказателя, нет ручных расписаний; ядро обучения умещается примерно в 50 строк и стабильно тренируется с единственным гиперпараметром. Помните табличку из раздела про методы без негативов? Вот обещанная шестая строка:
Механизм
Где
Суть
Явная регуляризация распределения (SIGReg)
LeJEPA, 2025
напрямую подтягивать маргинальное распределение вложений к изотропному гауссиану
Но тема ещё далеко не закрыта: изотропность тут же оспорили. UR-JEPA (Le, 2026, независимая работа одного автора, не из Meta и не от Лекуна, хоть и Le) отмечает, что полноразмерный изотропный гауссиан противоречит гипотезе многообразия (manifold hypothesis), согласно которой вложения должны концентрироваться на низкоразмерном подмногообразии, а не заполнять весь шар.
Вместо гауссиана UR-JEPA пытается попасть в равномерно -спрямляемую меру, и её глобальный PCA-спектр падает на 4–5 порядков, тогда как у LeJEPA он почти плоский. Так что вопрос о том, какая должна быть геометрия у пространства вложений, пока остаётся открытой темой для исследований.
Стоит упомянуть и LeWorldModel (Maes et al., 2026; среди авторов те же Лекун и Балестриеро), где ту же философию приложили к латентной динамике для управления: обучение идёт end-to-end прямо из пикселей с двумя слагаемыми (предсказание следующего вложения плюс гауссова SIGReg-регуляризация), и число настраиваемых гиперпараметров функции потерь падает с шести до одного.
Модель при этом крошечная по нынешним меркам (около 15M параметров), учится на одной GPU за часы, планирует в десятки раз быстрее моделей поверх больших замороженных кодировщиков, и в её латентных кодах читаются физические величины.
А вероятностную ветку со скрытыми переменной, — разрабатывает, например, вариационная VJEPA (Huang, 2026), дающая гарантии против коллапса через ELBO и связь с предиктивными представлениями состояний и байесовской фильтрацией.
Заключение
Попробую теперь собрать общую картину. JEPA — это точка, где давний энергетический взгляд Лекуна на обучение встречается с современным инструментарием самообучения, и где сиамско-контрастивная традиция появляется не в форме “заставь два вида совпасть”, а в форме “выучи абстрактные состояния, которые делают мир достаточно предсказуемым, чтобы его понимать, воображать и планировать”.
Вся эта наука вырастает из сиамских сетей, которые начались ещё в 1992-1993 годах, и контрастивного обучения, которое пришло как минимум из середины нулевых. Но только в 2022-м Лекун собрал всё это в единую стройную картину и призвал предсказывать смысл, а не пиксели. Дальше развитие было куда стремительнее: от I-JEPA для картинок в 2023 до V-JEPA 2, которая управляла рукой робота в незнакомой лаборатории, планируя прямо в латентном пространстве, прошло всего два года.
Выиграла ли ставка Лекуна против LLM? Кажется, что вряд ли. JEPA пока что “всего лишь” одно сильное и эффективное семейство самообучения без реконструкции среди нескольких (рядом стоят самодистилляция в духе DINOv3 и реконструкция в духе MAE), которое выделяется явной рамкой модели мира и отличной совместимостью с планированием. Полная иерархическая H-JEPA с длинным горизонтом, со скрытыми переменными для многовариантного будущего и с интегрированными актором, критиком и памятью, всё ещё остаётся пока в планах на будущее.
Но базовый тезис всё равно интересен: интеллекту нужны представления, заточенные под предсказание управляемой и устойчивой структуры мира, а не под воспроизведение каждого наблюдаемого пикселя или символа. И этот тезис за тридцать лет не просто не сломался, а только обрастал всё более убедительными реализациями. Так что даже если конкретно семейство JEPA застопорится и не сможет опередить “обычные” языковые модели, ставка Лекуна на “предсказывать смысл, а не пиксели” уже изменила то, как мы думаем об обучении представлений.
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
Основную часть работы здесь сделали наши коллеги-психологи из Института психологии РАН, я там был относительно сбоку и подключился на позднем этапе, так что ни на какие лавры тут не претендую. Но расскажу вам вкратце, о чём это было.
Постановка задачи
LLM всё чаще запускают как адаптивных интервьюеров (adaptive interviewers) в качественных исследованиях по психологии и социологии: модель ведёт полуструктурированное интервью, сама решает, где копнуть глубже, сама задаёт уточняющие follow-up вопросы.
Звучит очень удобно и логично: живого интервьюера трудно масштабировать на сотни глубоких бесед, для этого LLM и нужны (как, например, нужны и как индивидуальные тьюторы в образовании). Но сразу встаёт вопрос: а хорошо ли модель это делает? Эмпатичны ли её вопросы, уместны ли, не наводящие ли, не спрашивает ли она там, где ответ и так исчерпывающий? Систематически это то ли никто не измерял, то ли измеряли довольно плохо.
Что сделали
Коллеги собрали модульного агента (на LangGraph), который ведёт интервью по некоторому опроснику. Картинка с диаграммой выглядит сложно, но на самом деле там очень простая и логичная структура:
В случае нашей статьи опросником было большое очень длинное психологическое интервью (часа на полтора-два, если всерьёз отвечать), из 54 вопросов — биография, семья, ценности, работа, здоровье и так далее.
На каждом ответе агент сам выносит бинарное решение “нужен follow-up или нет” и формулирует его. Чтобы честно сравнивать модели, зафиксировали всё, что можно: контекст (десять реальных человеческих интервью как затравка), оркестрацию агента (одинаковые промпты, guardrails, логика повторов и т.п.). А главное, зафиксировали самого интервьюируемого — разумеется, это был не человек, а LLM с фиксированным Big Five профилем.
Прогнали шесть моделей (эксперимент был в начале года, а может, и в конце предыдущего, так что модели уже устаревшие, но смысл, конечно, не в конкретных версиях): Claude Sonnet 4, Gemini 2.5 Pro, GPT-5, Grok 4, Qwen3-235B и DeepSeek V3.1.
Дальше три эксперта-психолингвиста разметили кучу вопросов, которые модели задавали, по пяти бинарным критериям. Для follow-up вопросов, которые придумывали сами модели, оценивали доброжелательность, необходимость, внимание к контексту и открытость, а для основных вопросов, где модель не задала ни одного уточняющего вопроса, оценивали оправданность этого решения. Аннотаторы оказались очень неплохо согласны между собой (каппа Флейсса 0.67–0.93).
Результаты
Получились на удивление внятные профили:
Gemini 2.5 Pro — самый эмпатичный тон (“спасибо, что поделились таким личным опытом”) и лучший общий ранг; согласитесь, не совсем то, чего по умолчанию ждёшь от Gemini;
GPT-5 — быстрый и избирательный: задаёт меньше всего follow-up’ов, зато самые оправданные;
Grok 4 — исчерпывающий до предела: больше всего вопросов, самые длинные и самые навязчивые (в одном интервью он 24 раза припомнил респонденту его высокий уровень невротизма);
Claude Sonnet 4 — сбалансированная универсальная модель;
Qwen3 — формальный и структурный, но чудовищно медленный (сутки на прогон);
а вот DeepSeek просто развалился и не смог даже придерживаться схемы опросника (45 ошибок на уровне формата в течение трёх интервью).
Кроме того, выяснилось, что лингвистические маркеры (местоимения, вид/время глагола, интенсификаторы, синтаксическая сложность) осмысленно коррелируют с оценками экспертов, то есть стилистика реально влияет на воспринимаемое качество интервью. Вот таких вот табличек в статье сразу несколько:
Заключение
Мораль здесь на самом деле простая: модель надо выбирать под конкретную задачу. Причём вряд ли есть смысл делать выводы на уровне “Gemini для чувствительных тем, а Grok — если нужна дотошность”: очевидно, что все такие выводы уже давно протухли, и могут меняться с каждым новым релизом.
Так что реальный вывод в том, что модели разные, а предложенный протокол их оценивания действительно работает. И если вы используете LLM для каких-нибудь психологических интервью, то стоит, во-первых, оценить текущие модели по похожему протоколу (пусть даже не так масштабно), а во-вторых, зафиксировать их версии для использования потом в production.
Большое спасибо соавторам!
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
Она про геометрию того, что происходит с нейросетью, когда мы её дообучаем, — и про то, почему так много разных способов “редактировать” уже обученную модель оказываются по сути линейными.
В этом посте я хочу рассказать и про мотивацию, и про результаты, а заодно дать общее введение в тему. Технических деталей будет немало — будут и теоремы, и формулы, — но я постараюсь, чтобы всё было понятно, а главное, чтобы было видно, как отдельные кусочки складываются в одну довольно-таки стройную картину.
Линейное дообучение: все хотят двигать модель по прямой
Начнём с наблюдения, которое в последние пару лет стало общим местом. Если у вас есть обученная модель (скажем, LLM) и вы хотите поменять её поведение — добавить навык, убрать нежелательную склонность, усилить какую-то черту, — то очень часто оказывается, что для этого достаточно сдвинуть параметры или активации вдоль одного линейного направления. Причём это работает в самых разных постановках.
В пространстве весов есть целое семейство методов, которые этим занимаются. Task vectors (Ilharco et al., 2022) предлагают вычислять “вектор задачи” как разность дообученных и исходных весов, а потом складывать и вычитать эти векторы, как будто они живут в обычном линейном пространстве. Примерно как word2vec арифметика в своё время:
Model soups (Wortsman et al., 2022) усредняют веса нескольких дообученных моделей и получают модель лучше каждой из исходных.
TIES-merging (Yadav et al., 2023) старается аккуратно разрешать конфликты между такими дельтами при слиянии:
Ну и совсем общеизвестное: LoRA-дообучение (Hu et al., 2021) ведь тоже с самого начала исходит из гипотезы, что дообучение может жить в низкоранговом срезе матриц весов, и потому учит только добавочку малого ранга.
В пространстве активаций происходит ровно то же самое, только методы по-другому называются. Activation addition (Turner et al., 2023) строит steering-вектор (вектор управления) как разность активаций на контрастных промптах и просто прибавляет его к скрытому состоянию. Function vectors (Todd et al., 2023) находят компактные векторные представления функций, выученных в контексте. Representation engineering (Zou et al., 2023) предлагает целую методологию мониторинга и управления поведением через линейные направления в пространстве представлений. А ReFT (Wu et al., 2024) обучает низкоранговые вмешательства прямо в активациях, а не в весах.
Как видите, приёмы разные, а идея одна и та же: нужная структура имеет малую размерность и локально линейна. И тут возникает естественный вопрос: а какая, собственно, линейная структура реально есть в обученной сети? Где она живёт — в весах или в активациях, локально или глобально? И как далеко можно двигаться вдоль неё, прежде чем линейность закончится?
Есть и более провокационная версия этого же вопроса. Совсем недавно вышла работа “Neural Thickets: Diverse Task Experts Are Dense Around Pretrained Weights” (Gan, Isola, 2026), в которой авторы утверждают, что достаточно хорошо предобученная модель окружена плотными “зарослями” (thickets) полезных направлений, и их можно найти, просто насэмплировав случайных возмущений параметров, оставив те, что помогают, и сложив их в ансамбль.
Это очень контринтуитивно: если бы полезные направления были редкими иголками в стоге сена размерности , случайный поиск не находил бы их никогда. А он находит.
Историю про случайный поиск в высоких размерностях продолжают и более ранние работы по zeroth-order и эволюционным методам — MeZO (Malladi et al., 2023) и evolution strategies (Salimans et al., 2017); все они показывают, что случайный поиск при правильном масштабе действительно двигает большие модели в полезную сторону.
Именно с этого мы и начали. Случайный поиск, очевидно, не конкурент градиентному спуску: на чистой точности градиент всегда выигрывает. Но его можно использовать как измерительный прибор. Если возмущения, насэмплированные внутри одного подпространства, при одинаковом размере шага работают устойчиво лучше, чем возмущения из другого подпространства, это говорит нам, какое из подпространств лучше согласовано с задачей. Случайный поиск здесь не метод оптимизации, а зонд (в смысле probe) локальной геометрии. И вся статья, по сути, отвечает на вопрос: что именно этот зонд нам говорит?
Восстановление после забывания
Чтобы изучать локальную геометрию, нам нужна точка отсчёта, ground truth: известный, заведомо рабочий сдвиг параметров, с которым можно сравнивать всех кандидатов. Откуда его взять? Мы устроили специальный экспериментальный цикл — восстановление после забывания (recovery after forgetting), — который даёт такую мишень в чистом виде.
Цикл состоит из трёх фаз.
Мультизадачное обучение. Учим небольшую сеть на равной смеси из задач до контрольной точки .
Доучивание на одной задаче (забывание). Продолжаем учить только на одной задаче, доходя до точки , в которой одна или несколько других задач успели деградировать. Это и есть катастрофическое забывание.
Восстановление. Из делаем небольшое число шагов градиентного спуска обратно на исходной смеси (мы берём 100 шагов для синтетической модели и 50 для LoRA), приходя в точку .
Теперь у нас есть сдвиг восстановления:
то есть конкретная, специфичная для задачи адаптация, которую произвёл сам градиентный спуск. Это и есть наша честная мишень: мы можем брать разные маленькие подпространства и спрашивать, насколько хорошо каждое из них содержит .
Здесь хорошо будет привести нашу тизер-картинку; хоть она и забегает вперёд по сравнению с тем, где мы сейчас находимся, она как раз иллюстрирует все эти обозначения:
Подчеркну, что в самих теоретических результатах нет ничего специфичного именно для забывания — то же самое относится к любой небольшой градиентной адаптации вокруг контрольной точки; просто в сценарии с забыванием есть удобный правильный ответ .
Кандидатов на “правильное подпространство” у нас три, точнее, целых три их семейства:
локальное подпространство задачи (local task subspace) — линейная оболочка топ- собственных векторов матрицы ковариации градиентов сети, посчитанных в точке ; это и есть то самое “естественное” подпространство, которое часто неявно предполагается в упомянутых выше методах;
префикс траектории (trajectory prefix) — линейная оболочка первых шагов восстановления
по построению весь лежит в оболочке всей траектории, но здесь речь о том, что и короткого префикса, первых нескольких шагов может хватить, чтобы поймать основную часть нужного подпространства;
явный крыловский базис (explicit Krylov span) в точке , построенный через произведения гессиана на вектор (в реальности вычисленные через конечные разности); его мы используем как диагностику кривизны, а не как реальный базис; забегая вперёд, скажу, что он ловит лишь около 11% сдвига восстановления против 77% у префикса траектории, и почему так — это интересный вопрос.
А результаты случайного поиска мы оцениваем тремя способами, потому что они отвечают на разные вопросы:
best-of- — выигрыш одного лучшего из кандидатов (именно про эту величину наша теорема);
ens--of- — выигрыш ансамбля из топ- кандидатов по голосованию;
pass@ — доля тестовых примеров, решённых хотя бы одним из отобранных кандидатов; это верхняя граница, потолок для идеального “селектора”, выбирающего из вариантов.
Стоит сказать, что структура низкой размерности в весах — это вообще не новость. То, что многие задачи решаются в маленьком случайном подпространстве, люди знают как минимум со времён работ про intrinsic dimension (Li et al., 2018); то, что независимо обученные сети соединяются простыми кривыми малых потерь, показала серия работ про mode connectivity (Garipov et al., 2018) — и здесь большой очередной привет Дмитрию Ветрову!
Наш вклад в эту историю — временная ось: для восстановления после забывания релевантная низкоразмерная структура оказывается не статичным базисом, а движущимся пучком, который следует за траекторией.
Но об этом чуть ниже, а сначала — немного теории, потому что без неё непонятно, почему всё это вообще должно работать. Теорию можно без особых потерь для дальнейшего пропустить, все детали тут будут интересны только математически подготовленному читателю.
Теория: почему случайный поиск вообще что-то находит
Самый контринтуитивный факт во всей этой истории — что случайный поиск работает в пространстве размерности . Давайте разберёмся, почему.
Теорема (гауссовский best-of- в локально-линейной окрестности). Рассмотрим чекпойнт и его окрестность, где приращение оценки ведёт себя линейно:
для фиксированного полезного направления. Посэмплируем и выберем лучший сэмпл, . Тогда верно следующее.
Каждая проекция — центрированный гауссиан с дисперсией , не зависящей от размерности .
Ожидаемый выигрыш best-of- равен
что растёт с бюджетом, но не с .
Для любого (направление посторонней побочной задачи) у выбранного кандидата , а типичная величина , и она не зависит от .
Доказательство тут совсем короткое и стандартное. Для величина — центрированный гауссиан с , что даёт пункт 1.
Дальше нормируем, , и применяем классический результат из теории экстремальных значений:
и это пункт 2.
Наконец, являются совместно гауссовскими с ковариацией ; если , они независимы, и обусловливание на то, что мы их выбрали (а это событие зависит только от ), оставляет , что даёт пункт 3.
Главное здесь — первый пункт. Хотя сэмплер размазывает свою дисперсию по всем координатам, “количество полезного направления” в одном случайном векторе имеет дисперсию , которая не сжимается с ростом . То есть даже на масштабе LLM случайный поиск не безнадёжен: сигнал на один сэмпл одинаков для любых , даже гигантских.
Best-of- усиливает этот сигнал привычным гауссовским множителем , растущим с бюджетом. А третий пункт — это та самая асимметрия, ради которой всё затевалось: отбор по в среднем вообще не двигает ортогональное направление , и даже случайный “снос” не растёт с бюджетом. Польза концентрируется на цели и растёт с , а вред по соседям размазывается и не растёт.
Два графика внизу это иллюстрируют. Во-первых (слева), ожидаемый best-of-N сигнал для размерностей ложится на одну и ту же кривую и похож на асимптоту ; во-вторых (справа), движение по ортогональному побочному направлению плоское по и одинаковое для всех :
Почему это контринтуитивно? Потому что в высоких размерностях случайный вектор почти ортогонален , и наивно кажется, что чтобы найти согласованный, нужно будет экспоненциальное число попыток.
Так и есть — но для угла, который концентрируется около 90°. А угол здесь не совсем та величина, которая нас интересует: проекция — это произведение (действительно исчезающего) косинуса и растущей как длины, и эти два эффекта сокращаются, оставляя независимым от .
Из теоремы, казалось бы, следует, что при сравнении подпространств выигрывать должно то, в котором содержится больше всего . Так вот, это неверно — по крайней мере, при фиксированном размере шага.
Утверждение (поиск с фиксированной нормой предпочитает плотность, а не массу). Ограничим сэмплирование подпространством размерности , сэмплируя с , равномерным на единичной сфере . Тогда
Иначе говоря, сигнал поиска на одно измерение масштабируется как : если добавить в направления, ортогональные , то вырастет, не изменится — и сигнал упадёт. Доказательство здесь опять в одну строчку: для равномерного на сфере по симметрии , откуда .
Это очень важная для нас мысль: при фиксированном шаге значима плотность сигнала , а не его масса. Подпространство ранга 32, целиком содержащее , имеет плотность , и это хуже, чем у подпространства ранга 10, содержащего 77% от . Именно эти цифры мы потом и увидим в экспериментах.
Наконец, что вообще представляет собой направление восстановления? Здесь тоже есть короткая лемма.
Лемма (крыловское восстановление). Пусть квадратична с постоянным гессианом на окне восстановления, и
Тогда , и
Иначе говоря, сдвиг восстановления лежит в крыловском подпространстве размерности не больше (значит, он имеет малую размерность), но одно фиксированное направление ловит его лишь в вырожденном случае, когда градиент оказывается собственным вектором гессиана, а фиксированное подпространство — только если гессиан переводит его в себя ().
Для глубокой сети в забытом чекпойнте ни то ни другое не выполнено. Значит, объект восстановления низкоразмерный, но движущийся: старшие члены по мере разворачивания траектории всё время подмешивают новые компоненты. Отсюда и главная мысль из названия статьи: recoverable (восстановимо, низкоразмерно) but not stationary (движется).
Рисунок внизу это иллюстрирует. Слева видно, что путь изгибается — суммарный сдвиг не совпадает с начальным направлением и вообще ни с каким фиксированным направлением; а справа показано, как направление шага поворачивается по мере разворачивания траектории (сначала быстро, потом очень медленно):
И последний кирпичик — мостик между весами и активациями. Если сдвинуть веса на , то активация каждого слоя сдвинется на
то есть на пушфорвард (pushforward) весового сдвига в пространство активаций. А значит, если помогло задаче, то его усреднённая по примерам активационная “тень”
является хорошим кандидатом в steering-векторы с тем же эффектом первого порядка на потери. К этой мысли мы вернёмся в самом интересном эксперименте.
Что показывают эксперименты
Мы проверяли всё это на трёх масштабах:
полностью контролируемый синтетический трансформер, где мы видим всю геометрию;
Начнём с того, что можно полностью контролировать: 4-слойный, 128-мерный, двухголовый каузальный трансформер (около 500К параметров), обученный на четырёх процедурных задачах с последовательностями цифр — copy, reverse, sort и mod-add. Мультизадачное обучение идёт в течение 20К шагов, доучивание для забывания — ещё 10К, восстановление — не более 100 шагов; везде усредняем по трём запускам.
Сначала хорошие новости для “линейной гипотезы”. В мультизадачной точке минимума матрица ковариаций градиентов каждой задачи действительно низкоранговая — эффективный ранг между 2 и 8, исчезающая доля от числа параметров. Более того, задачи не ортогональны друг другу: средневзвешенное перекрытие их топ- подпространств по шести парам равно 0.11, что на четыре порядка выше ожидаемого значения при случайном их выборе. Это значит, что низкоразмерная структура отдельных задач реальна и вдобавок между задачами есть что-то содержательно неслучайно общее (но не так много, всего 0.11).
Но низкоранговость и почти-ортогональность не спасают от забывания. После доучивания на одной задаче точность худшей из других падает на 0.56–0.95, что подтверждается даже у пар, чьи подпространства перекрываются меньше чем на 0.10. Жить в почти ортогональных подпространствах оказывается недостаточно для того, чтобы не мешать друг другу.
И здесь мы приходим к центральному отрицательному результату. Мы сравнили три способа восстановления при одинаковом шаге: полный градиентный спуск, спуск с градиентом, перепроецированным на каждом шаге на подпространство задачи в забытой точке, и градиент, перепроецированный на чистое подпространство до забывания.
Полное восстановление даёт exact-match 0.30, а обе проекции на статичное подпространство — лишь 0.10 и 0.07. То есть подпространство задачи, измеренное ровно в той точке, где задача была обучена, содержит меньше трети того, что достигает свободное восстановление. Более того, само подпространство движется и “уезжает”: перекрытие топ- подпространств на шаге и на шаге 0 падает с 1.0 до примерно 0.12–0.17 за 100 шагов (оставаясь, впрочем, сильно выше случайного, в 2400 раз):
При этом размерность его не меняется, это именно дрейф ориентации пространства. Получается, что любое статичное подпространство промахивается мимо восстановления именно потому, что нужное подпространство всё время поворачивается.
И, наконец, давайте используем наш “зонд” — случайный поиск. Сэмплируя возмущения с фиксированной нормой внутри каждого подпространства на забытой задаче sort, мы получаем воспроизводимый и понятный результат:
Это best-of- выигрыш, та самая метрика из теоремы, но две другие метрики — ансамбль и pass@N — дают ровно тот же порядок. Причём, ровно как предсказывает наше утверждение про плотность, префикс траектории выигрывает несмотря на меньший ранг. А использование подпространства задачи (ранга 48) вдоль траектории не помогает, хотя и содержит ответ: лишние направления почти ортогональны сигналу восстановления и только размывают его.
LoRA на DistilGPT-2 и GPT-2: главный количественный результат
На синтетике всё сходится, но это одна архитектура с игрушечными задачами. Поэтому мы повторили все эксперименты на LoRA-адаптерах поверх двух настоящих предобученных моделей: DistilGPT-2 с адаптерами ранга 16 на паре sort → mod-add и GPT-2 с адаптерами ранга 8 на reverse →sort, по три запуска, всего шесть прогонов.
И вот тут получается наш самый чистый количественный результат — про массу проекции, то есть про то, какую долю сдвига восстановления содержит каждое подпространство. Базис из первых 10 шагов восстановления содержит около 77% от ; первые 20 шагов — около 90%; полная траектория, понятно, все 100% по построению.
А статичные подпространства ловят гораздо меньше: локальное — около 15%, до забывания — меньше 2%. Нужный нам объект следует за траекторией, а не сидит в фиксированном пространстве малой размерности, и это подтверждается на обеих моделях. Появляется та самая временная ось: там, где работы про intrinsic dimension и mode connectivity говорили о статичной низкоразмерной структуре, при восстановлении забытых задач она оказывается движущейся.
Здесь опять два графика; слева масса проекции по подпространствам (среднее и разброс по 6 прогонам); справа предсказанная плотность (столбики) против наблюдаемого best-of-N выигрыша (точки), и видно, что они идут вместе:
Самое приятное здесь то, что масса проекции вместе с нашим утверждением про плотность предсказывает, как хорошо сработает случайный поиск внутри подпространства: поиск с фиксированной нормой извлекает сигнал плотности .
И прогноз сбывается! Best-of-N (та метрика, про которую теорема) точно следует за плотностью: префикс ранга 10 (0.165) лучше полной траектории ранга 16 (0.134) примерно в те самые раза, что предсказывает утверждение, а деление каждого выигрыша на делает порядок монотонным.
Интересно, что три метрики при этом немного расходятся — и расходятся ровно так, как предсказывает теория.
Ансамбль (ens-k-of-N) более снисходителен к большому подпространству (префикс 0.191 против полной траектории 0.182, почти ничья): объединение многих кандидатов размывает штраф за плотность. А pass@N просто отслеживает массу: чем больше содержит подпространство, тем выше потолок. Главный вывод мы делаем из best-of-N, где теория применима напрямую.
Полезно заглянуть и внутрь средних по семействам — на отдельных кандидатов. На рисунке около 1200 кандидатов из 6 прогонов:
Здесь можно увидеть две вещи. Во-первых, возмущения, которые улучшают задачу, — это в основном те, что согласованы с направлением градиентного восстановления: косинус кандидата с коррелирует с его выигрышем (), а поиск иногда даже чуть обыгрывает один шаг градиента, находя более удачный масштаб вдоль примерно того же направления. Во-вторых, перекрытие кандидата со статичным локальным подпространством задачи успех не предсказывает, а скорее анти-коррелирует (): из этого подпространства сигнал восстановления почти целиком убирает проекция.
Есть из этой картины и практический вывод. Гипотеза о движущемся подпространстве делает конкретное предсказание про мультизадачное дообучение: если довести одну задачу до конца и только потом добавить вторую, локальное пространство первой от этого “уедет”, а значит, последовательная специализация должна быть хрупкой.
Так и получается: на обеих моделях расписания, которые обновляют задачи вместе (простая сумма градиентов, чередование, PCGrad-lite в духе Yu et al., 2020), добиваются точности худшей задачи на порядок выше, чем расписания, которые сначала доучивают одну задачу до конца и лишь потом берутся за другую.
Тут стоит сказать, что вокруг конфликта градиентов в мультизадачном обучении выросло целое семейство методов: PCGrad, MGDA, GradNorm, CAGrad. Да и регуляризаторы для continual learning вроде EWC и GEM про то же. Мы не пытаемся добавить ко всему этому многообразию ещё один оптимизатор, а всего лишь делаем диагностику; разные одновременные расписания в наших экспериментах кучкуются в паре пунктов друг от друга без явного победителя. Но вывод всё равно чёткий: последовательно учить задачи не надо.
LLM-масштаб: картина слегка мутнеет
Синтетика и LoRA дают полное совпадение с теорией до обучаемых параметров. А что будет на моделях с миллиардами параметров? Здесь мы честно задаём три вопроса, и так же честно отвечаем, в том числе там, где доказательств меньше, чем хотелось бы.
Выживает ли низкоранговая геометрия? Лишь отчасти. На Qwen2.5-0.5B мы оцениваем ковариации градиентов через случайный скетч и считаем эффективные ранги — их значения очень малы, от единиц до полутора десятков. Но маленький эффективный ранг по нескольким десяткам минибатчей в пространстве размерности может быть артефактом сэмплирования, а не свойством задачи.
Поэтому мы также добавляем “контрольную группу”: заменяем каждый градиент гауссовским вектором той же нормы и переоцениваем ранг тем же пайплайном. В результате на Qwen-3B при ограничении на MLP-слои измеренный ранг явно ниже контроля (там низкий ранг настоящий), а на Qwen-7B измеренный и контрольный ранги практически совпадают — и видимая низкоранговость неотличима от шума.
Так что чистый низкоранговый результат установлен на маленьких моделях и LoRA, а на миллиардных масштабах выживает лишь частично. Это, пожалуй, самое слабое место из всех наших утверждений в статье: мы не установили, что низкий ранг на миллиардах параметров сохраняется.
Находит ли случайный поиск улучшения — и в каком режиме? Теорема работает только там, где потери примерно линейны по возмущению, а значит, и весь результат про управление активациями ниже надо проверять при этом условии. Поэтому сначала надо этот режим найти, отделив линейную часть эффекта возмущения от вклада кривизны.
Мы делаем это напрямую; считаем симметричные конечные разности:
где — антисимметричная (линейная) часть, а — симметричная (кривизна). Прогоняя масштаб , видим, что на Qwen2.5-0.5B линейная часть доминирует около , а выше кривизна берёт верх, и случайные ходы становятся разрушительными. И этот режим зависит от задачи: у BoolQ и HellaSwag есть здоровая полоса линейных и выпуклых направлений, а ARC-Easy на всех масштабах задавлена вогнутыми направлениями — это как раз случай, когда никакого предпочтительного направления нет и случайный поиск вырождается в шум.
Внутри же предсказанного окна теорема подтверждается: best-of-N при даёт возмущения, чей результат после объединения в ансамбль на отложенном BoolQ поднимает точность примерно на 10 пунктов, и урон по другим задачам остаётся маленьким.
А теперь самое интересное.
Можно ли из полезного весового возмущения сделать steering-вектор? Здесь работает наш пушфорвард, и это, по-моему, самый красивый результат статьи.
Чистая версия: один шаг градиента — это и есть steering-вектор. На Qwen2.5-0.5B (в формате “истинных/ложных” утверждений) мы делаем один шаг градиента, проталкиваем полученный весовой сдвиг в активации каждого слоя и сравниваем с контрастным (true-minus-false) CAA-вектором (centroid-based activation addition, в духе Rimsky et al., 2023), построенным независимо из размеченных промптов.
Два направления хорошо согласуются на поздних слоях: косинус растёт через средний блок декодера и достигает около 0.58 на слоях 19–20 — ровно тех, откуда обычно и берут steering-векторы, — и только при том самом промежуточном learning rate , который анализ пометил как линейный.
При шаг выходит из линейного режима, и согласованность рушится. А если впрыснуть градиентный сдвиг обратно в чистую модель, кривая отклика близко повторяет кривую CAA-вектора и поднимает точность примерно на 10 пунктов. Модель ведёт себя почти одинаково, пришёл ли steering-вектор из 80 размеченных контрастных пар или из одного шага градиента вообще без меток.
Шумная версия повторяет это, заменив честный шаг градиента случайным возмущением (отобранным по принципу best-of-N). Здесь пайплайн посложнее — сначала поиск кандидатов, потом усреднение их влияния на активации в steering-вектор, потом выбор “рабочей точки”, то есть слоя и масштаба впрыска, и финальный замер на отложенном наборе:
Мы прогнали это на 14 комбинациях (модель, задача) — Qwen2.5 на 0.5B/3B/7B и OLMo-7B. Структурированный перенос побеждает контроль (случайное направление той же нормы на том же слое) в 9 из 14 случаев, и эффект Qwen на BoolQ выживает на всех трёх масштабах. То есть получается не бесплатно и не универсально: на OLMo BoolQ, например, выигрыш +1.2 пункта на целевой задаче покупается ценой -17 пунктов на других задачах. Да и 9 из 14 — это не то чтобы очень убедительно.
Так что этот алгоритм получился реальным и часто полезным, но сильно зависящим и от задачи, и, что важнее, от архитектуры: на не-Qwen-семействе вроде OLMo перенос может оказаться небезопасным.
Более широкая проверка: что устояло?
А теперь самый потенциально неуютный шаг. Статью мы подали уже пару недель назад, и выложенный препринт примерно соответствует поданной версии (он разве что поподробнее). Но потом мы решили, что наши результаты нужно перепроверить более широко, и устроили безжалостный независимый стресс-тест всех наших утверждений.
Кстати, этот тест был сделан в большой степени автоматизированно, AI-агентами. Как вы знаете, тема того, как AI сам двигает науку, мне очень близка, я писал про неё недавно в постах про AI 2027 и опровержение гипотезы Эрдёша и много раз рассказывал, но сейчас не об этом.
Такая перепроверка всегда может оказаться смертельной для результатов. Точнее говоря, она может сильно ограничить результаты: вопрос не в том, верно ли мы всё сделали (скорее всего да), а в том, по каким осям — архитектура, масштаб, воспроизводимость, тип задачи — наши результаты подтверждаются, а где проходит граница. И, кажется, обошлось!
Геометрия восстановления воспроизводится широко. Главная находка — что восстановимый объект живёт в префиксе траектории, а не в статичном подпространстве — повторяется на пяти архитектурных семействах (Pythia/NeoX, GPT-Neo, OPT, TinyLlama/Llama, GPT-2) и доходит до 7B на всех четырёх проверенных семействах. Префикс везде уверенно превосходит и фиксированные, и согласованное по размерности случайное подпространство.
Он ловит около 0.41 сдвига восстановления, а другие методы буквально около нуля. Так что наш вывод устойчиво воспроизводится.
Кстати, тут обнаружилась важная поправка: сравнивать префикс размерности 10 с подпространством размерности 3 нечестно, потому что большее подпространство ловит больше чего угодно. Поэтому мы проверяли при согласованной размерности , и, конечно, всё равно всё получилось.
Так что с геометрией всё в порядке. А что с нашей леммой?
Важное уточнение. В статье мы отмечаем, что явный крыловский базис ловит куда меньше , чем эмпирический префикс, и потому пользовались префиксом как рабочим прокси.
Стресс-тест показал, что префикс — это не крыловское подпространство никакого оператора. Ни обычный крыловский базис , ни “правильный” предобусловленный базис для Adam , ни даже “дрейфующий” базис с пересборкой оператора в каждой точке траектории не приближаются к префиксу.
У нас уже есть идеи о том, почему так, но это ещё требует дальнейших уточнений.
Подтвердилось и то, чего нам в статье как раз не хватало. Мы измеряли дрейф мультизадачной траектории восстановления, но не вращение подпространства задачи вдоль однозадачной оптимизации. Этот недостающий замер мы провели, и оказалось, что однозадачное подпространство градиентной ковариации действительно вращается, причём больше 90% этого вращения завершается рано, уже к 48-му шагу:
Так что нестационарность подпространства подтверждается и на прямом измерении.
Воспроизводимость. Здесь не буду перегружать цифрами, но, в общем, множественные перезапуски показали, что практически все результаты воспроизводятся очень хорошо. Единственный по-настоящему хрупкий результат — это слабая корреляция между кривизной и точностью на downstream задачах. Но там и был слабый сигнал, который ещё и не следовал ни из чего серьёзного, так что по идее это и должно было быть ненадёжным.
При этих дополнительных тестах мы получили и ещё кое-какие результаты, но это уже будет отдельная история и отдельный разговор.
Как всё это складывается вместе
Попробую теперь собрать общую картину.
Наш итоговый вывод получается в каком-то смысле отрицательным. Неверно, что нет никакой линейной структуры — она есть! Но нет и единого глобального вектора задачи (task vector).
Оказалось, что обученные задачи дают локальную низкоразмерную структуру, которая сильно зависит от того, где и как смотреть. В общем чекпойнте градиенты задач концентрируются в маленьком подпространстве, которое даёт хороший базис для одного шага градиентного спуска. Вдоль траектории сдвиг восстановления живёт в крыловском подпространстве, хорошо приближаемом ранним префиксом этой траектории; это подтверждается и случайным поиском. А в пространстве активаций тень одного шага градиента близко повторяет контрастный steering vector на поздних слоях.
Объединяющая мысль простая: линейная структура в обученных сетях реальна, но локальна — она движется по мере обучения, зависит от масштаба и выглядит по-разному в весах и в активациях.
Мне кажется, что естественнее всего смотреть на это с дифференциально-геометрической точки зрения: трактовать маленькие весовые возмущения как бесконечно малые смещения на многообразии параметров и изучать локальную касательную структуру, которую порождает оптимизация. В отличие от двух самых популярных сейчас объяснений линейных феноменов — через механистические схемы признаков (feature circuits) или через переполненные представления, мотивирующие sparse autoencoders, — мы заходим не со стороны интерпретируемости, а со стороны геометрии оптимизации.
И с этой точки зрения многие наблюдаемые “линейные” феномены возникают сами собой. Нейросеть — дифференцируемая функция, обучение идёт по некоторым гладким траекториям с какой-то локальной геометрией (напомню в скобках свой недавний пост о геометрии ландшафта потерь, а именно о термодинамике нейросетей); и эти траектории действительно имеют малую размерность, но они не статичны.
Та же оптика объясняет и то, с чего мы начинали, — почему случайные возмущения вообще работают на масштабе LLM. В локально-линейном режиме гауссовский поиск эффективно находит направления, улучшающие задачу, размазывая побочные эффекты по ортогональным задачам; и сигнал на сэмпл при этом не зависит от размерности. Эта часть у нас сопровождается даже некоторыми теоретическими результатами, что в deep learning редкость.
Несмотря на то, что мы сделали независимое подтверждение, ограничения у работы всё равно, конечно, есть. Масштаб наших экспериментов невелик, и самые чистые результаты получаются на маленьком трансформере на 500К весов и на LoRA-адаптерах. А у префикса траектории есть и концептуальная проблема: кажется, что мы знаем, где живут хорошие направления, но превратить это в практический алгоритм нельзя, потому что чтобы узнать префикс, надо уже запустить восстановление, а тогда зачем он?..
Куда дальше? Здесь много разных направлений, и мы, конечно, продолжаем. Упомяну, например, один глубокий вопрос, который эта работа ставит, но не решает: почему вообще полностью обученные чекпойнты содержат рядом возмущения, способные резко улучшить конкретную задачу? Откуда берутся эти крайне избирательные локальные направления и когда они возникают — при предобучении, при дообучении, или это свойство самого ландшафта потерь? Это мне кажется важным продолжением наших исследований.
В общем, кажется, что мы нащупали правильную оптику, через которую разрозненные результаты о линейности и маленьких подпространствах становятся проявлениями одной локальной и подвижной геометрии. Большое спасибо Ирине за совместную работу над всем этим, и надеюсь, что самое интересное ещё впереди!
Сергей Николенко
P.S. Прокомментировать и обсудить пост можно в канале «Sineкура»: присоединяйтесь!
 — общее число цитирований;
 — индекс Хирша;
 — так называемый hm-индекс, в котором каждая статья учитывается с весом, обратно пропорциональным числу соавторов;
 — цитирования статей, у которых вы единственный автор;
 — цитирования статей, где вы единственный или первый автор;
 — цитирования статей, где вы единственный, первый или последний автор.
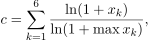
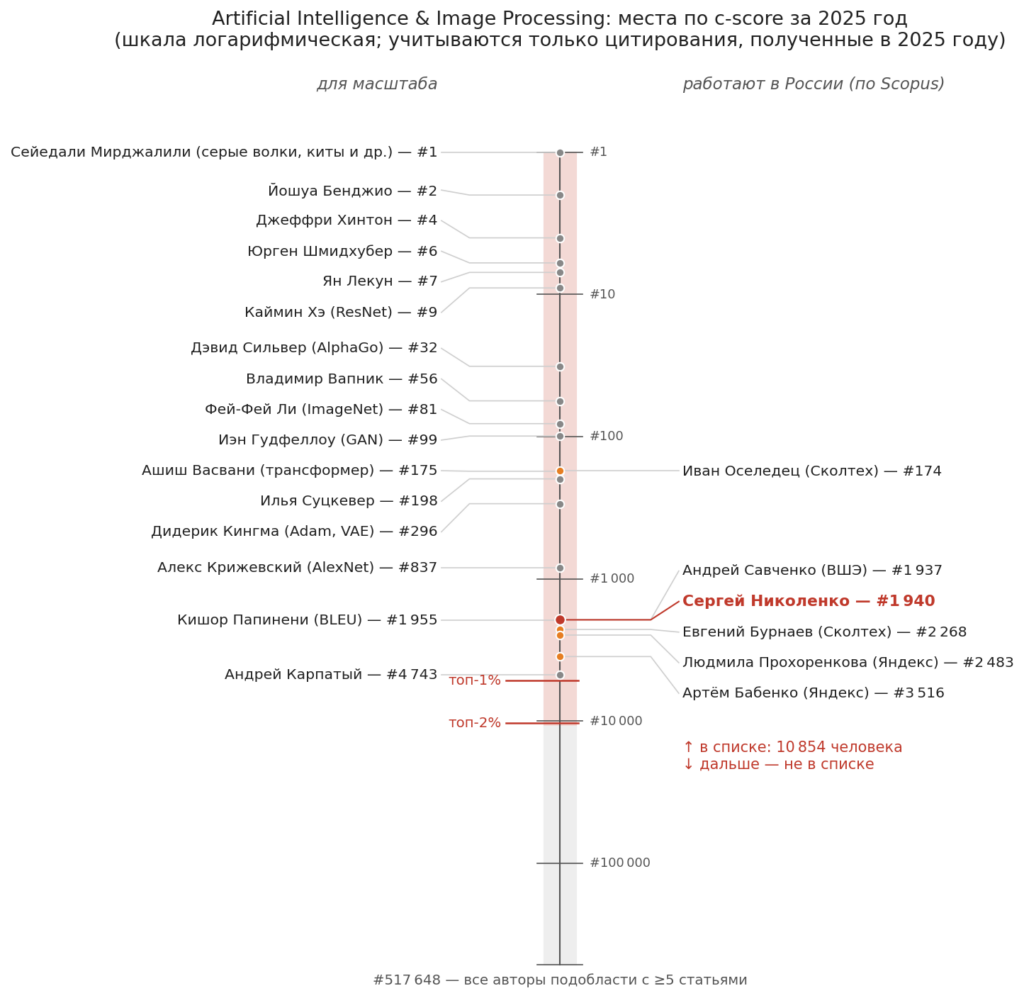
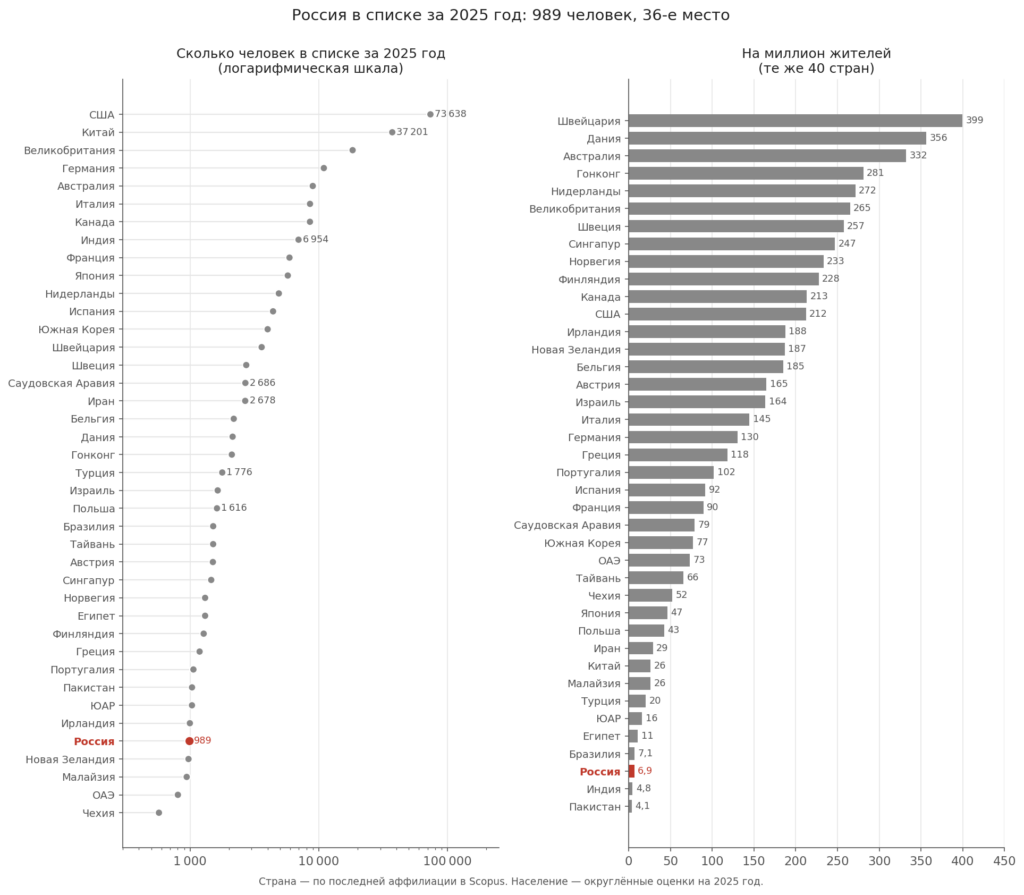
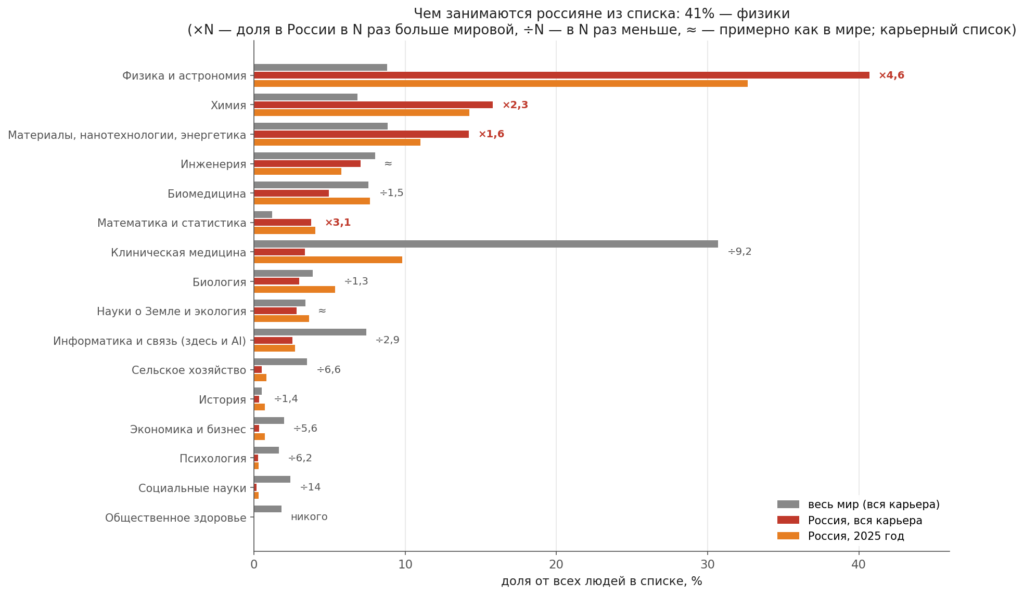
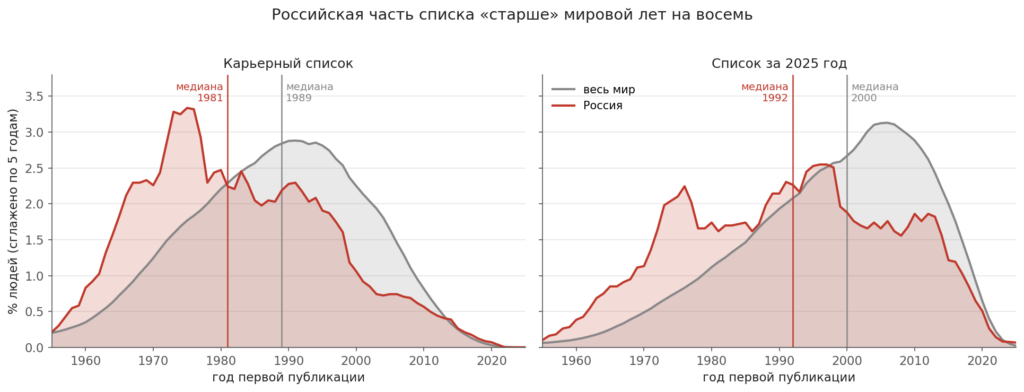
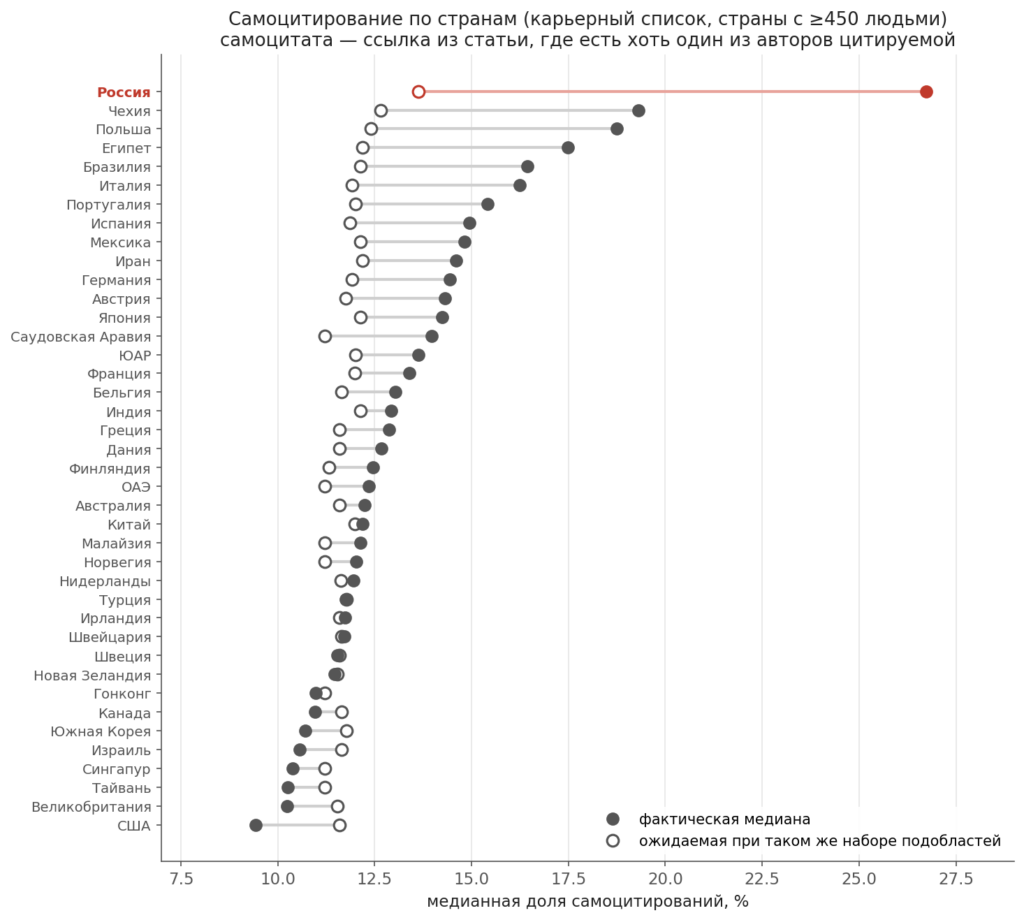
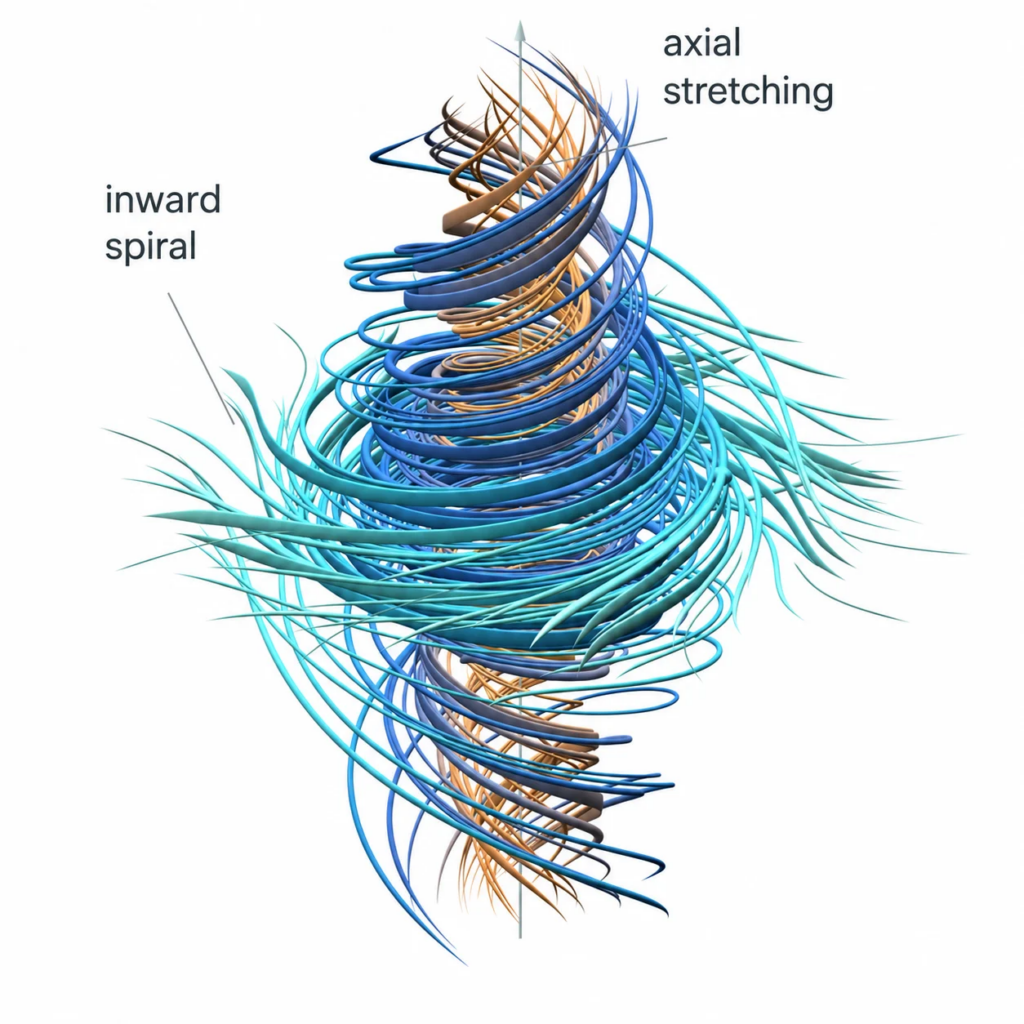
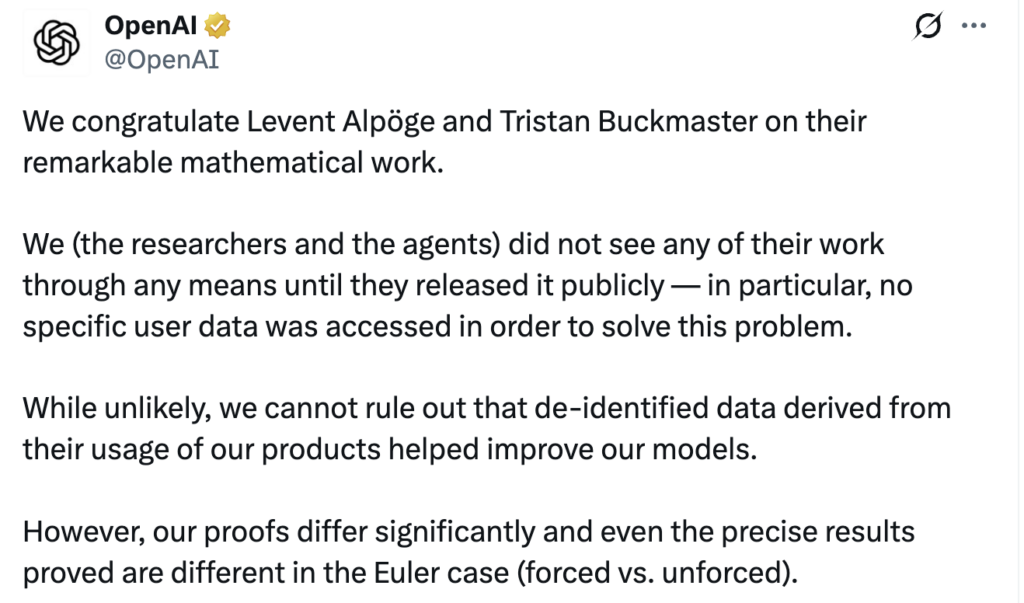
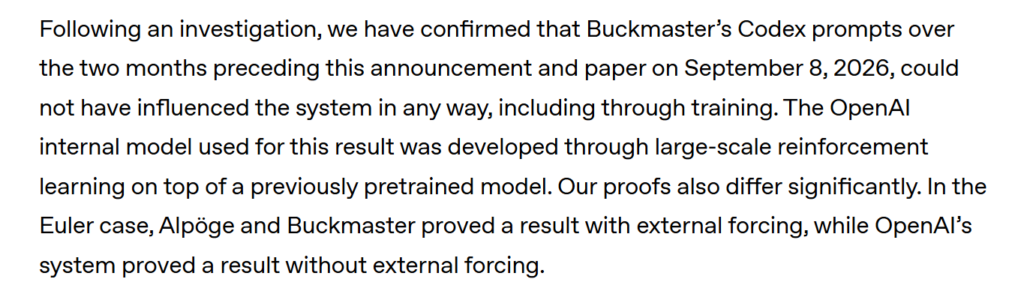
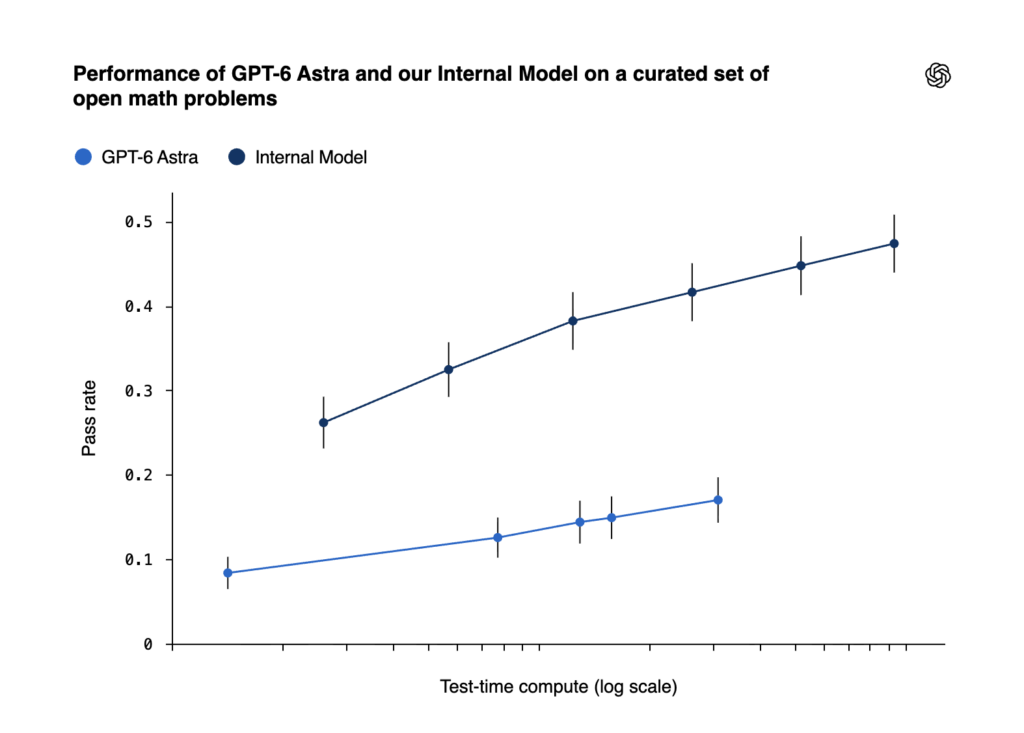
 до
 ,
 ; потом сообщество в лице Альфредо де ла Фуэнте докрутило её до
 прямым pull request’ом в
 , терминалами
 и заказами
 ; на дугах могут быть неотрицательные цены
 . Дан дробный поток
 , который можно делить по путям как угодно. Мы хотим получить неделимый поток
 : один путь на терминал, так что весь заказ идёт целиком по этому пути. Теорема Диница — Гарга — Гёманса (1999) говорит, что всегда можно добиться на каждой дуге выполнения условия

 .
 , имеет здесь цену минимум 60 при дробной цене 58.
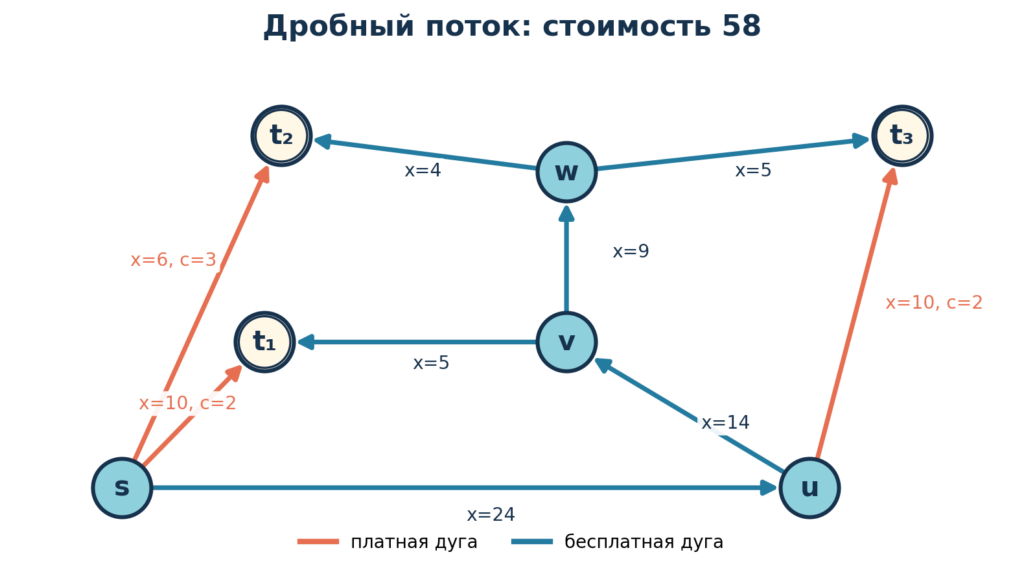
 , а неделимый может позволить себе не больше одного бесплатного выбора.
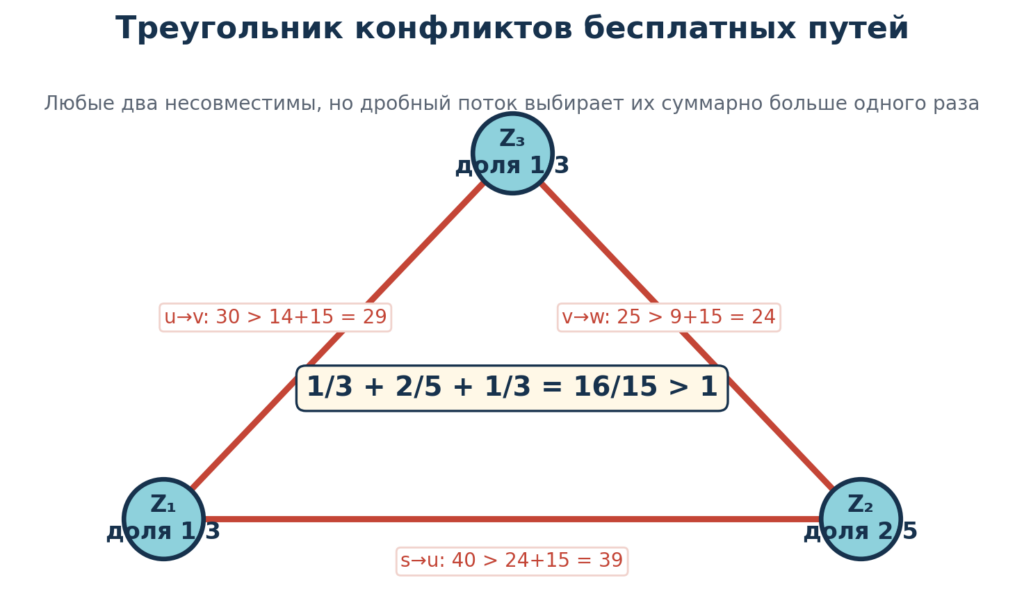
 : если разрешать перегрузку
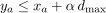 и требовать сохранения цены, то должно выполняться
 . Сверху же для планарных графов известна константа 2 (
 и
 для планарных графов, а для произвольных верхней оценки не было вовсе.
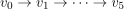 (“хребет” графа) и в каждый терминал отправляем ровно два выхода с хребта: ранний и поздний. Вот пример такого графа:
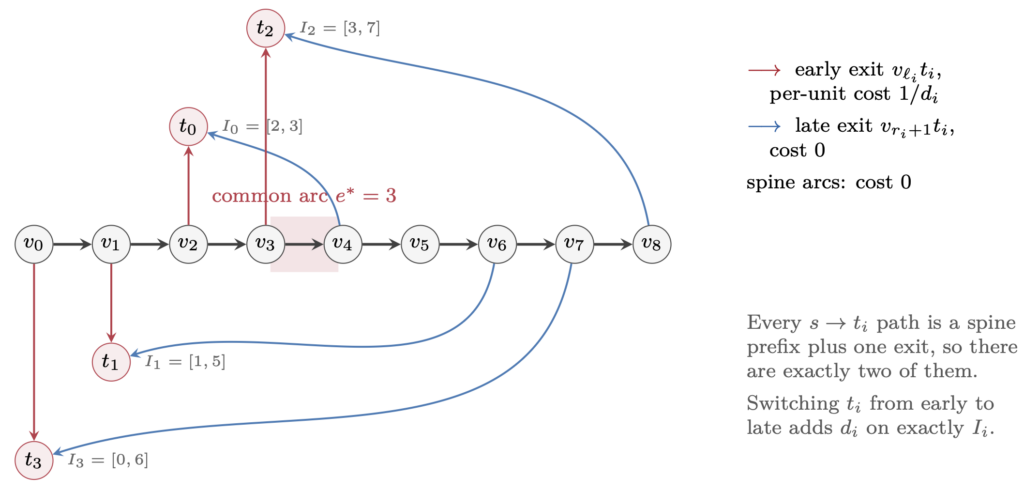
 ровно два пути; назовём их “ранний” (красный на картинке выше) и “поздний” (синий). Переключение терминала
 с раннего пути на поздний добавляет
 на дугах хребта, которые лежат в интервале
 , и получается, что вся комбинаторика такого примера описывается семейством интервалов:
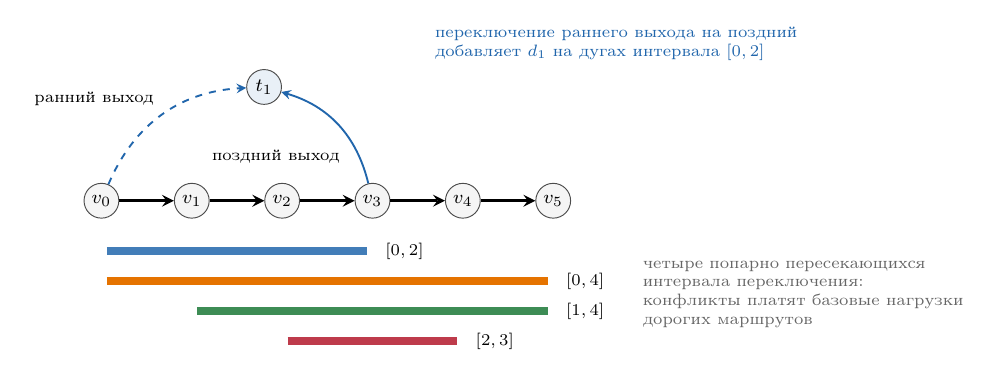
 ,
 ,
 ,
 :
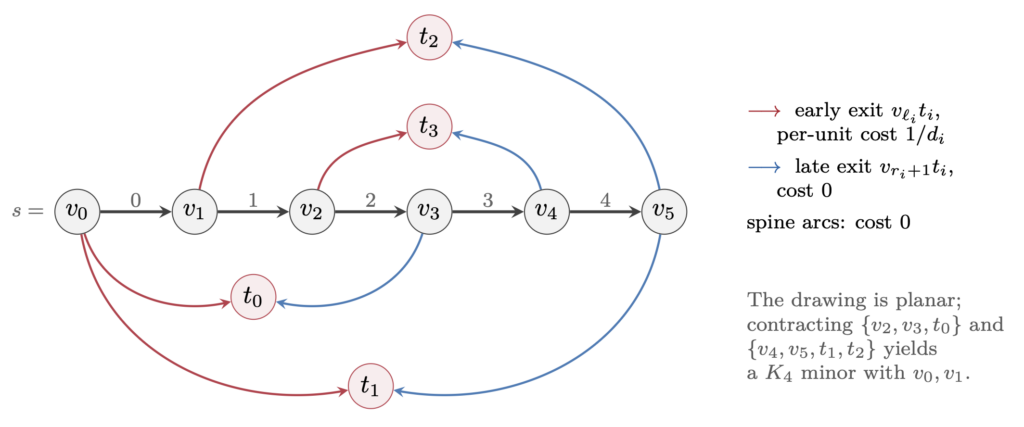
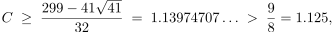
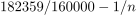 , так что всё можно реализовать и на рациональных данных (в целом это и так очевидно). И важно, что конструкция здесь планарная, так что зазор для планарных графов сузился до
 .
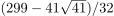 больше
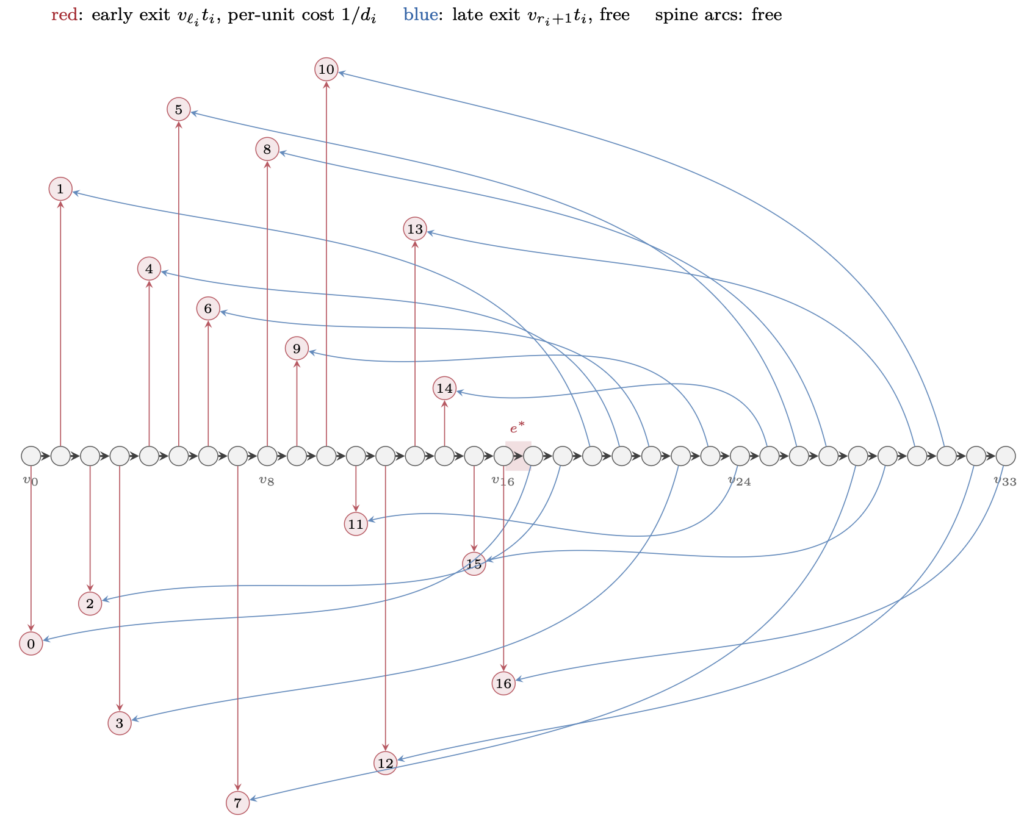
 — это спрос, а
 — доля дробного потока, которая отправляется на поздний путь; во всех случаях ранний выход к терминалу
 , а поздний выход бесплатный:
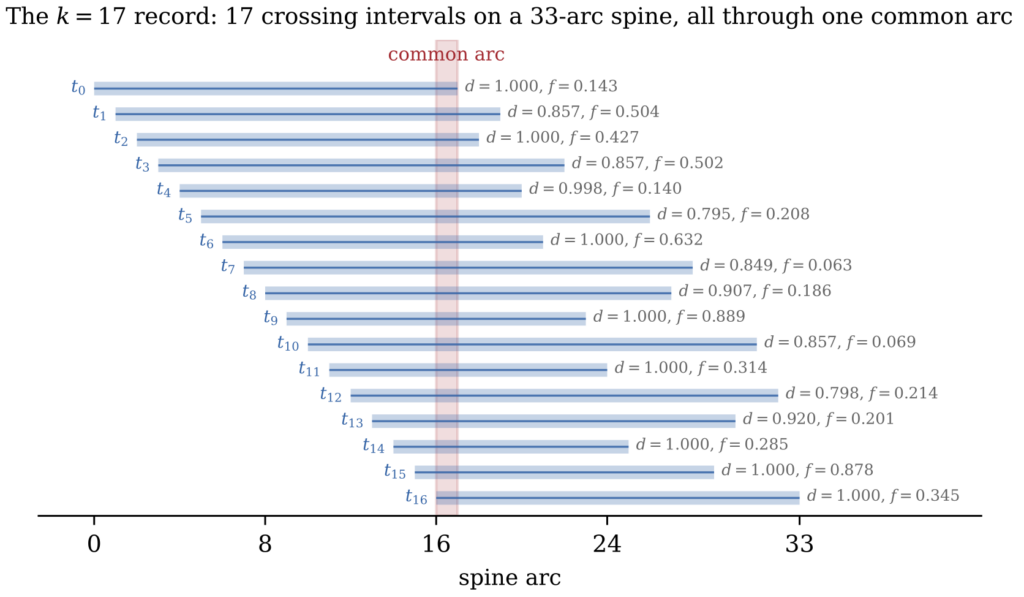
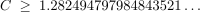
 , то есть никакое значение не превосходит удвоенного другого. Все семнадцать заказов в рекордном примере укладываются в одно двойное окно. Это не совпадение, и мы ниже объясним, почему так.
 . Это, конечно, верхняя оценка только на очень конкретный класс графов, то есть ограничение метода, а не какая-то интересная теорема сама по себе.
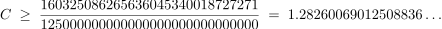
 .)
 выглядела так:
 :
 ,
 :
 ,
 :
 ,
 :
 ,
 :
 ,
 :
 .
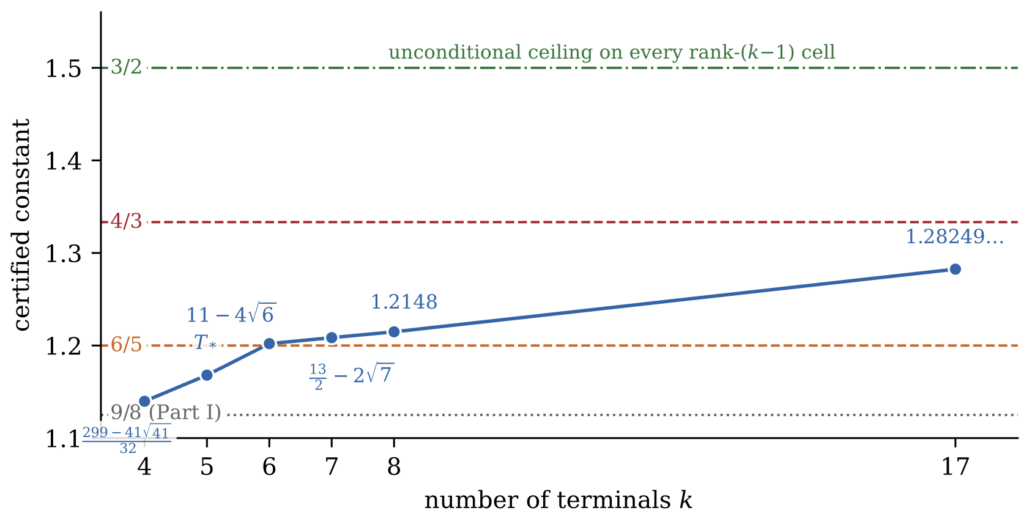
 было уже довольно много нижних оценок и удручающе мало верхних. Хуже того: для общих графов и произвольных заказов было неизвестно, существует ли вообще конечная константа
 почти наверное.
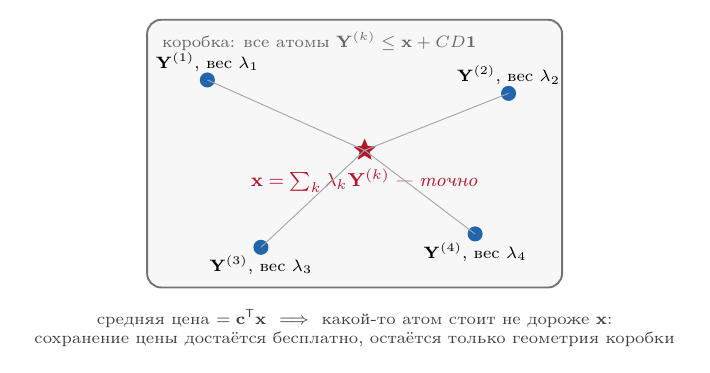
 , значит, какой-то атом стоит не дороже. После этого цены рёбер вообще исчезают из задачи, и остаётся чистая “геометрия” (ну, не настоящая геометрия, конечно): какого размера нужен “ящик”, чтобы
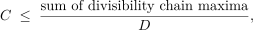
 — максимальное значение одного заказа, а оптимальное покрытие цепочками считается за полиномиальное время через паросочетание максимального веса.
 мультимножества заказов (множества терминалов) на цепочки делимости
 . Мы сможем построить нужный “ящик” радиуса
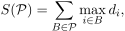
 :
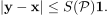
 именно как множество, без повторов, и если
 , то
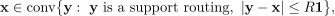
 (константу ещё на максимальное значение заказа нужно разделить).
 . Наивная сумма даёт
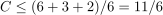 , но
 , поэтому покрытие
 стоит
 , и
 . Добавление значения 1 ничего не меняет — единица прицепится к любой цепочке бесплатно. А вот для попарно несравнимых
 никакое покрытие не побьёт простую сумму.
 , то
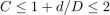 (это константа Морелла — Скутеллы, теперь доказанная для всех примеров с двумя значениями);
![(2^{-(j+1)}D,2^{-j}D]](https://blog.sergeynikolenko.ru/wp-content/ql-cache/quicklatex.com-fcf96d886b117f030ec4b2fb3add778e_l3.svg "Rendered by QuickLaTeX.com") не больше одного значения, то
 (достаточно их все просуммировать как
 );
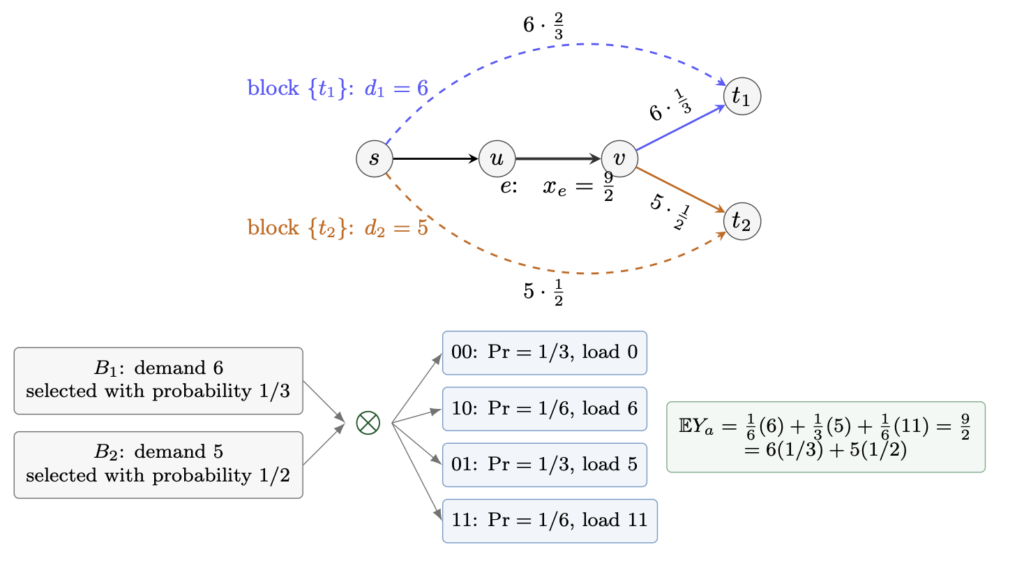
 (спрос
 ) использует общую дугу с весом
 , терминал
 (спрос
 ) с весом
 , так что нагрузка получается
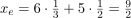 .
 путь в
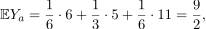
 .
 и глубиной сетки
 . Две первые его точки давно известны — это оценки Скутеллы
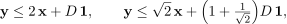
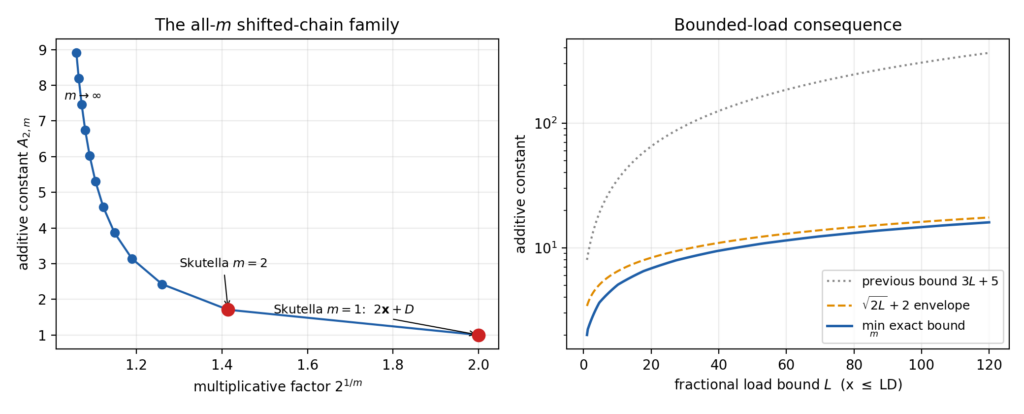
 : наилучшую аддитивную ошибку точного среднего для примеров, все заказы которых лежат в одном “двойном окне” вида
 . Тогда мы доказали, что
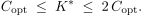
![(\frac12, 1]](https://blog.sergeynikolenko.ru/wp-content/ql-cache/quicklatex.com-4781ccf595f827f0dd3a70ad4e918a8f_l3.svg "Rendered by QuickLaTeX.com") , и более точное рассуждение о выпуклых оболочках показывает, что этот пример даёт
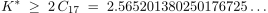
 ) невозможно — нижние оценки бьют и по этой цели. Полный точный профиль рекордного потока (все пятнадцать сегментов его релаксированной границы) мы тоже посчитали и выложили:
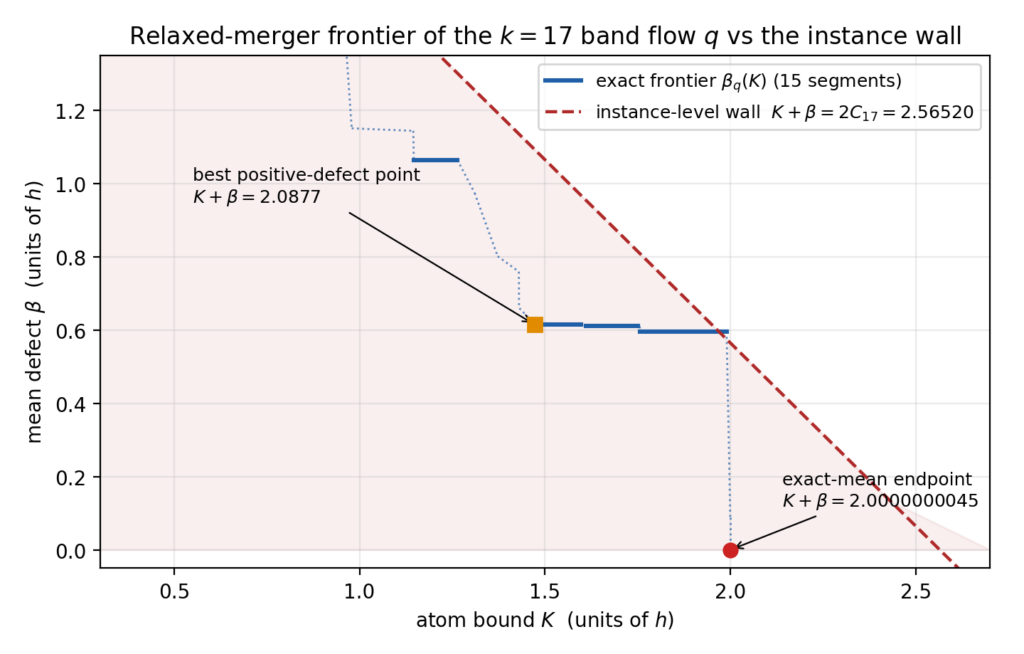
 :
 , если терминал
 ), и
 , если по другому (“раннему”,
 ). Дробный поток превращается в набор долей
 : с какой “вероятностью” терминал
 : положим
 , если дуга
 лежит только на позднем пути терминала
 , если только на раннем, и
 , если она лежит на обоих или ни на одном. Смысл этой матрицы в том, что ошибка любой маршрутизации на любой дуге записывается одной формулой:
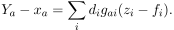
 стоят напротив интервалов, которые её накрывают. Переключение такого терминала на поздний путь добавляет на этой дуге
 , позднего — одинокая
 (это и даёт точное среднее), а ошибки всех строк на всех атомах не превосходят
 . Интуитивно чем меньше арности строк, тем легче; строки арности 1 тривиальны: их ошибка
 никогда не превосходит
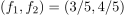 и две строки со знаками
 и
 . У первой строки состояние
 имеет ошибку
 , так что радиус
 требует
 ; у второй за ящик вылезает состояние
 с ошибкой
 , то есть нужно ещё и
 . Вместе с маргиналами это несовместно: обозначив
 , получаем
 и
 , и первое условие требует
 , а второе —
 . Лучший достижимый радиус здесь
 произведение знаков
 одинаково на всех дугах, где оба сомножителя ненулевые. Доказательство — симпатичная графовая склейка, которую я здесь не буду объяснять в деталях:
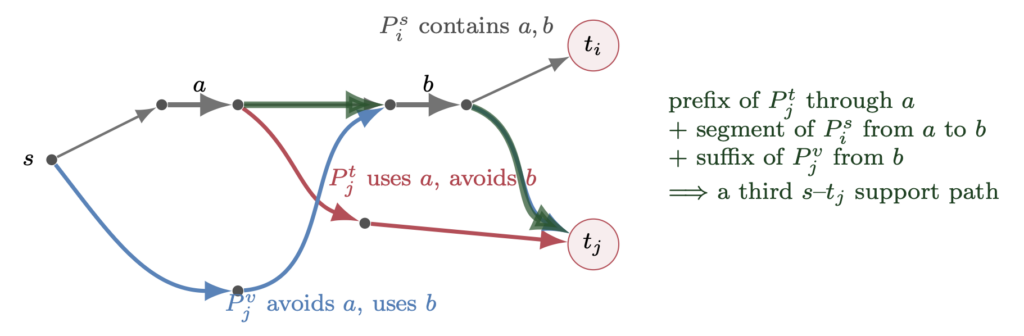
 , в котором каждый терминал
 между двумя листьями, а каждая строка матрицы разностей — ребром
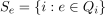 . При этом взгляде мы забываем знаки и величины и смотрим лишь на носители строк; к этому гиперграфу мы вернёмся в следующем разделе.
 , произведение всех их знаков обязано равняться
 , иначе нашёлся бы минор с определителем
 . Цикл из примера выше и всюду положительный 5-цикл это правило нарушают.
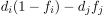 и по модулю не превосходит
 (сверху) или угол
 .
 ; ошибки в состояниях
 равны
 ,
 ,
 , и плох только угол
 , — дробная точка ему удовлетворяет, и хорошие вершины дают готовую смесь с точным средним:
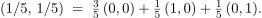
 раскладывается в выпуклую комбинацию его булевых вершин, и каждая такая вершина обходит все запрещённые углы всех строк сразу. Итого получается теорема.
 . Меньше единицы не бывает уже на одном терминале: если доля одного из путей стремится к нулю, любая смесь с точным средним обязана давать этому пути его положительную массу, и перегрузка соответствующего атома стремится к
 ,
 , дающие строки
 ,
 ,
 :
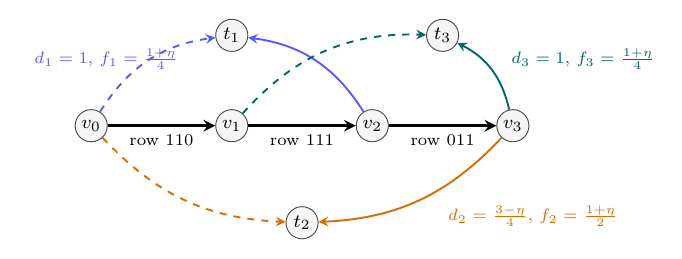
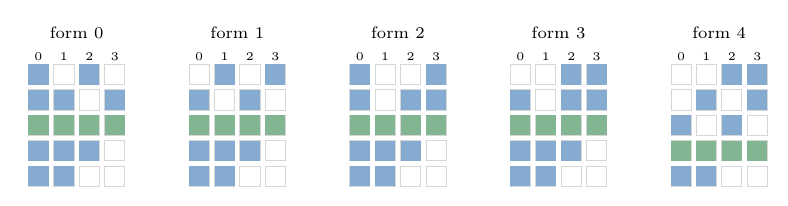
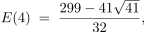
 — самое тяжёлое место статьи: 2015 граничных клеток, закрытых вручную выписанными покрытиями, проекциями и одним аргументом типа Хелли, без численных переборов (численный поиск использовался только чтобы найти граничные клетки, ни одно его решение в доказательство не входит).
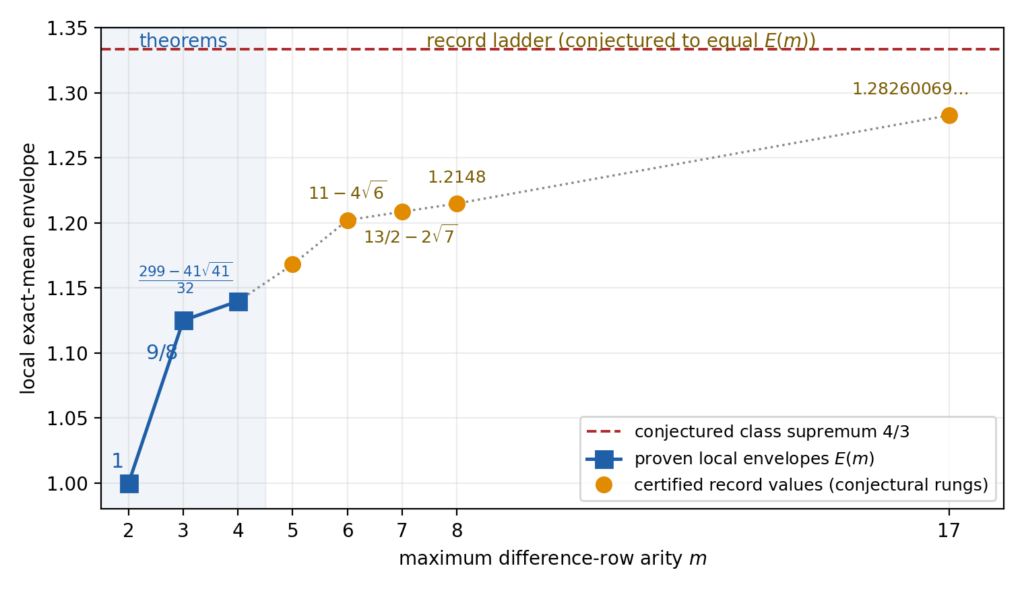
 ,
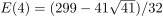 . Оранжевые кружки — рекорды из Части II, которые мы теперь считаем гипотетическими следующими ступенями той же лестницы. Пунктир — гипотеза Части II о супремуме
 для этого класса. Первые две нетривиальные ступени лестницы совпали с константами контрпримеров: нижние оценки Частей I–II, найденные задолго до всей этой теории, оказались точными значениями экстремальных задач, о существовании которых мы тогда не подозревали. По-моему, это крутой сюжетный поворот.
 бесплатны (один
 достаточно раскрасить терминалы в два цвета так, чтобы ни одна тройная строка не стала одноцветной: внутри каждого цвета арность упадёт до двух, каждый цвет заплатит один
 . Здесь мы пользуемся нашим свойством композиции, складывая радиусы частей графа.
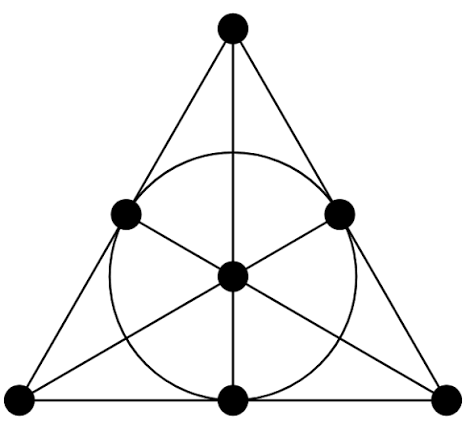
 на ребро можно правильно раскрасить в
 цветов (это теорема Притчарда — Ротвосса, в основании которой лежит теорема Шеннона о рёберной раскраске мультиграфов). Для
 берём четыре цвета и сливаем их в два блока
 и
 : три пути на одном ребре имеют три разных цвета, значит, ни одна тройка не окажется в одном блоке. Итого:
 . Это, опять же, глобальная оценка для класса графов с некоторым ограниченным локальным свойством; кажется, что это естественное свойство в данном случае. Но всё-таки нельзя забывать, что во всём “геометрическом” подходе речь шла исключительно про двухпутевые графы.
 (всё тривиально маршрутизируется);
 , это известный результат; а мы ещё подпёрли его нижней границей
 , которую получили из классического семейства “m+1 работ”;
 (
 маршрутизаций, точной смесью из семи атомов и сертификатом планарности через систему вращений:
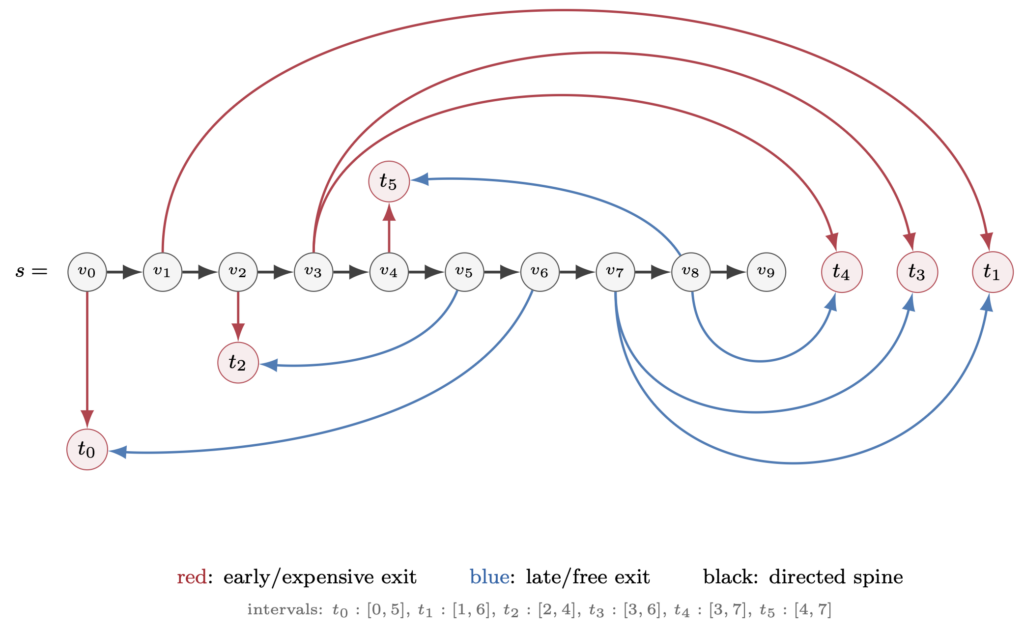
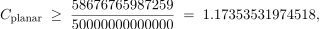
 , которое при внимательном взгляде оказалось одним и тем же неравенством, записанным дважды; красивое “следствие” про нечётные дыры, опровергнутое затем теоремой о сетевых матрицах; целое доказательство через округление вверх, и много чего другого.
 .
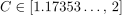 , и обе границы выглядят улучшаемыми.
 и дальше: совпадут ли следующие ступени лестницы рекордов с точными локальными константами, как это случилось с
 и
 : вершины — перекрёстки или маршрутизаторы, дуги — дороги или каналы связи. У нас есть один общий источник
 : больше этого количества груза одновременно по ней отправлять нельзя. Может быть и неотрицательная цена
 поглощает ровно
 из
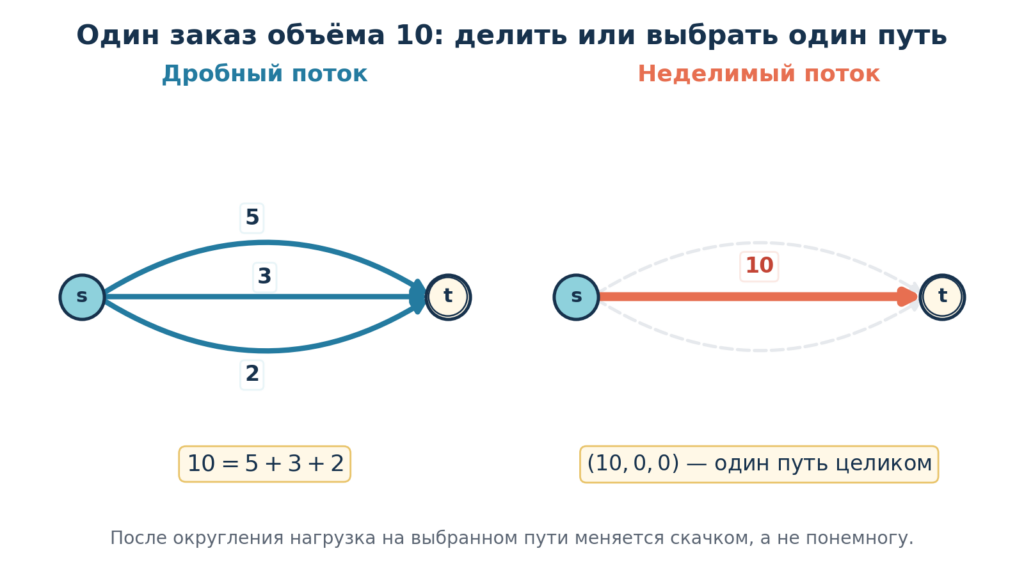
 , нагрузка на неё равна

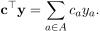


 , то, следовательно,

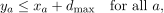

 , а средняя стоимость — ровно
 .
 .
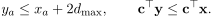
 в общих графах, назывался “широко открытым”, а его решение — потенциальным прорывом. Я нашёл только один (совсем недавний, 29 июня 2026!) результат
 по каждой дуге и не испортить одну глобальную цену.
 — цена одной единицы; у непомеченных цен значение нулевое. Двойными кружками отмечены терминалы.
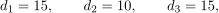
 .
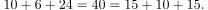
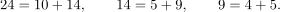
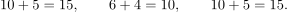
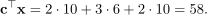
 и бесплатный
 :
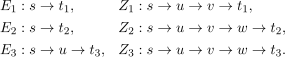
 тоже проходит по бесплатной дуге
 , но платит на дуге
 .
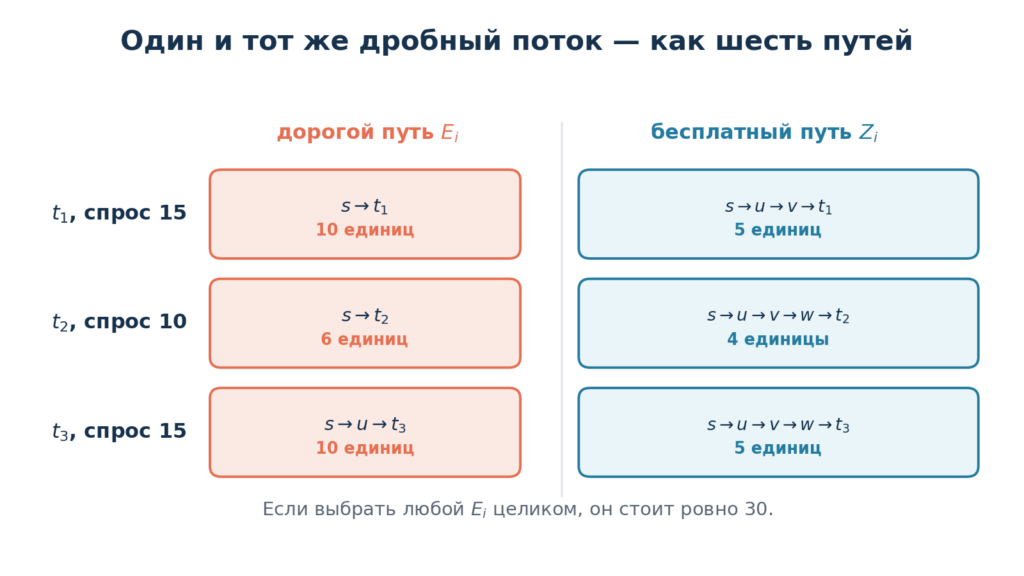
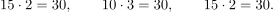
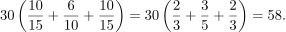
 вариантов. И 58 превращается в 60 из-за трёх арифметических конфликтов.
 и
 . Если второй и третий грузы одновременно идут по бесплатным путям, на дугу
 ложится

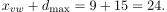
 и


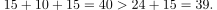

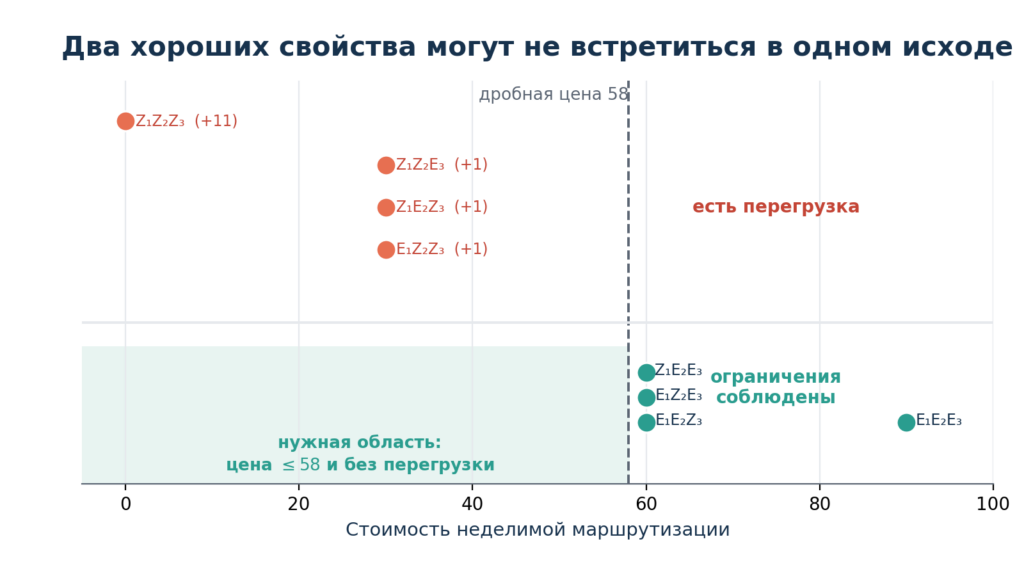
 , полный граф на четырёх вершинах. Это тоже по-своему интересно, потому что по планарности могла бы проходить граница между верным и неверным утверждением, и Рыбин изначально просил найти контрпример для общего, непланарного случая, но GPT 5.6 в итоге нашёл и более сильный.
 , а не
 , равную 1, если терминал
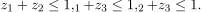
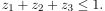
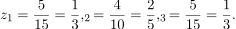
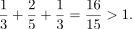
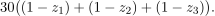
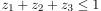 — не меньше 60.
 уже полностью описывает выпуклую оболочку допустимых точек. Первое недостающее ограничение возникает именно на треугольнике, то есть нужны три бесплатных варианта. Я не утверждаю, что семь вершин абсолютно минимальны среди всех мыслимых контрпримеров (для этого нужен отдельный перебор топологий, и его ещё никто вроде бы не сделал), но структурное ядро здесь действительно самое маленькое возможное.
 , так что
 ;
 единицы;
 .
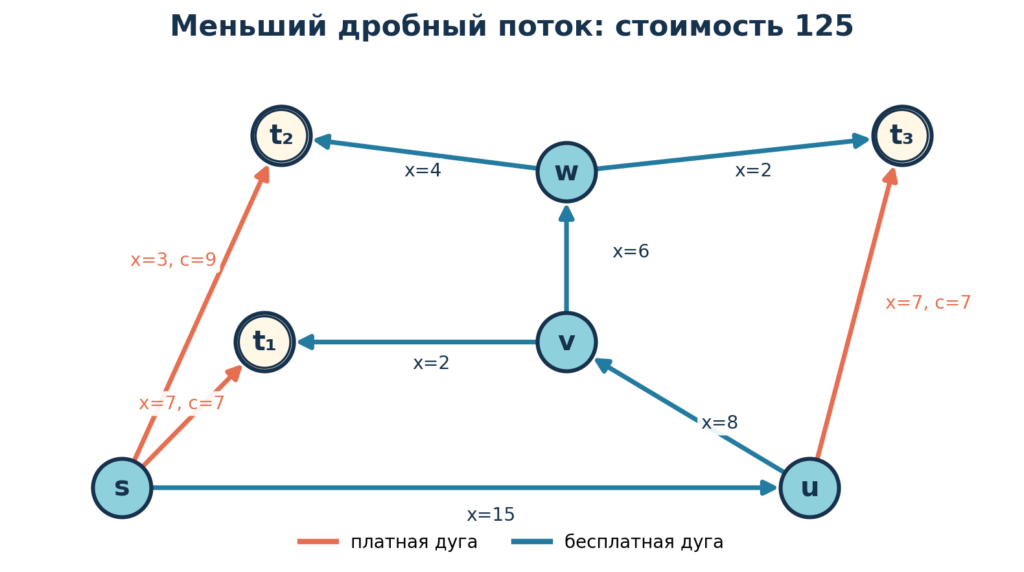
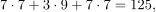

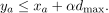


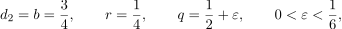
 — доли трёх грузов на бесплатных путях. Их суммарная дробная масса равна
 . Если каждый дорогой путь целиком стоит
 , поэтому сохраняющая стоимость маршрутизация обязана выбрать хотя бы два бесплатных пути. В то же время любой такой выбор требует коэффициента

 сколь угодно малым, получаем контрпример для любого универсального коэффициента
 .
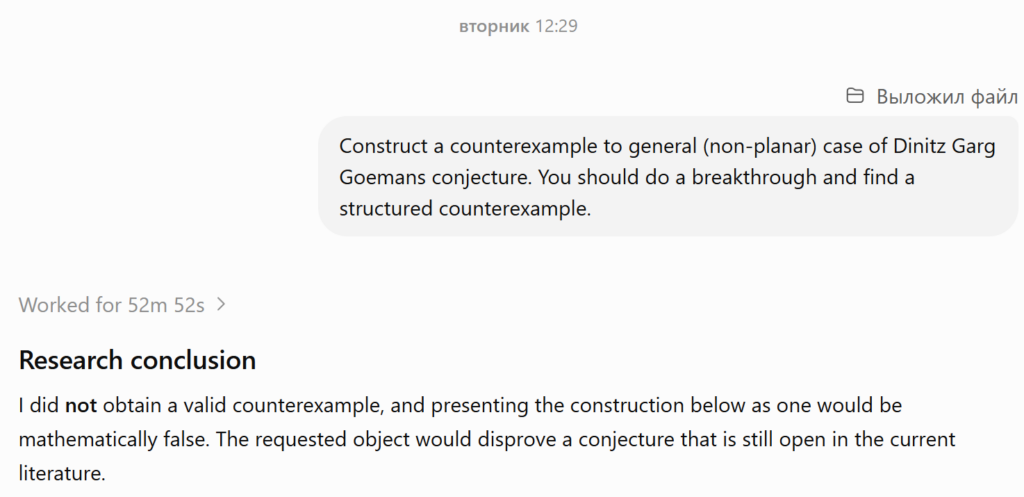
 , хотя целиком можно выбрать не больше одного. Цены лишь переводят недостающее неравенство
 , то есть теперь можно сокращать расстояние между
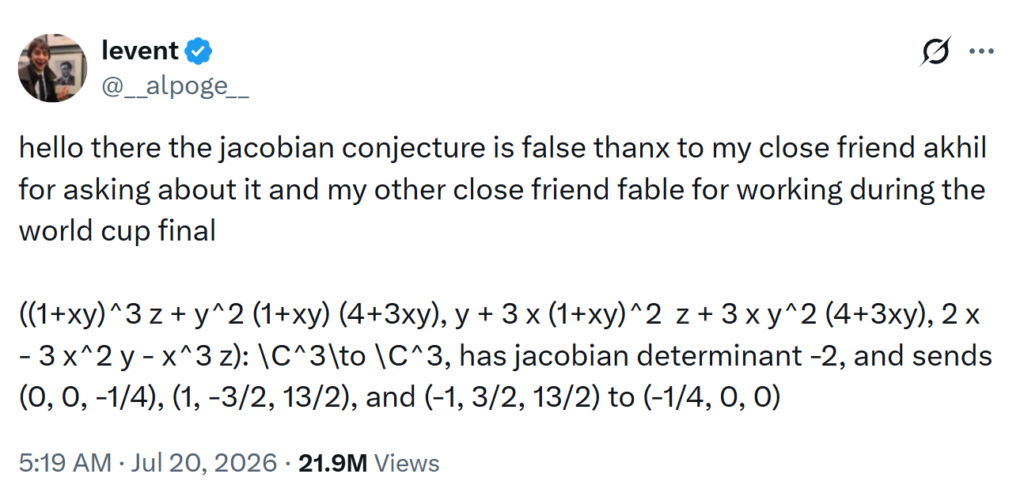
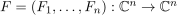 — полиномиальное отображение: каждая компонента
 — многочлен от
 . Его якобиан — определитель матрицы частных производных
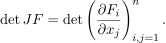
 обратимо, причём обратное отображение тоже полиномиально, то по формуле дифференцирования композиции
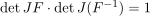 , то есть якобиан
 — многочлен, обратимый в кольце многочленов, а значит, ненулевая константа. Гипотеза о якобиане утверждает, что верно и обратное:
 — тут якобиан равен 1, а обратное выписывается сразу как
 .
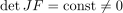 означает, что
 означает, что
 автоматически сюръективно. Более того, его обратное обязательно будет полиномиальным; это называется
 над
 производная равна 1, но оно склеивает в ноль всё простое подполе. Так что это вопрос исключительно про характеристику 0 (вещественные числа, комплексные числа), и у гипотезы не может быть никакого доказательства “грубой алгебраической силой”.
 и степени до 100 включительно.
 , где
 с линейными
 .
 , у которого якобиан не обращается в ноль нигде, но которое не инъективно. У Пинчука якобиан не был константой (он всюду положителен, но принимает сколь угодно малые значения), так что комплексную гипотезу это не опровергало. Но при этом стало окончательно ясно, что “локальная обратимость всюду” глобальную не гарантирует, и закрылись многие возможные пути для доказательства гипотезы.
 (
 (
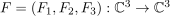 задаётся формулами
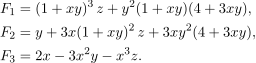
 тождественно (константа!), но при этом
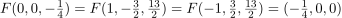 .
 вместо
 говорит, что других прообразов у точки
 нет: слой состоит ровно из этих трёх точек, и в твите приведён он целиком.
 с якобианом
 даже символьно несложно. Но самое интересное здесь, конечно, не сама проверка, а то, почему и как это работает. Не претендую здесь ни на какую экспертность, но давайте немножко обсудим.
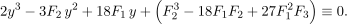
 алгебраична степени 3 (является корнем кубического многочлена) над образом: если
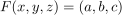 , то
 находится из первого уравнения (оно линейно по
 при
 — это в точности корни кубики
 (кроме тех, где
 , там
 , то есть координата
 .
 , на которой собственно найденный контрпример. Кубика вырождается в
 , и при
 у неё три вещественных корня, дающих три прообраза:
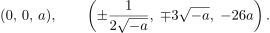
 получаются в точности три точки из твита. А если
 слева, то два боковых прообраза улетают на бесконечность вдоль гиперболы
 .
 они возвращаются из бесконечности уже комплексными, и вещественный прообраз остаётся один:
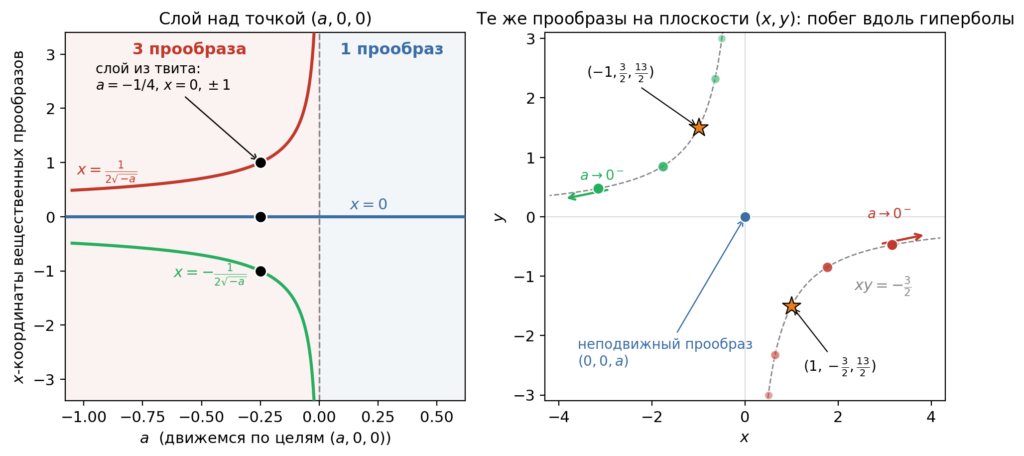
 : неподвижный прообраз в нуле и два убегающих по гиперболе.
 считаются явно, и оба, с точностью до множителей
 , пропорциональны одному и тому же многочлену
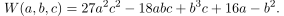
 .
 (вместе с плоскостью
 ) — это и есть стены: пересекая их, цель теряет или приобретает пару вещественных прообразов. Вот так это выглядит в проекциях
 и
 :
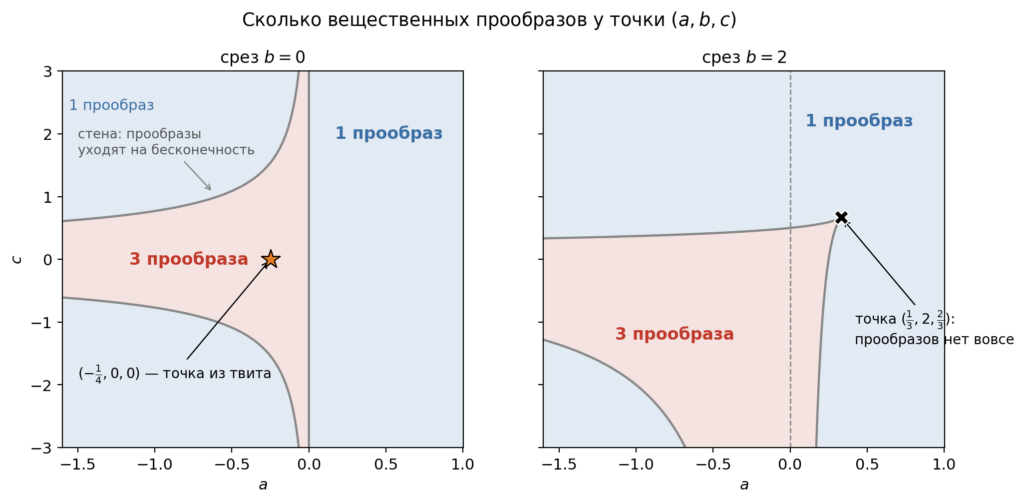
 прообразов нет вообще, ни вещественных, ни комплексных (базис Грёбнера соответствующего идеала равен
 ).
 ,
 , на которой все три корня кубики одновременно налетают на двойной корень
 — на картинке крестик находится в точности на острие стены.
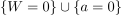 называется
 : достаточно приписать тождественные координаты,
 . Двумерный случай — исходный вопрос Келлера — остаётся открытым, и все положительные результаты (начиная с Moh, 1983), конечно, тоже всё ещё верны. Не исключено, что в размерности 2 гипотеза верна, и было бы даже красиво, если бы было так.
 следует гипотеза о якобиане в размерности
 есть эндоморфизм, не являющийся автоморфизмом (его можно попробовать выписать по нашему
 и
 — то есть в том числе для исходного вопроса Диксмье 1968 года — всё по-прежнему открыто, и аналогично обстоит дело с пуассоновской версией. А гипотеза Матье, из которой следовала гипотеза о якобиане, теперь опровергнута как общее утверждение.
 представлен вектором
 (для больших моделей
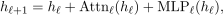
 превращается в логиты распределения над словарём:
 — матрица “разэмбеддинга” (unembedding), по строке на каждый токен словаря. Вектор
 и называют остаточным потоком (residual stream); это общая “шина данных”, через которую слои общаются друг с другом, и именно в ней живут все признаки, цепи и прочая интерпретируемость.
 , то есть сделаем вид, что оставшихся слоёв нет. На поздних слоях это отлично работает (модель уже почти сформировала ответ), но чем раньше слой, тем хуже: промежуточные представления вовсе не обязаны лежать в том же базисе, что финальные.
 , минимизируя расхождение
 с настоящим финальным распределением модели. Работает лучше, но у него есть концептуальный изъян, который в статье Anthropic как раз обсуждается: tuned lens забегает вперёд, потому что его обучают предсказывать выход, и он выучивается в том числе доделывать за модель ещё не сделанные вычисления. Такая линза отвечает на вопрос “что модель в итоге скажет”, а нам скорее интересно “что в активациях написано сейчас”.
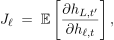
 и по последующим позициям
 . Получается одна матрица
 на слой, которая представляет собой некий усреднённый линейный портрет всего, что остаток сети делает с этим слоем.
 (часть B на картинке):
 по строке на каждый токен словаря
 — это J-вектор токена
 измеряет, насколько сильно текущее состояние в среднем толкает модель к тому, чтобы в итоге сказать
 ; разложение конкретной активации ищется жадным алгоритмом (gradient pursuit).
 . Многие читатели решили, что Anthropic нашла в остаточном потоке выделенное линейное подпространство, — нет, структура другая (и, по мнению Бушнака, называть её “space” было не очень корректно). J-векторов больше, чем измерений, — это переполненный словарь направлений в духе суперпозиции, просто полученный не обучением SAE, а из самой модели и почти бесплатно.
 , усиливая концепт
 , менять местами координаты двух концептов
 и возвращаться обратно,
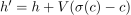 .
 , одно и то же на всех позициях (broadcast), и рассмотрим
 — сумму финальных состояний по всем позициям. Тогда
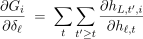
 зануляются каузальной маской автоматически).
 даёт
 ) занимает около получаса на одной A100; для 7B (
 ) — несколько часов.
 . Видим ту самую картину “латентного рассуждения в середине сети”, о которой и пишет Anthropic.
 до 0.67 на слое 23) и китайского ‘巴黎’ (“Париж” по-китайски, до 0.39)! Русское слово “Париж” становится топ-1 только на самом последнем слое. То есть модель “думает” на своих внутренних доминантных языках (у Qwen это английский с китайским), а перевод на язык собеседника происходит уже в моторной зоне, при конвертации мысли в токены.
 :
 )
 )
 )
 )
 )
 падает с 0.48 до 0.006): направления европейских стран в остаточном потоке сильно коррелируют, и грубая проекция цепляет заодно и Германию.
 –
 вмешательство становится слишком сильным, и связность текста рушится.
 : континент Europe (
 ) → Asia (
 ), валюта euro → yuan (
 ), столица → Beijing. А Германия (наша “контрольная группа”) теперь держится: Berlin остаётся топ-ответом при
 от 1 до 4 при
 .
 на промпте про валюту модель съезжает в жанр китайской школьной задачки — “yuan. Xiao Ming’s father exchanged…” (Сяо Мин — это, видимо, какой-то китайский Вовочка из школьных учебников). Целый культурный пласт показался.
 — это набор циклов (возможно, с повторениями), в котором каждое ребро графа встречается суммарно ровно два раза.
 :
 .
 на каждом ребре. Чтобы перевернуть стрелочку на ребре, достаточно заменить
 на
 , поэтому существование нигде не нулевого потока от выбора стрелочек не зависит.
 (и является многочленом от
 , это тоже эквивалентная формулировка). На практике это развязывает руки: группу можно выбирать поудобнее.
 , поток на ребре — разность цветов слева и справа).
 — это чётные подграфы. Теперь выберем группу поудобнее. Пусть
 — векторы из трёх бит со сложением по модулю 2 (XOR); их восемь: от
 до
 , так что стрелочки вообще не нужны: условие Кирхгофа в вершине просто говорит, что XOR значений на инцидентных рёбрах равен нулю.
 особенно нагляден: нигде не нулевой
 -поток — это то же самое, что рёберная 3-раскраска. Ненулевых значений три:
 ,
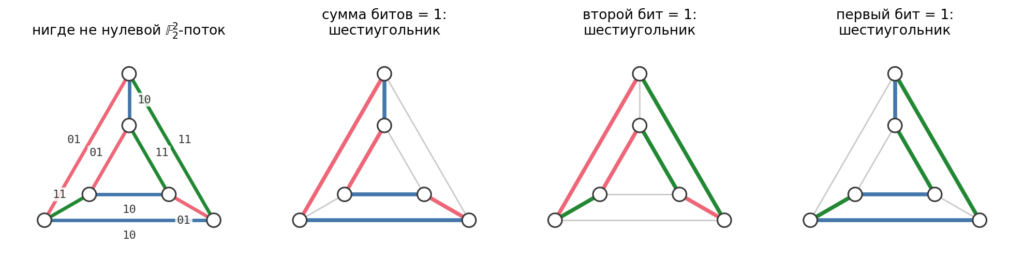
 ?
 (способов “свернуть” три бита в один: первый бит, второй, XOR первого и третьего и так далее), и каждый из них даёт чётный подграф
 .
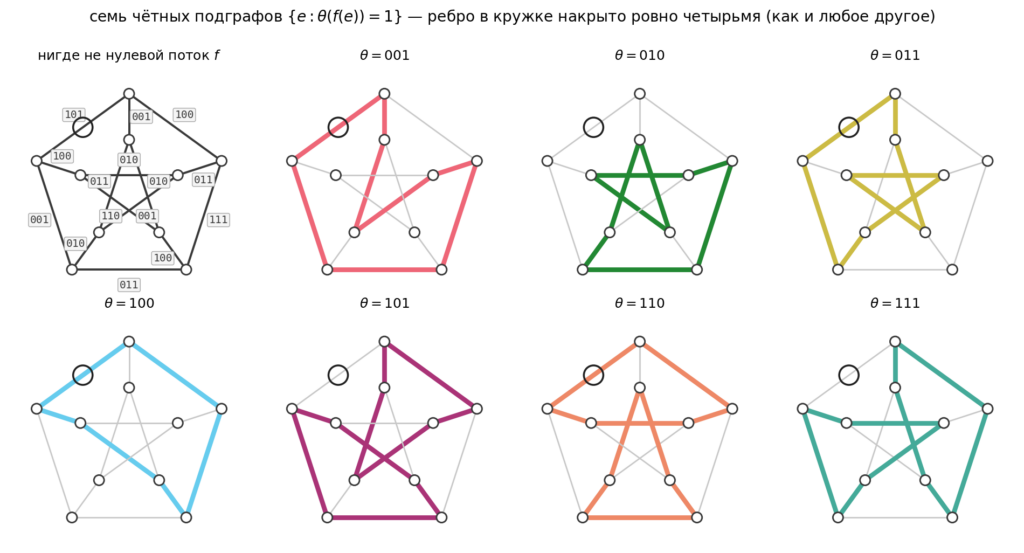
 : оно выделено ровно в четырёх панелях, при
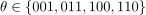 — ровно для тех
 . И так с каждым ребром.
 из двух различных цветов; цвета по-прежнему являются элементами
 встречается в парах инцидентных рёбер 0 или 2 раза.
 и
 из его пары. Тогда условие говорит, что в каждой вершине нитку любого цвета можно “пропустить насквозь”: цвет либо вообще не заходит в вершину, либо заходит по одному ребру и выходит по другому. А нитка, которая нигде не обрывается, обязана замыкаться в циклы:
 из всех рёбер, у которых в паре найдётся
 два элемента. Теперь соберём циклы всех восьми подграфов вместе, и готово: каждое ребро покрыто дважды.

 и выдадим красным рёбрам пару
 , синим —
 , зелёным —
 . Вокруг каждой вершины (где по одному ребру каждого цвета) элемент
 встречается дважды (красное и синее ребро),
 дважды (красное и зелёное),
 дважды (синее и зелёное).
 . У неё три ребра; обозначим их
 (порядок выберем произвольно и зафиксируем), а значения потока на них обозначим через
 ,
 ,
 .
 , то есть

 , то мы бы получили
 . Кстати, отсюда же видно, что множество
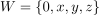 замкнуто относительно сложения, то есть это двумерное подпространство в
 — “базовый цвет” вершины
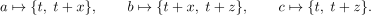
 — в парах
 — в парах
 и оба ненулевые), так что всё честно: вокруг
 — по одному на каждую пару (вершина, инцидентное ребро):
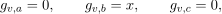
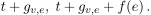
 ; для
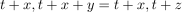 ; для
 . То есть пара ребра — это “базовый цвет вершины, сдвинутый на
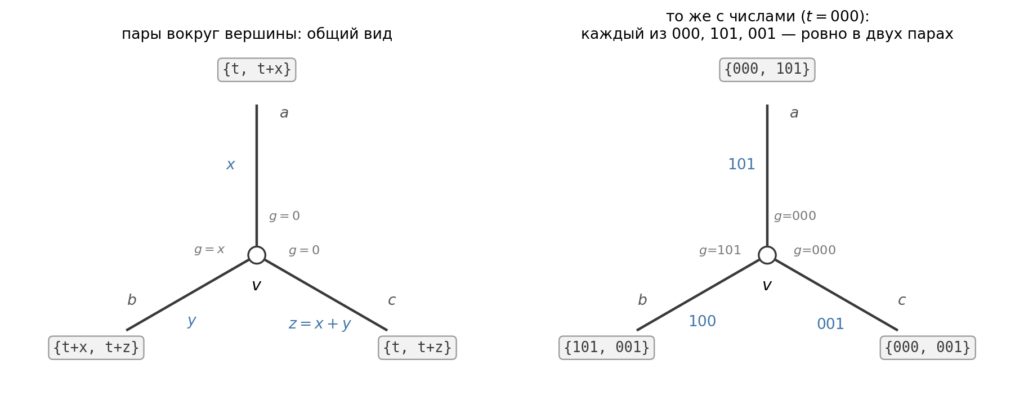
 . Это богатое семейство потенциальных раскрасок: в каждой вершине 8 вариантов
 , плюс ещё свобода в выборе порядка рёбер
 , который определяет сдвиги
 два конца! Вершина
 предлагает ему пару
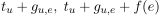 , вершина
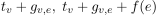 . Чтобы расстановка пар была определена корректно, эти две пары должны совпасть на каждом ребре графа одновременно:
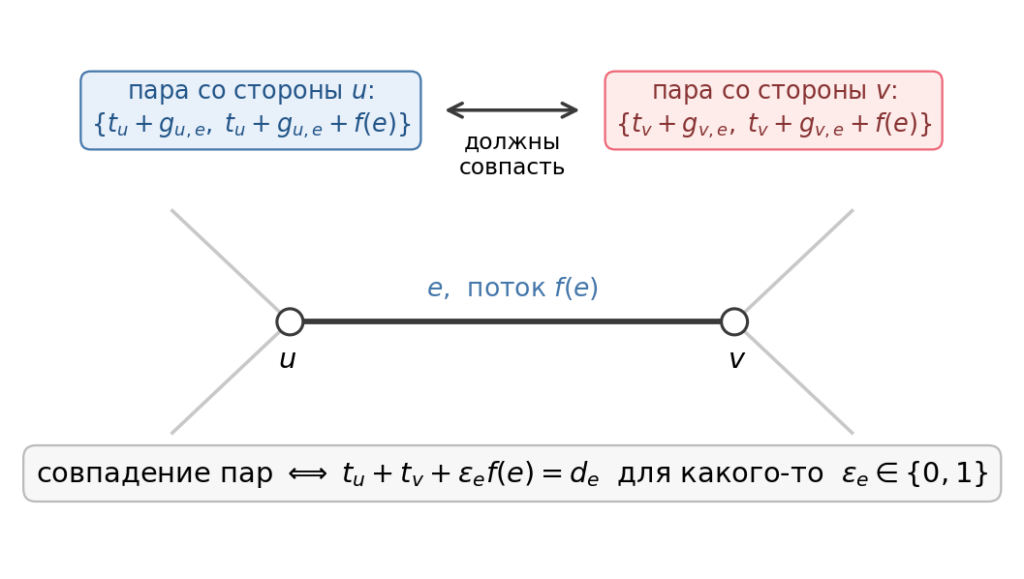
 и
 с одинаковым “шагом”
 .
 , либо
 (тогда множества совпадают “крест-накрест”); одной формулой это можно записать как
 .
 , получаем, что пары на ребре
 выполняется равенство
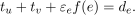
 — известные величины, они вычисляются по потоку
 (по биту на ребро) — неизвестные.
 , по три битовых уравнения на каждое ребро. Осталось доказать, что она всегда имеет решение.
 ,
 ,
 , поэтому по определению сдвигов
 , а два других сдвига в этой вершине нулевые; и так возле каждой вершины появляется ровно по одному ненулевому сдвигу. Невязка ребра — это XOR сдвигов с двух его концов: например, у ребра
 (сдвиг
 со стороны вершины
 со стороны вершины
 оба сдвига нулевые, и
 .
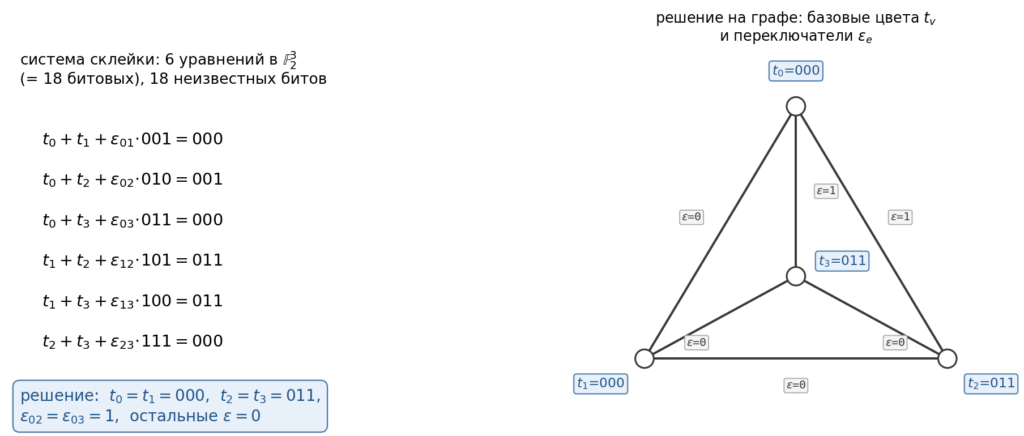
 — цвет
 и
 добавляет переключатель
 (это те рёбра, где пары с двух концов совпадают “крест-накрест”).
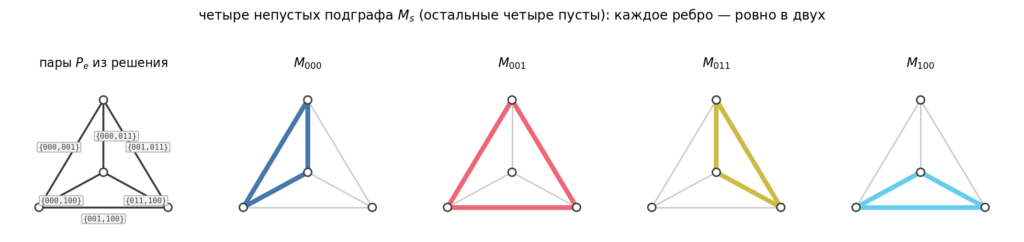
 битов, где
 . Для кубического графа
 , поэтому
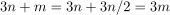 : система квадратная! Но радоваться рано, потому что она очевидно вырожденная; например, прибавить ко всем
 .
 левые части” не сюръективно, и не всякая правая часть достижима.
 (где
 — вектор из всех наших неизвестных) неразрешима? Когда из уравнений выводится противоречие: можно так скомбинировать уравнения (над
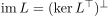 ) говорит, что это единственная возможная причина неразрешимости:
 всякая комбинация уравнений, зануляющая левую часть, зануляет и правую.
 .
 , по одной на ребро (в том числе здесь может быть тождественно нулевая функция, которая значит “уравнения этого ребра не берём”).
 (как функция) для каждой вершины
 для каждого ребра
 , удовлетворяющий этим двум условиям, препятствием. По альтернативе Фредгольма лемма 2 сводится к следующему: для всякого препятствия

 и посмотрим, что условия препятствия говорят локально. Во-первых,
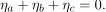
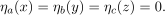
 и вычислим:
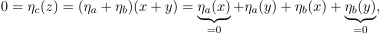
 ; обозначим это значение через
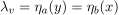 .
 . Мы ведь знаем, что
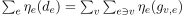 — это просто перегруппировка слагаемых по концам рёбер (здесь используется, что петель нет: у каждого ребра два разных конца).
 ,
 , так что
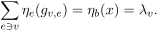
 . Проверим оба случая.
 . Тогда
 зануляется и на
 ), то есть зануляется на всём подпространстве
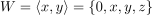 — помните, я обещал, что мы его ещё встретим?
 зануляется на
 (на
 тогда тоже.
 , и функционалы, зануляющиеся на нём, образуют одномерное пространство: нулевой и ровно один ненулевой; назовём его
 . Выпишем значения функционалов на базисе
 , у
 , у
 . Все три ненулевые (что бы функционалы ни делали на третьей координате). Ненулевых три, чётность 1, то есть опять всё сходится.
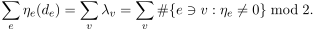
 посчитано ровно два раза — по разу на каждом конце! Это тот же самый двойной подсчёт, которым первокурсникам доказывают “лемму о рукопожатиях” о том, что сумма степеней вершин в графе чётна.
 , граф Титце, граф Петерсена с раздутыми в треугольники вершинами (это стандартный способ плодить нераскрашиваемые кубические графы) — проверили десятки случайных потоков на каждом;
 , призма, мультиграфы выше) снова запустили полный перебор всех нигде не нулевых потоков;
 ; слева его покрытие, а справа уже совершенно нечитаемый случайный кубический граф:
 13000 в зависимости от предположений о железе. Согласитесь, что за решение полувековой важной проблемы это в любом случае недорого.
 (
 — расстояние между их вложениями; тогда
 : совместимым конфигурациям
 должна быть присвоена низкая энергия, а несовместимым — высокая. При этом здесь уже под “конфигурацией” не обязательно понимаются похожие объекты; речь может идти об объектах совсем разной природы, просто так или иначе соответствующих друг другу:
 — сумму по всем мыслимым конфигурациям, которую в высоких размерностях просто никак не подсчитать. Суть энергетических методов в том, чтобы как-то вылепить нужный ландшафт энергии, ни разу не притронувшись к
 .
 должны выбрать правильный позитивный пример
 . Формально это просто многоклассовая классификация. Вот картинка из статьи про аудио, но к любой модальности это будет применяться точно так же:
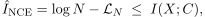
 — сама (неотрицательная) функция потерь. Поскольку
 , отсюда сразу получается, что
 , и это даёт нам одну из главных задач NCE. Если истинная взаимная информация между видами больше
 , граница упирается в потолок и перестаёт давать полезный сигнал на “лишнюю” информацию: сколько ни учись, оценка выше
 , то есть добавить больше негативов.
 байт — в десятки раз больше, чем весь текст, на котором обучают самые большие LLM. И на этом контенте ребёнок успел получить массу очень интересных интеллектуальных способностей; вот картинка, которую Лекун здесь часто показывает:


 может быть EMA-учителем, замороженным кодировщиком или тем же кодировщиком с регуляризацией. Есть только одна важная деталь, которая отличает JEPA от классической сиамской схемы: кодировщики не обязаны использовать одни и те же веса,
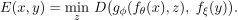
 несёт об
 несёт об
 (ViT), который обрабатывает только видимые контекстные патчи;
 , который получает контекстные токены плюс обучаемые mask-токены (несущие позицию целей) и предсказывает представления целевых патчей.
 -расстояние между предсказанными и целевыми представлениями по
 целевым блокам:
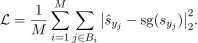
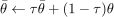
 стартует с 0.996 и линейно растёт к 1). Поскольку таргет отстаёт и получает стоп-градиент, тривиальное константное решение перестаёт быть неподвижной точкой.
 целевых блока со случайным масштабом в диапазоне
 площади и соотношением сторон в
 , а затем один большой контекстный блок с масштабом
 , из которого вырезаем пересечения с целями.
 -регрессия.
 предсказуемым из контекста
 , а значит, кодировщик вознаграждается за то, что сохраняет компоненты
 , случайный поиск не находил бы их никогда. А он находит.
 .
 , в которой одна или несколько других задач успели деградировать. Это и есть катастрофическое забывание.
 .
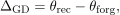
 .
 — линейная оболочка топ-
 собственных векторов матрицы ковариации градиентов сети, посчитанных в точке
 — линейная оболочка первых
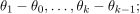
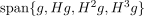 в точке
 ведёт себя линейно:
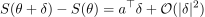
 . Посэмплируем
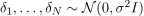 и выберем лучший сэмпл,
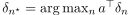 . Тогда верно следующее.
 — центрированный гауссиан с дисперсией
 , не зависящей от размерности
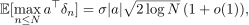
 (направление посторонней побочной задачи) у выбранного кандидата
 , а типичная величина
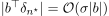 , и она не зависит от
 величина
 — центрированный гауссиан с
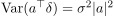 , что даёт пункт 1.
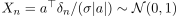 , и применяем классический результат из теории экстремальных значений:
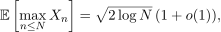
 являются совместно гауссовскими с ковариацией
 ; если
 , они независимы, и обусловливание на то, что мы их выбрали (а это событие зависит только от
 ), оставляет
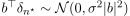 , что даёт пункт 3.
 , которая не сжимается с ростом
 , растущим с бюджетом. А третий пункт — это та самая асимметрия, ради которой всё затевалось: отбор по
 для размерностей
 ложится на одну и ту же кривую и похож на асимптоту
 ; во-вторых (справа), движение по ортогональному побочному направлению плоское по
 длины, и эти два эффекта сокращаются, оставляя
 независимым от
 размерности
 с
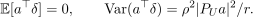
 : если добавить в
 не изменится — и сигнал упадёт. Доказательство здесь опять в одну строчку: для равномерного
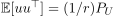 , откуда
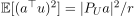 .
 . Подпространство ранга 32, целиком содержащее
 , и это хуже, чем у подпространства ранга 10, содержащего 77% от
 квадратична с постоянным гессианом
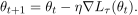
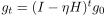 , и
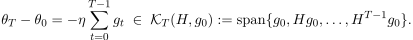
 ).
 по мере разворачивания траектории всё время подмешивают новые компоненты. Отсюда и главная мысль из названия статьи: recoverable (восстановимо, низкоразмерно) but not stationary (движется).
 и вообще ни с каким фиксированным направлением; а справа показано, как направление шага поворачивается по мере разворачивания траектории (сначала быстро, потом очень медленно):
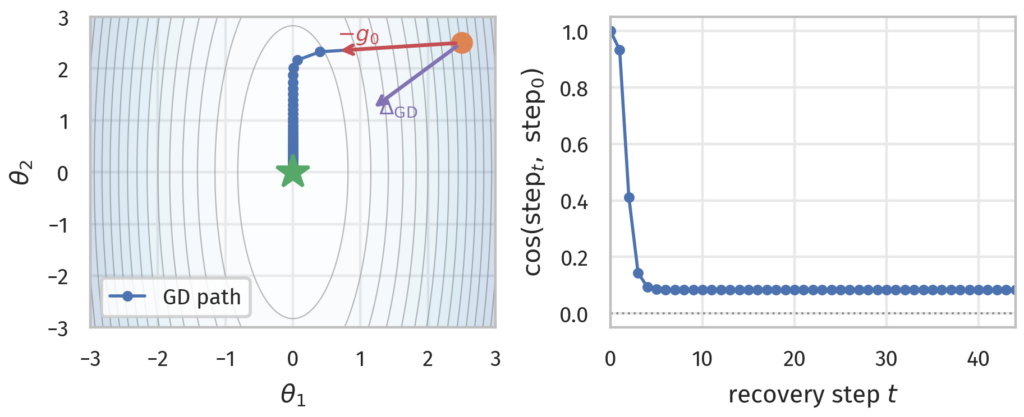
 , то активация каждого слоя сдвинется на
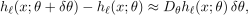
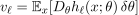
 при случайном их выборе. Это значит, что низкоразмерная структура отдельных задач реальна и вдобавок между задачами есть что-то содержательно неслучайно общее (но не так много, всего 0.11).
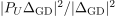 по подпространствам (среднее и разброс по 6 прогонам); справа предсказанная плотность
 (столбики) против наблюдаемого best-of-N выигрыша (точки), и видно, что они идут вместе:
 .
 раза, что предсказывает утверждение, а деление каждого выигрыша на
 делает порядок монотонным.
 ), а поиск иногда даже чуть обыгрывает один шаг градиента, находя более удачный масштаб вдоль примерно того же направления. Во-вторых, перекрытие кандидата со статичным локальным подпространством задачи успех не предсказывает, а скорее анти-коррелирует (
 ): из этого подпространства сигнал восстановления почти целиком убирает проекция.
 обучаемых параметров. А что будет на моделях с миллиардами параметров? Здесь мы честно задаём три вопроса, и так же честно отвечаем, в том числе там, где доказательств меньше, чем хотелось бы.
 может быть артефактом сэмплирования, а не свойством задачи.
 — антисимметричная (линейная) часть, а
 — симметричная (кривизна). Прогоняя масштаб
 , а выше кривизна берёт верх, и случайные ходы становятся разрушительными. И этот режим зависит от задачи: у BoolQ и HellaSwag есть здоровая полоса линейных и выпуклых направлений, а ARC-Easy на всех масштабах задавлена вогнутыми направлениями — это как раз случай, когда никакого предпочтительного направления нет и случайный поиск вырождается в шум.
 , который анализ
 пометил как линейный.
 шаг выходит из линейного режима, и согласованность рушится. А если впрыснуть градиентный сдвиг обратно в чистую модель, кривая отклика близко повторяет кривую CAA-вектора и поднимает точность примерно на 10 пунктов. Модель ведёт себя почти одинаково, пришёл ли steering-вектор из 80 размеченных контрастных пар или из одного шага градиента вообще без меток.
 , и, конечно, всё равно всё получилось.
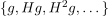 , ни “правильный” предобусловленный базис для Adam
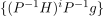 , ни даже “дрейфующий” базис с пересборкой оператора в каждой точке траектории не приближаются к префиксу.